アンケートCSVの読み方を3通り測ったら、1つは1割が黙って化けた
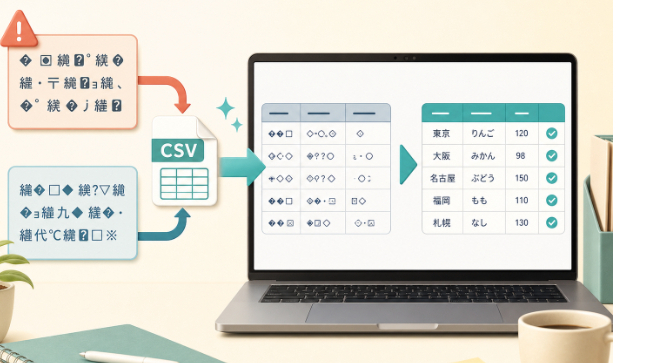
アンケートの自由記述を集めたCSVを、誰かに渡す。あるいは受け取る。開いてみたら、日本語のところが「縺ゅj縺後→縺・」のような記号の羅列になっている。一度は踏んだことのある方が多いと思います。私も預かったデータで何度も踏みました。この記事では「なぜ起きるか」よりも、気づかないまま集計まで進んでしまう場合があるほうを中心に書きます。画面が記号だらけになるのは、見た瞬間に分かるだけまだ親切です。実害が大きいのは、そうならない側です。先にひとつだけ。これはCSVで渡すときに限った話です。 Excelのファイル(.xlsx)のまま渡せば、文字コードの取り違えは起こりません。それでもCSVの話が無くならないのは、システムからの書き出しがCSVしか選べなかったり、相手からCSVで送られてきたりするからです。化けているのに、エラーが出ないことがある文字コードというのは、文字と番号の対応表のことです。日本語のファイルでよく使われる表は主に3つあります。UTF-8、Shift-JIS(Excelで保存したときの既定)、EUC-JP(古いシステムでよく使われた形式)。同じ番号の並びでも、どの表で読むかによって出てくる字が変わります。ここまでは、よく説明される話です。厄介なのはこの先で、違う表で読んでも「読めてしまう」ことがあるという点です。読む側のソフトはエラーを出しません。処理は成功で終わり、日本語が出てこないだけです。人が画面を見なければ、そのまま次の工程に進みます。どれくらい起きるのか、自分で測りました。1,129件を3つの形式で保存し直し、3,387通り読ませた手元のアンケートサンプル(1
0