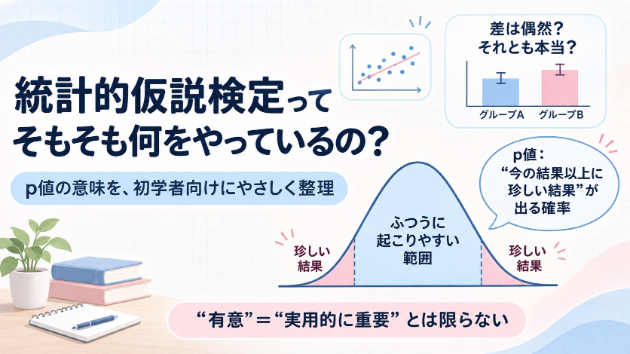
この前は以下の、そもそも統計的仮説検定とはなんなのかというブログを書かせてもらいました。
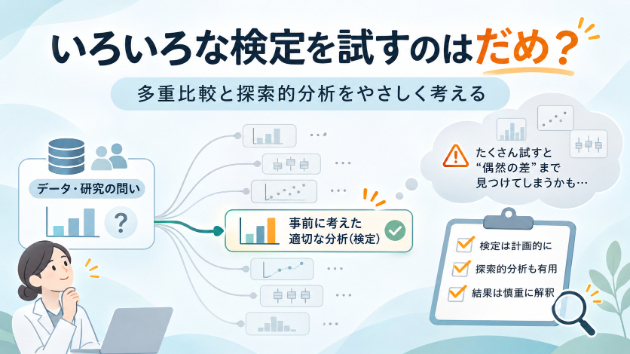
今回は、統計をちょっとだけ勉強したことがあったり、自分で試してみたりしたことのある人が聞いたことのあるかもしれない「1つの仮説に対して複数の統計的仮説検定を行う行為」の是非について書いてみようかと思います。
多くの統計の教科書や解説サイトで、1つの仮説に検定を繰り返すのはだめだよ、と書かれていますし、なぜそれがだめなのか、というのも書かれていることが多いです。ですが、意外と解説がわかりづらかったり、メイントピックとして取り上げられていなかったりすることもあるので、平易な言葉で説明を試みてみようかと思います。
おそらく企業や研究機関で統計的仮説検定を使っている人の中には、この行為に対して理解はあっても「現実的にやるしかない」という方もそれなりにいるかな、と思うので、実際に私がどのように対応しているか、というのも書いてみます。
・データを探索的に見るのが悪いというわけではない
さて、本題に入る前に、ちょっと前提となるお話をしたいと思います。我々が統計的仮説検定を使うときというのは、「なんらかの仮説を検証したいとき」です。統計的に言うなら、帰無仮説を棄却して対立仮説を採択したい、というモチベーションがある場合に統計的仮説検定を使用するわけですね。帰無仮説や対立仮説についてよくわからん、という方は上でリンクを乗せたブログも読んでもらえると嬉しいです。
ここで「仮説を検証したいとき」と言っているのは、細かく言うなら、データを集める前にそのデータについての何らかの仮説が存在しており、その仮説が正しいと言えそうなのか、あるいはそうではないのか、というのを統計的観点から確認したいとき、ですね。
ですが、すべてのデータの収集や測定が、上記のようなプロセスで行われるとは限りません。まずデータを取ってみて、そのデータを集計したり可視化したりすることで、そのデータについての仮説を考えてみたいとき、というのも存在しますよね。例えば新規サービスを立ち上げた場合など、実測されるデータを見てから売り上げに影響する要因を検討する、ということも多いと思います。
先ほど述べたように、統計的仮説検定は「仮説を検証する」ための手段なので、このように「新たな仮説を生成したい」という場合には、うまく適用することができません。「なぜうまく適用できないのか?」というのは、今回の話の本質にもかかわる部分なので、後述させてもらいたいと思います。
「1つの仮説に複数の統計的仮説検定を行うのはよくない」という話を聞くと、「データを探索的に見るのがよくない」というような誤解を招くことがあります。しかし実態としては、上記のようにそもそも統計的仮説検定とは仮説の検証に利用されるものであるため、それを仮説生成の文脈(=探索的な検討)に転用しようとしているのがよくないことが多い、という話であり、「統計的仮説検定を伴わない探索的検討」はなにも制限されていないわけですね。
補足しておくと、探索的な分析で統計的仮説検定を行うこと自体が悪いわけではありません。ただし、実際のデータを見ながら仮説や分析方法を選んだ場合、得られたp値を、あらかじめ仮説や分析方法を決めていた場合と同じように解釈することはできません。
そのため、探索的な分析で得られた結果は、あくまでも新たな仮説を考えるための手がかりとして扱い、必要に応じて別のデータで改めて検証する、という考え方が重要になります。つまり、探索的な検討に対する統計的仮説検定は、「絶対にやってはいけないこと」という積極的な主張というよりは、「やったとしても意味を見出しづらいこと」と考えると良いかもしれません。積極的にやるほどの価値はない、くらいのニュアンスですね。
・仮説検証ではなぜ複数の検定を用いてはならないのか?
今回の本題ですね。教科書的な説明を行うのであれば、「複数回の検定を行うことで、事前に設定した有意水準を超える第1種の過誤の確率となってしまうから」ですね。これでわかれば苦労はしません。
冒頭に示したリンクのブログでも解説しましたが、統計的仮説検定では「帰無仮説が正しいと仮に考えた時に、現在得られているデータと同じかそれ以上に極端な差が偶然によって得られる確率」を求めて、その確率が事前に決めた基準(有意水準)よりも小さいときに、統計的に有意であると結論します。
かみ砕いて言うと、偶然によってそれ以上の差が得られる確率が十分に小さいような珍しい現象であれば、その偶然が今回起こったと考えるよりも、実は比べているデータの間に差があったから発生している結果と考える方が妥当じゃない?という感じで推論しているわけですね。相変わらずわかりづらいですね。
上記のような統計的仮説検定の考え方で重要なのが、手元のデータの差かそれ以上の差が得られるのが「十分に小さい確率なら」というポイントです。これ、裏を返すと「十分に小さい確率だが偶然に起こりうる」と言っちゃってるわけですね。つまり、統計的仮説検定で「統計的に有意」であると判断されたとしても、その結果が「珍しい偶然」によって引き起こされた可能性は常に存在する、ということです。
この、「珍しい偶然を引き当てたことで偶然の差を統計的に有意な差と認識してしまった」という現象を、専門的にはここの冒頭で述べた「第1種の過誤」と呼んでいるのです。「統計的に有意って言ったけど間違えちゃった」となる確率のことですね。
さて、通常の統計的仮説検定では、第1種の過誤の可能性を完全になくすことはできません。少なくとも、差がある場合にそれを検出できるようにしようとすれば、差がないのに誤って有意と判断してしまう可能性が生じるわけです。ですが、統計的仮説検定が用いられる多くの文脈で、「本当は差がないのに差があると言ってしまった」という第1種の過誤は、「本当は差があるのに、それを統計的に検出できなかった」という逆のパターン(ちなみにこちらは第2種の過誤と呼ばれます)と比べて、大きな「害」を生みやすいです。
例えば、お薬の効果を測る文脈を考えてみましょう。薬には目的とする治療効果を与える主作用と、主作用ではない副次的な効果である副作用があります。痛み止めを飲んだ時に痛みが引くのが主作用、胃腸が荒れてしまったりするのが副作用ですね。お薬は、基本的に人体に害を与える副作用よりも、主作用の利益の方が大きいから用いられているわけです。「痛みは引くけど全身が動かなくなります」みたいな薬があってもだれも使わないですよね。
お薬の効果を調べるときには当然、統計的仮説検定も行われているわけですが、ここで第1種の過誤が起きるとどうでしょうか?本当は十分な治療効果がない薬を、有効であると誤って判断してしまうかもしれません。その結果、患者さんが効果を期待できない治療を受けたり、十分な利益がないまま副作用のリスクを負ったりする可能性があります。こうした事態を避けるために、統計的仮説検定では「第1種の過誤の確率を一定に保つ」、ということが非常に重要視されます。
ちょっと統計的仮説検定の背景にある理屈の話もすると、統計的仮説検定の理論では、許容する第1種の過誤の確率を設定したうえで、できるだけ第2種の過誤を小さくする、つまり真の効果を検出しやすくすることが重要な考え方となっています。そのくらい大事な原理原則なわけですね。
1つの仮説に対して複数の検定を試してはいけない、というのは、上記のように「第1種の過誤の確率を一定に保つ」という目的に反してしまうから、となります。統計的仮説検定は事前に設定した許容される第1種の過誤の確率(=有意水準)を基準として実施されますが、それはあくまでも「その検定の中での話」です。いくつもの検定を繰り返す、ということは、例えるのであればサイコロを何度も振りなおすような行為です。6面サイコロで6が出る確率が1/6であっても、何回も振ってしまえば1度でも6が出る確率は上がってしまいます。
さきほど、「探索的な検討には統計的仮説検定をうまく適用することができない」と言ったのも、探索的に検討するという行為がいくつもの検定を試すという行為と不可分であるため、第1種の過誤の確率を一定に保つことが難しいから、となります。このあたりはHARKingと呼ばれる行為とも関連するので、また別の機会に改めて詳しく書きたいと思います。
・多重比較を補正する方法はだめなのか
上記のような説明は初学者向けによく解説される内容なのですが、ある程度統計を学習すると表題のような疑問が浮かぶと思います。例えば分散分析では、3つ以上の群について平均値差が存在することを確認したのち、「どの群とどの群の間に差があるのか」をt検定で比較したりします。こうした場合には、「繰り返す検定の回数に応じて有意水準を調整する」という操作をすることで、事前に設定した有意水準を超過しないような調整が行われます。
そのようなやり方が「あり」であるなら、好きな数の検定を繰り返しても有意水準を調整すればよいのでは?と考えるのは自然です。これは一見すると正しいのですが、実はこの考え方にも落とし穴があります。
最初の落とし穴は、「1つの仮説に対して繰り返される検定は通常相互に独立ではない」という点です。ちょっと書き方が小難しいですが、簡単に言うなら取ったデータ自体は固定されるので「多くの検定で統計的に有意になりやすいデータ」と「多くの検定で統計的に有意になりづらいデータ」があるよ、ということですね。当たり前ですが、明瞭な差があるなら通常はどんな検定でも統計的に有意になりますし、ほとんど差がないのであればどのような検定でも統計的に有意にはなりづらいです。
統計的に有意になりづらいようなデータに対して、複数の検定を行い、その検定の回数分だけ有意水準を調整したらどうなるでしょうか?当たり前ですが、これは基本的に悪戯に有意水準を厳しくしているのとあまり変わりません。そして、「複数の検定を試したい」というモチベーションがある時点で「統計的に有意になりづらい」データである可能性が高いです。
有意水準を厳しくすると、「本当は差があるのに、それを統計的に検出できなかった」第2種の過誤の確率が上がります。つまり有意水準を調整する方法というのは、有意水準を調整する機能とトレードオフに、第2種の過誤の確率を上げる結果になりやすいです。
2つ目の落とし穴は、「有意水準を調整する方法に完璧な方法は存在しない」という点です。検定を繰り返しても第1種の過誤の確率を上げない最も単純かつ確実な方法は、検定を繰り返した回数で有意水準を割る、という操作です、例えば、5%の有意水準を設定して2回検定を繰り返したのであれば、1回ごとの検定の有意水準は2.5%にする、という考え方ですね。これは非常にわかりやすく強力なのですが、まさに上記で書いたように通常検定は相互に独立ではないため、この方法は調整後の有意水準を厳しくしすぎてしまう、という弱点があります。
このほかにも非常に多くの多重比較補正法が存在していますが、どのような状況にも適用でき、かつ検定力を最大限に維持できる万能な方法が存在するわけではありません。
例えば、例に示したような第1種の過誤を厳格に制御する方法では、検定間の関係によっては必要以上に厳しい判断基準となることがあります。一方で、多少の偽陽性を許容してでも、より多くの真の効果を発見することを重視する方法も存在します。
つまり、多重比較補正と一口に言っても、どのような誤りを、どの程度許容するかによって方法が異なります。検定力を重視すれば偽陽性のリスクとの兼ね合いを考える必要がありますし、偽陽性を厳しく抑えようとすれば検定力が低下する場合もあります。
どの方法を選ぶべきかは、研究の目的やデータの性質、そして誤った判断をすることでどのような問題が生じるかによって変わってくるわけですね。
以上のような落とし穴を踏まえたとしても、もちろん、多重比較補正そのものが悪いわけではありません。複数の検定を実施する必要がある場合に、第1種の過誤を適切に制御するための重要な手段となります。
ただし、どの検定をまとめて補正する必要があるのかは、研究の目的や検定結果をどのように解釈するのかによって異なります。また、多重比較補正によって検定力が低下する場合もあるため、必要以上に多くの検定を実施することが望ましいとは限りません。
特に、単一の適切な検定で十分に検証できる仮説に対して、むやみに複数の検定を実施する必要はないでしょう。
重要なのは、検定を何回実施したかということそのものではなく、研究目的に対して必要な分析をあらかじめ整理し、その目的を達成するために適切な方法を選択することだと思います。
・とは言え現実で要求されることはあるよね
誠実な統計をやろうとしても、様々な社会的要請によってその信念を守ることが難しい場面は多くあります。上司の指示で統計的な効果を示さなければならない、クライエントが施策の効果を期待している、統計的に有意でなければ論文に掲載されない、我々社会の中で生きる人間は、統計的な原理原則以外の様々な条件の中で生きています。
仮にそうした要請の中で統計的に不適切な行為を、そうとわかりつつしてしまった人がいたとしても、私はそれがその人の個人の責任に帰属するとは思えません。統計的な原理原則だけで明日のご飯が用意されるわけではないからです。
しかし、統計を生業とする人間として、無条件に社会的な要請に応えるだけではなく、専門家としての意地を見せつつ社会的な要請との折衷点を探りたい、という思いはあります。そうした中で私が心がけているのは、「統計的仮説検定を無理に勧めないこと」「データの可視化を大事にすること」です。
そもそも、身もふたもないですが「統計的仮説検定をしないとわからないような効果」は、現実場面で強い力を持つことは少ないです。非常に明瞭な効果であれば、わざわざ統計的な検定を加えなくとも、視覚的な描画で十分なことも多いです。それでも統計的仮説検定を求められるのは、報告の対象者(上司やクライエント)がさらに上のレイヤーに話を通すときに「わかりやすい」
説明ができるからであることが多いです。
「平均効果は○○で......これは売り上げのXX%に相当しますがばらつきは△△で......」と伝えるより、「この効果は統計的に有意でした」と伝えられる方が「わかりやすい」ですし、「説明側も楽」なわけですね。これは冒頭にリンクを貼ったブログにも書きましたが、「わかりやすい」ことは非常に大きなアドバンテージとなります。
しかし、やはり「わかりやすさ」は正しさとイコールではありません。統計の専門家としても、非専門家のクライエントに伝える際に「統計的に有意だった」という説明は非常に楽で、「効果があったんだね」というクライエント側の認識を即座に形成する手段となりえます。この「楽さ」から一歩踏み込んで、複雑な状態を複雑なままクライエントに理解してもらう、というのが統計の専門家に求められる態度なのかな、と私は思っています。
そして、「複雑な状態を複雑なまま」伝えるときに、「統計的に有意だったのかどうか」という情報はそこまで重要ではないことが多いです。特に探索的な検討の段階では、データを視覚化してそこから推論される仮説を提案すること、類似の(関連する)データの傾向を伝えること、などがクライエントの目的達成に大きく貢献することが多いです。
「それって結局効果あるの?」と聞かれたときに、「統計的に有意でした」以外の返しの手札を持つことが、統計の専門家には必要なのかなと思っています。
・最後に
散々書いておいてなんですが、やはり上記は綺麗ごとです。現実の社会の中で、いつでも自分の信念を貫けるとは限りませんし、「要請に屈する」ことが必ずしも糾弾されるべき悪徳であるとは思いません。
しかし、やはり上記で「複雑な情報を複雑なままに」と提言した通り、そうした社会的な要請を含めた複雑な状況の中で、快刀乱麻を断つような答えを求めるのではなく、文脈ごとに「最善ではなくとも最適な」行動を模索する姿勢を持っていきたいと思っています。
というのが私の統計についてのスタンスでもあったりします。上記までが私への信用を補完するのか棄損するのかはわかりませんが、もし信用に足る、と思ってくださった方がいれば下記の出品なども検討していただけると幸いです。