おそらく、高校受験や大学受験などの受験を潜り抜けてきた方は「偏差値」という言葉を嫌というほど目にしてきたことでしょう。私がSNSに毒されているだけかもしれませんが、大学生以降になっても「偏差値」という概念は人気のようで、最近では就職偏差値なんてものまであったりするようです。
しかしこの「偏差値」という概念、正確にどのような概念なのか、どのように解釈できるのか、というのを把握している人は、その使用者の多さと比べてかなり少ないのではないでしょうか。
今回は、そんなみんな知っているけど知らない、偏差値という概念を詳しく見ていこうと思います。前回以前のブログは下にリンクを貼っておくので、興味がある方は見てもらえると嬉しいです。
完全に遊びのやつも書いてます(以下)
・偏差値の背後にあるのは「標準化」
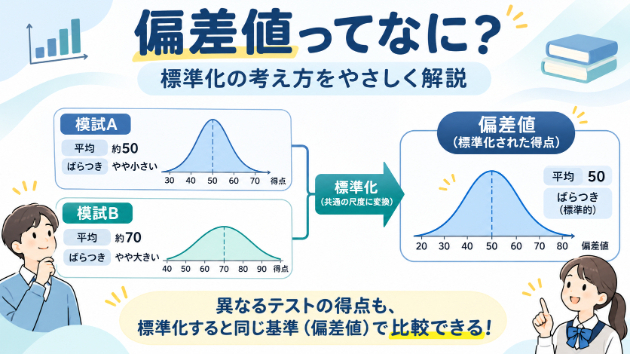
「偏差値」という言葉に聞きなじみがあっても、「標準化」という言葉に聞きなじみがある人は少ないのではないでしょうか。標準化とは、あるデータについてそのデータの平均やばらつきを一定の値に揃える操作を指す言葉です。偏差値とはこの標準化によって生み出される値の1つなのですが、いつものことながら、この説明だけでは実態がかなりわかりづらいと思います。
具体的に、テストの得点を比較するようなケースを考えてみましょう。同じ時期に、AとBの2つの模試を、同じ集団が受検したと考えてみます。模試Aの平均点が50点、平均的な得点のばらつきの程度(標準偏差と呼びます)が10点であるとします。模試Bは全体的に平均が高く、平均が70点で標準偏差が15点であったとします。
このときに、模試Aで65点を取った人と、模試Bで90点を取った人は、それぞれの模試を受けた集団の中で、どちらの方が相対的に高い成績であったと言えるでしょうか?こうした疑問に応えてくれるのが、標準化の考え方です。
最も基本的な標準化である、z得点を使って上記の例を考えてみます。z得点は、その得点から平均点を引いて、標準偏差で割ることで値を求めることができます。先ほどの例でいえば、模試Aで65点を取った人のz得点は、(65 - 50)/10となるので、1.5となります。模試Bで90点を取った人は、(90 - 70)/15となるので、1.333...ですね。
この操作によって、平均や標準偏差の異なる2つの模試の得点を、同じ尺度で考えることができるようになりました。今回の場合には、模試Aで65点を取る方が全体の中で相対的に高い点を取っていることがわかったわけですね。
偏差値は、上記で例示したz得点に10を掛けて50を足したものです。z得点が1.5であれば、偏差値は1.5×10+50となるので、65となりますね。同様にz得点が1.333...であれば偏差値は63.333...となるので、偏差値とz得点ではスケールが異なりますが、実態は全く一緒であることがわかります。
・標準化した値はなんでも比較できるわけではない
さて、上記のように、標準化という操作を用いることで平均や標準偏差の異なる値同士を比較することができるようになります。では、標準化されていればどのような値同士も比較することができるのでしょうか?実は、ここには気を付けなければいけないポイントがあります。
標準化した値を比較するときに注意が必要なのが、「比較したいデータの母集団は同一なのか」という点です。例えば、高校には高校の偏差値があり、大学には大学の偏差値がありますが、高校の偏差値と大学の偏差値は一般的にイコールではありません。多くの場合、偏差値50の高校から偏差値50の大学に進学するのは難易度が高いです。なぜ、同じ偏差値のはずなのにそのようなギャップが生まれるのでしょうか?
ここで必要な考え方が、「母集団」です。母集団とは、そのデータを生み出す対象全体を指す統計用語です。上記の例から考えると、高校の偏差値の母集団は高校受験をする人全体、大学の偏差値の母集団は大学受験をする人全体となります。
高校受験はいまやほとんどの人が経験するため、母集団としては同年代のほぼ全員ということになります。一方で、大学受験の受験率は伸びていますが、大学進学率は6割弱程度なので、多く見積もっても6割~7割程度の受験率であると考えられます。必ずしも成績上位の6割~7割が大学受験をしているとは限りませんが、それに近い状況と考えると、「大学受験は高校受験よりも平均的な学力の高い集団が受けている」と考えられますね。大学の偏差値で50というのは、「あくまでも大学受験をした人の中で平均的な学力であった」ということであり、「同世代の平均的な学力であった」というわけではないのです。
つまり、高校と大学は同じ「偏差値」という言葉で学力が語られますが、その母集団が異なるため高校受験の偏差値=大学受験の偏差値とはならないわけですね。
余談ですが、私の大学の講義で標準化の説明をした際に、「高校から大学で偏差値が落ちた、と両親に怒られた方がいたらこの話をしてみてください」と(冗談として)言ったところ、本当に怒られた経験のある方がいて驚きました。
上記のように、標準化した値、例えば偏差値同士を直接比較したい場合、そのデータの母集団が均質である必要があります。母集団が均質ではない場合でも、「それぞれの母集団を前提とする中でどちらの得点が相対的に高いか」という比較をすることはできるのですが、母集団の差を無視すると解釈を誤る可能性が高くなります。標準化は確かに便利な操作であるのですが、なんでも比較できるようになる万能の操作ではないわけですね。
・統計における標準化
上記で終わると豆知識レベルなので、一応もう少し統計らしい話もしておきます。標準化という操作は統計でもよく使われる操作で、それは「人間的にデータの比較がしやすくなって嬉しい」以上の意味があります。
例えば、以前のブログで、正規分布の中でも平均が0、分散が1の正規分布を標準正規分布と呼ぶ、という話をしました。実は、正規分布に従う確率変数について、その分布の平均と標準偏差を使って標準化すると、標準正規分布に従う確率変数へ変換することができます。つまり、平均や分散が異なるさまざまな正規分布を、共通の標準正規分布として考えられるわけですね。
z得点の操作を思い出してほしいのですが、すべてのデータから平均を引くと、そのデータ全体の平均は0になります。また、元の標準偏差で割るという操作をするので、変換後のデータ全体の平均的なばらつき(=標準偏差)は1になります。標準化によって、平均0、標準偏差1のデータを作ることができるわけですね。分散は標準偏差の2乗なので、このデータの分散は1です。元のデータの確率分布が正規分布である場合、標準正規分布の条件を満たしますね。
これのなにが良いのか、という話ですが、元の確率分布が正規分布なら「どのようなデータであっても」標準正規分布の形に変換できる、というのが良いポイントです。平均がいくつで標準偏差がいくつの時の統計的仮説検定は......のような際限のないことを考えずとも、標準正規分布で成立する統計的仮説検定を作ることができれば、それを正規分布に従うあらゆる確率変数に拡張することができるようになるわけです。
これはあくまでも一例で、標準化には統計的に様々なメリットの存在する操作です。興味のある方は、ぜひ統計の数理的な側面についても学んでみるとよいかと思います。
・最後に
今回は小ネタ的でしたが、一般的に知名度の高い「偏差値」という概念と、その背景にある「標準化」という操作について触れさせていただきました。「統計よくわからん」という人も、こうした身近な概念から興味を持ってもらえると嬉しいです。
宣伝もしておくと、統計の個人指導サービスや分析代行サービスを出品しておりますので、ご興味ある方は覗いてみてください。