ココナラってブログも書けるんですね。
せっかくなので初学者向けの統計記事を書いてみたいと思います。
初回のテーマとしては「統計的仮説検定」、おそらくこの記事を開いていただいた方は実際に使っている方や使おうとしている方が多いと思いますが、どんな理屈でなにを主張しているの?というのをざっくり解説したいと思います。
n番煎じではありますが、数式などは用いずに平易な言葉で統計の営みを記述する、というのを目標に書いていきます。
・統計的に有意ってなに?
やはり統計的仮説検定と言えば、「統計的に有意である」という言葉は外せません。なんならこの言葉だけ聞いたことがある、という人もかなりいるのではないでしょうか。
「有意」というのは文字通り「意味が有る」と書きますが、統計学でいう「有意」は、日常的な意味での「重要である」「価値がある」とは少し異なります。
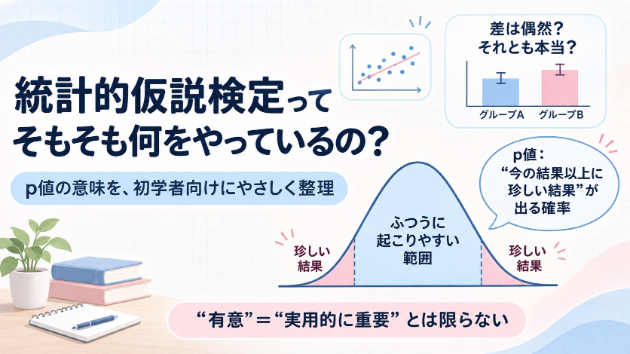
統計的に有意であるというのは、ざっくり言えば「事前に設定した仮定のもとでは、今回のデータは珍しい結果だと判断された」ということです。何が珍しいのかを理解するために、まずは「差」を考えてみましょう。
ここで「差」と言いましたが、統計的仮説検定では何かと何かの「差」を見ています。統計を自分でもやったことあるよ、という方は、「いやいや、相関係数が有意か判定したり、回帰係数が有意か判定したりするときに差は見てないでしょ」と思うかもしれません。しかし、相関係数や回帰係数の有意性を検定するような場合にも、実は「差」を見ています(後述)。ただし補足として、ここでいう「差」が平均値と平均値の差のように、引き算で得られるような差であるとは限りませんが。
差を見る検定として一番わかりやすいのは、2群の平均値差の検定であるt検定やz検定でしょうか。z検定は統計で仮定される母集団(特定のデータを生み出す集団全体)の特徴のうち、平均からのばらつきの程度を示す分散という値が既知である、という限定的な状況を想定しているので、通常はt検定が用いられることが多いですね。
t検定では、比較したい2つの群の平均値の差を出し、「もし仮に、2つの群の真の平均値に差がなかったとしたら」どのくらいの確率で偶然によってその平均値差か、もしくはより極端な差が得られるのか、を考えます。「真の平均値」というのが少しわかりづらいですが、(ここで説明しているスタイルの)統計では母集団が真の特徴を持っていて、現実の観測データはその真の特徴から確率的に(=ばらつきをもって)得られたものだと考えているわけです。
具体的な手続きを見ると、まずt検定では真の平均値には差がない、ということを仮定します(この前提となる仮説を帰無仮説と呼びます)。そのうえで、今回観測されたような差が、真の平均値に差がないという仮定のもとでは非常に珍しいのであれば、「本当に差がない」という仮定を維持することは難しいのではないか、と考えるわけです。
こうして、最初に置いた「差がない」という仮定を退けることを、統計学では「帰無仮説を棄却する」と呼びます。ちょっと迂遠な推論で、わかりづらいですね。ちなみに帰無仮説に対して、「差がある」とする仮説は対立仮説と呼ばれます。統計的仮説検定をちょっと専門的に記述するなら、「帰無仮説を棄却できるかどうか」を判断しているんですね。帰無仮説が棄却された場合には、対立仮説を支持する方向の判断をすることになります。
まとめると、「(真の値が帰無仮説の通りであるとすると)偶然によって得られたと考えるには手元のデータの差はちょっと極端すぎるよね」(=偶然にそれ以上の差が得られる確率が十分小さいよね)という状態を指して、「統計的に有意な差がある」と言っているわけです。重要なのはあくまでも「統計的に」考えた時に差があると考えられるかどうかの話をしているのであり、その差に実用上の意味があるのかについてはなにも言っていないところですね。
さて、上記t検定の説明は2群の平均値差の話でしたが、実は同じt検定で「ある集団の平均値が特定の値から有意に離れているか」も検定できます。こちらは1標本t検定と呼ばれ、t検定の考え方を理解するうえで基本となるものです。
考え方はまったく同じで、ある集団の真の平均値が事前に設定した値(例えば0)であると「仮に」考えた時、果たしてどの程度の確率で手元のデータの平均値が得られるかを考えます。そしてこれも同じように、その確率が十分に小さいのであれば統計的に有意である、と結論するわけですね。
この「(別の群の値ではなく)特定の値との差を考える」という考え方が、先述した相関係数や回帰係数の有意性の判定に用いられています。相関係数や回帰係数の有意性を調べる際には、一般的に「真の値が0である」という帰無仮説を設定し、観測された値が0から統計的に有意に離れているかを検定しています。
なので「統計的に有意」という言葉を見た時は、「何かと何かの差を見ている」と認識できればよいと思います。一歩進むと、「では何と何の差を見ているんだ?」と考えることで、その分析の全体像を把握しやすくなるでしょう。
・p値について
「統計的に有意」という言葉と併せて、統計的仮説検定の文脈でよく登場する謎の値にp値があります。おそらく「p < .05で統計的に有意であった」のような表現を目にしたことのある方も多いのではないでしょうか。
これまでの説明とあわせる形で、このp値についても簡単に触れておきます。
先述の説明では、統計的に有意であることの説明として、「(真の値が仮定の通りであるとすると)偶然によって得られたと考えるには手元のデータの差はちょっと極端すぎるよね」(=偶然に得られる差である確率が十分小さいよね)という状態を指すことを述べました。
この説明は口語的ですが、実際にはここでいう「(真の値が仮定の通りであるときに手元のデータの差かそれ以上の差が)偶然に得られる確率」というのは、必要な数値がそろっていれば計算で求めることができます。統計的仮説検定の文脈でよく聞く「p値」という値は、この確率のことを示しています。
例えばp値が0.05であるときには、確率は1を最大(100%)とするので、偶然によって観測以上の差が得られる確率は5%であることを示しています。この5%という値が得られたときに、「これは偶然とは考えづらいくらいの確率かな?」と検討するのが統計的仮説検定の手順です。
5%って皆さん小さいと思いますか?ゲームで攻撃が成功する確率とみると小さい気もしますし、手術で失敗する確率と考えると高い気もしますよね。なので確率の受け取り方というのは文脈によって変わってくるものなのですが、あくまで一般的にはこの5%という値より大きいか小さいか、というのが統計的に有意であるかどうかの判断基準に用いられることが多いです。
5%よりも低い確率でしか偶然に得られないような差がみられる場合には、統計的に有意であると判断することが多い、ということですね。もちろん、これは唯一絶対の基準ではなく、検定の文脈によって変更されることもあります。専門的には、この「p値が何%以下であれば統計的に有意と判断するか」という基準となる値を、有意水準と呼びます。有意水準は、「実際には帰無仮説が正しいのに、誤って棄却してしまう確率」をどこまで許容するか、という考え方に対応しています。
統計というと、なんらかの絶対的な基準でもって判断がされているようなイメージを持ちやすいと思うのですが、有意水準の設定については結構慣習的・恣意的な要素が多く、「なんで5%が基準なの?」という問いには明確な答えはないことが多いです。これは現在紹介しているスタイルの統計の思想が批判されるポイントでもありますね。
さて、p値については上記の説明の通りですが、巷では「p値についての誤解!」のような、p値を解釈するうえでの注意点をよく目にします。もしかしたらこれを読んでいる方の中にもそのようなメッセージを見たことがある人がいるかもしれません。なのでわざわざここでまとめなくとも......という気はしますが、一応主要なポイントを押さえておこうかと思います。
p値を誤解しないための押さえるべきポイントは上記の通りで、p値は、仮定したモデルのもとで今回のデータがどの程度珍しいかを示す指標です。有意水準との比較によって統計的有意性を判定できますが、それだけで効果の大きさや実用上の重要性まで判断できるわけではありません。p値が5%よりも小さいからと言って、現実の何かに対応して劇的な変化が生じるわけではなく、あくまでも連続的な確率の中で我々が設定した値が5%でしかない、ということですね。
同様に、p値が小さいからといって効果が非常に大きいとも限りませんし、p値が大きいからといって効果がないと主張することもできないわけです。あくまでp値は確率を示すものであり、効果の大きさや影響力の強さを担保してくれるものではない、ということです。
今では上記のような説明もかなり広く言及されるようになってきていますが、それでも「有意か、有意じゃないか」という二分法的わかりやすさは根強い人気を誇っています。もちろん、統計という営みが広く使われるためには、わかりやすさ、というのは重要な要素です。統計はそもそも、複雑な現実世界の現象をわかりやすく記述するという役割も持っているので、余計に「人間的にわかりやすいこと」には大きな価値があります。
しかし、「わかりやすいこと」自体が何らかの正しさを担保するわけではありません。複雑な世界を正しく読み解いていくために、二分法的なわかりやすさと現実世界の複雑さの折衷点を探すという行為・姿勢が、統計を生業とする者に必要なのかな、と考えております。
・最後に
わりと取り留めなく書いてしまったので読み直すと冗長なところが多いですね。初投稿なので許してください。
一応、私は上記の通り統計(特に心理・医療・社会科学分野の統計)を専門としております。特に学生への指導経験や本業におけるクライエントへの説明経験から、初学者への説明などは割と慣れている方かと思います。そのうち専門領域と絡めた統計の話の投稿もできればと考えております。
もし今回の投稿を最後までご覧いただけた方、興味をもってくださった方などいらっしゃれば、プロフィールを一瞥でもしていただけますと幸いです。