「ソースコードや社内資料を、外部のAIサービスに送れない」
「でも、AIにコードを書かせたり、直させたりしたい」
そんな方のために、ご自身のPCの中だけで動くAI開発環境(ローカルLLM)を設計し、導入の手順書をお作りします。
━━━━━━━━━━━━━━━━
■ できあがる環境
━━━━━━━━━━━━━━━━
・VSCode の中で、AIエージェント(Cline)が会話しながらコードを書く・直す
・AIモデルは Ollama で、ご自身のPCの中だけで動かす
・利用状況の送信(テレメトリ)を止め、Web参照も「読むだけ」に制限
・やめたくなったときに「元に戻す手順」つき
━━━━━━━━━━━━━━━━
■ お届けするもの(基本料金)
━━━━━━━━━━━━━━━━
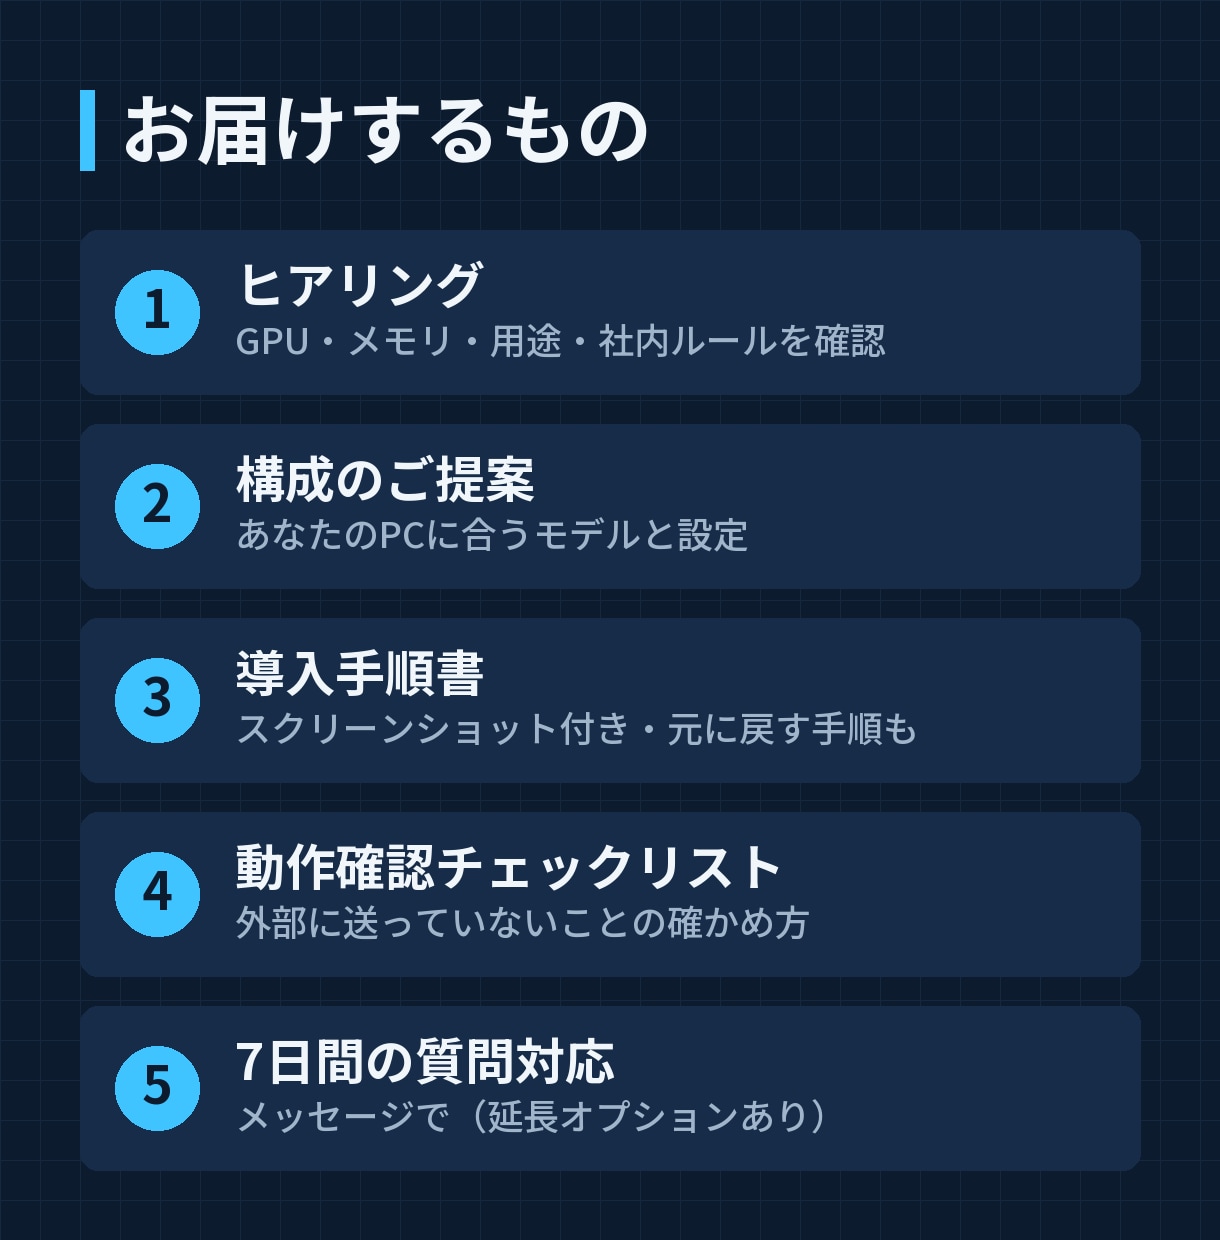
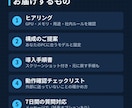
1. ヒアリング(GPU・メモリ・用途・社内ルールを確認)
2. お使いのPCに合わせたモデル選びと構成のご提案
3. 導入手順書(スクリーンショット付き)
- Ollama の導入とモデルのダウンロード
- Cline の設定(つまずきやすい4つの設定を含む)
- 外部への送信を止める設定と、止まっていることの確かめ方
- 元に戻す手順
4. 動作確認チェックリスト
5. 納品後7日間のメッセージでのご質問対応
━━━━━━━━━━━━━━━━
■ 出品者について
━━━━━━━━━━━━━━━━
自宅の RTX 4080 で、ローカルAIの速度やメモリの使い方を実際に測って記録しています。
同じ構成の環境を自分で毎日使っています。
(実測の例:生成速度 約88 トークン/秒、コンテキスト長 64k)
━━━━━━━━━━━━━━━━
■ こんな方におすすめ
━━━━━━━━━━━━━━━━
・会社の規則で、クラウドのAIにコードを送れない
・ゲーミングPC(NVIDIA製GPU)を、仕事や勉強にも活かしたい
・AIエージェントを、手綱を握ったまま使いたい
━━━━━━━━━━━━━━━━
■ 正直にお伝えしたいこと
━━━━━━━━━━━━━━━━
・ローカルのAIは、クラウドの最上位のAIより賢さでは劣ります。関数を書く・エラーを直す・小さなツールを作る、といった作業向きです
・GPUのメモリ(VRAM)が8GB未満、またはGPUがない場合は、快適には動きません。購入前にご相談ください
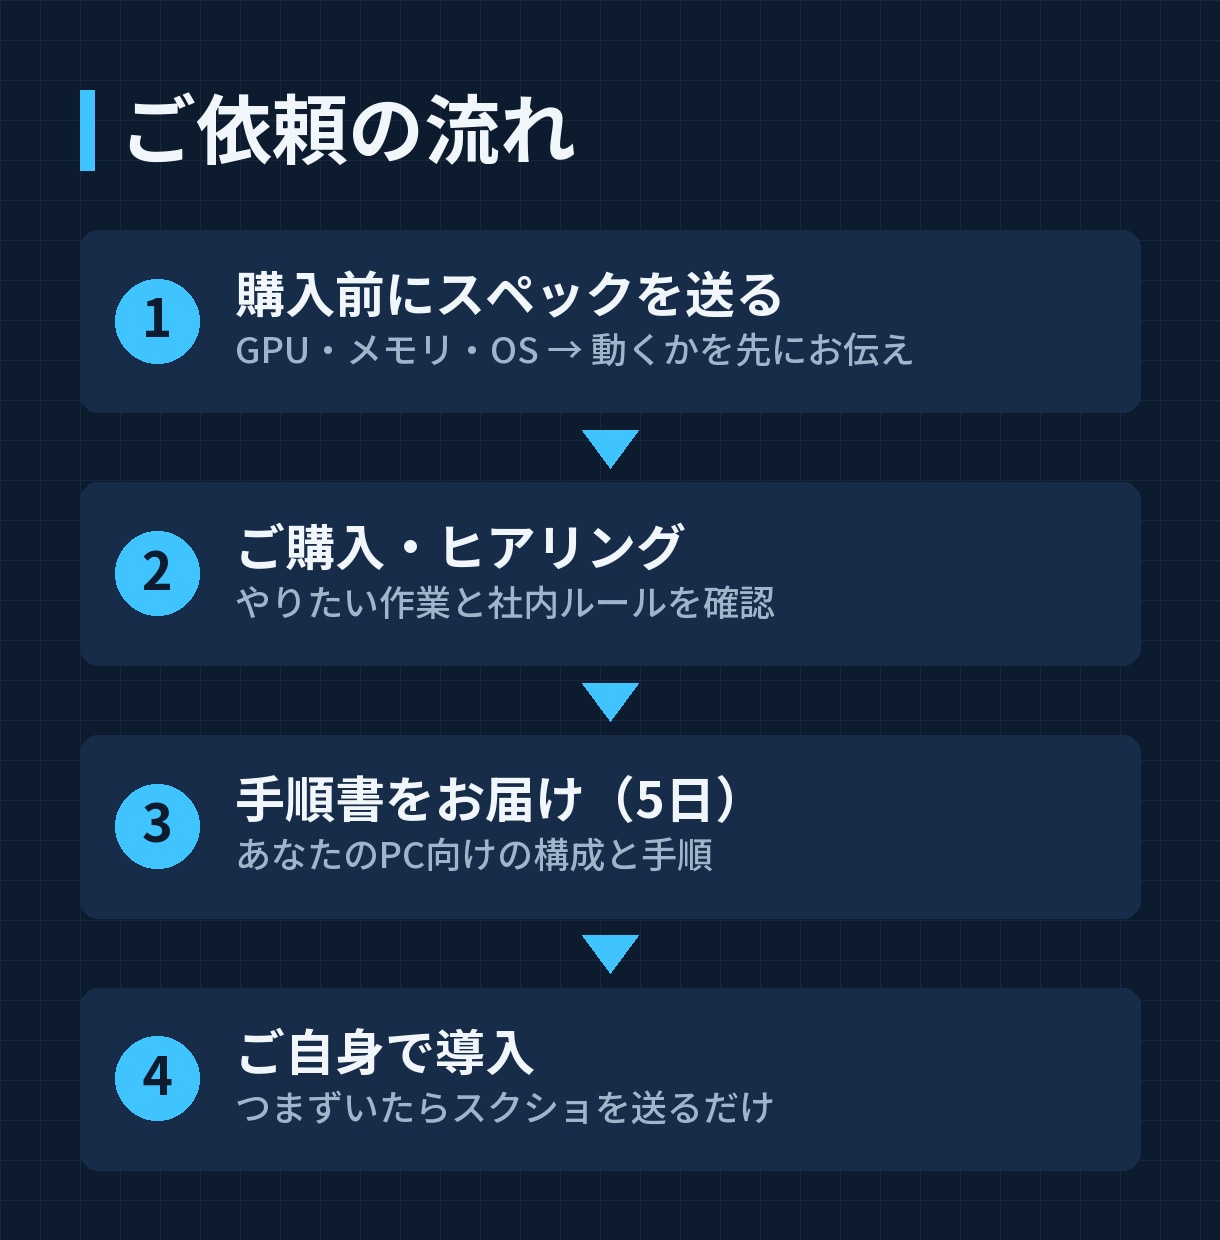
・購入前に、メッセージで「PCのGPU(例:RTX 4070)」「メモリの量」「OS」をお知らせください。動くかどうかを先にお伝えします
・対応OSは Windows 10/11 です(Mac・Linux はご相談ください)
・会社のPCに導入する場合は、ソフトの導入について社内の許可を取ってからご依頼ください
・お客様のPCを遠隔で操作すること、通話や画面共有でのサポートは行っていません。やり取りはすべてメッセージ(文章・スクリーンショット)で行います
・副業のため、平日は夜、土日は日中の対応です。メッセージには24時間以内にお返事します
■有料オプション詳細■
・つまずき解決サポート…導入中につまずいたら、画面のスクリーンショットとエラー文を送ってもらい、解決の手順を文章でお送りします(3回まで)
・質問対応の延長 …メッセージでの質問対応を、7日から21日に延ばします
・AIエージェントの安全フック導入…プロジェクトの外を触らせない・外部に送らせないための仕組みを入れます
・速度測定レポート…お使いのPCで2〜3モデルの速度を測り、表にしてお渡しします