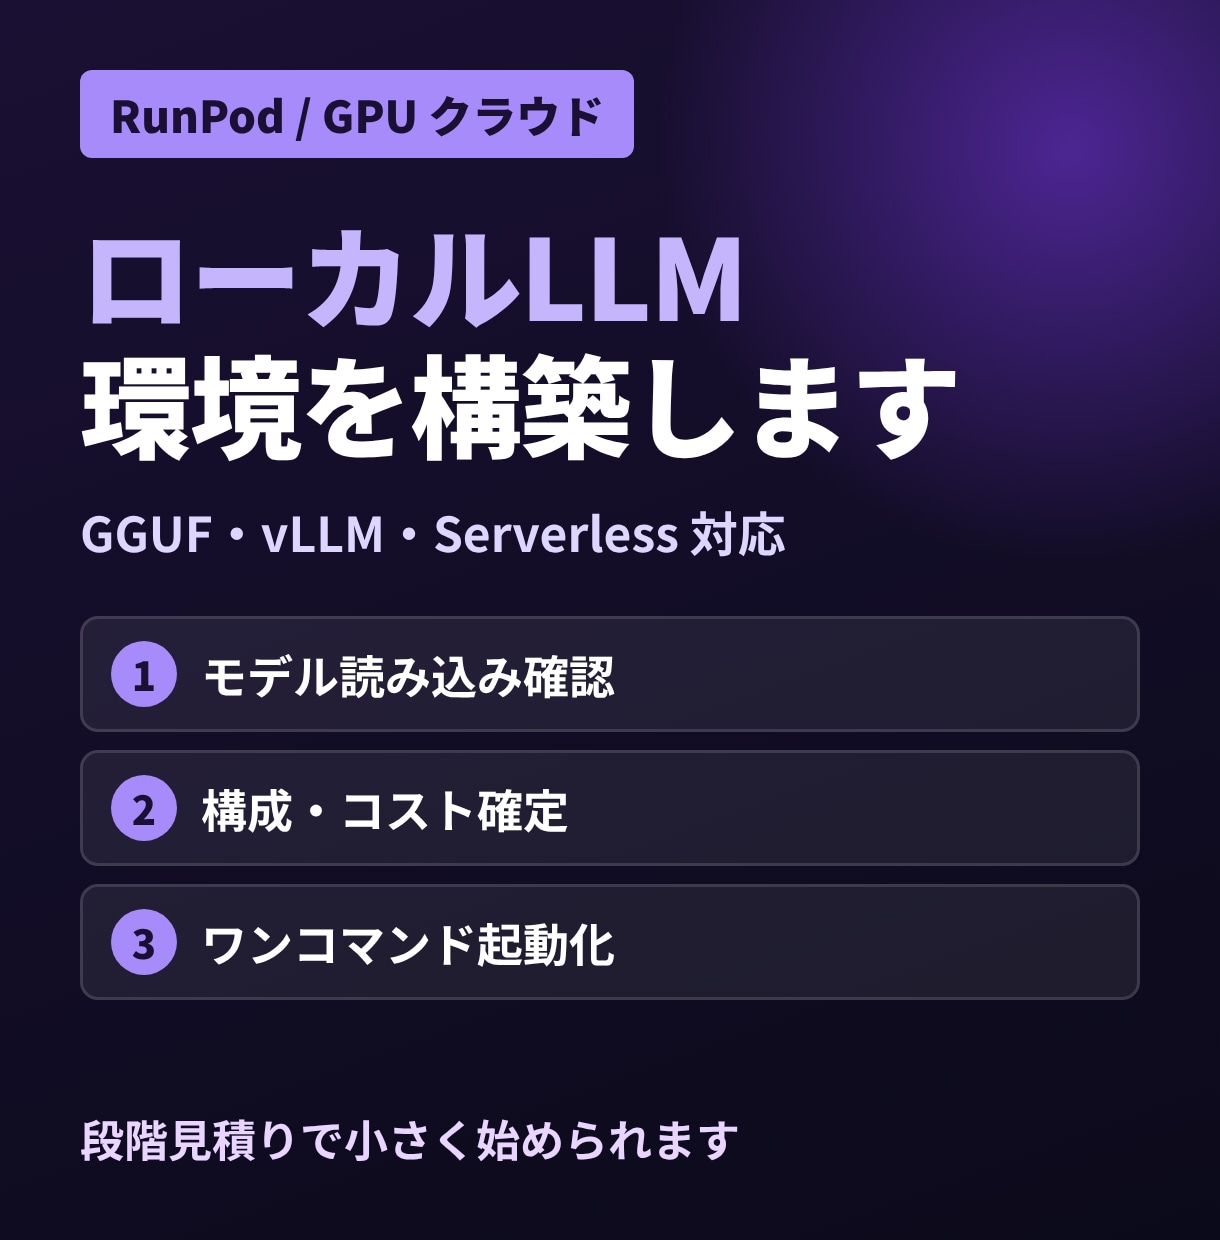
RunPod などのGPUクラウド上で、オープンモデル(Qwen・Llama 等)を動かす環境を構築・検証します。
「APIの利用料を抑えたい」「社外にデータを出さずにLLMを使いたい」「試したいモデルが手元のPCで動かない」という方向けです。
【対応内容】
■ GGUF形式モデルの読み込み・動作確認
■ GPU構成・コストの比較と最適化(Pod / Serverless)
■ Serverless エンドポイント化・API連携
■ 環境のワンコマンド起動化・運用手順書の作成
【進め方】
いきなり大きく発注いただく必要はありません。
フェーズを分けてお見積もりし、結果を見ながら次に進むか判断できます。
1. モデル読み込み確認(12,000円〜)
2. 構成・コストの確定(25,000円〜)
3. 環境の整備・運用パッケージ化(30,000円〜)
【実績】
・RunPod上のローカルLLM動作検証(Pod / Serverless)
・GPU環境の運用パッケージ化(ワンコマンド起動・テンプレート整備)
→ 同じ依頼者様から継続してご依頼いただいています。
【担当者】
システムエンジニア歴15年・バックエンド歴10年の現役エンジニアです。
※ GPU利用料(RunPodの料金)はお客様のご負担となります。目安はお見積もり時にご提示します。
スムーズに進めるため、以下をお知らせください。
■ 動かしたいモデル名・形式(例:Qwen ○○ GGUF Q4_K_M)
■ 用途(チャット / API / バッチ処理 など)
■ 予算感・GPU利用料の上限
■ RunPodアカウントの有無