ベトナム語は、声調記号の有無で意味が変わります。OCRでこの記号が落ちると、読み取り結果は別の言葉になってしまいます。
たとえば「bán」は「売る」、「bàn」は「机」、記号のない「ban」は「委員会」です。日本語でいえば、濁点が消えて「かぎ(鍵)」が「かき(柿)」と読まれるようなものです。金融・小売分野のお客様の案件で、この問題に取り組んだときの記録です。
何が起きていたか
ベトナム語の請求書、契約書、法的書類を合わせて5万件以上読み取り、AIチャットボットが参照する知識として取り込む案件でした。
最初に、大手クラウドのAPIを含む一般的な商用OCRで試したところ、声調記号と文字の誤認識が25〜30%ありました。「thanh toán(決済)」が記号の消えた「thanh toan」になる、「ký hợp đồng(契約締結)」が意味の通らない文字列になる、といった例が繰り返し出ていました。
困ったのは、その先です。読み取った文章は、チャットボットが答えを探すときの元データになります。文字が違っていると、該当する箇所が検索で見つかりません。契約条項や請求金額について尋ねても、間違った答えが返るか、「情報が見つかりません」と返る状態でした。
どの段階で記号が落ちていたか
調べてみると、記号が落ちている場所は1か所ではありませんでした。
1つ目は、画像の段階です。実際の書類は、きれいなスキャンではありません。スマートフォンで撮った写真が多く、傾き、ぼやけ、紙のしわ、感熱紙のかすれが混ざっていました。声調記号は文字の上下に付く小さな点や線なので、画像が荒れると文字本体より消えやすくなります。公開されているOCRの精度比較は、たいていきれいなスキャン画像で測られており、こうした条件は反映されていません。
2つ目は、文字を認識する段階です。汎用の多言語モデルは、多くの言語で平均的に精度が出るように作られています。そのぶん、ベトナム語の声調記号のような、1つの言語に特有の細かい区別には弱くなりがちです。
直した方法
読み間違えた文章を大規模言語モデル(LLM)に渡して直させる、という方法もよく聞きます。今回は選びませんでした。LLMは欠けた部分を推測で埋めるため、金額や日付を別の数字に書き換えてしまうおそれがあります。請求書や契約書では、それが最も避けたいことです。個人情報を含む書類を外部のAPIへ送ることになる点も、見送った理由です。
代わりに、記号が落ちていた段階ごとに手を入れました。
画像の段階では、モデルに渡す前に、ノイズを取り、傾きを補正し、明るさのむらに合わせて文字をくっきりさせる前処理を入れました。
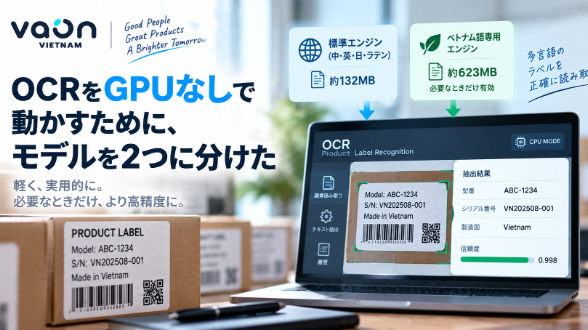
認識の段階では、社内で使っている132MBの軽量なOCRエンジンを、ベトナム語の実データ50万件以上で追加学習させました。行政書類のフォント、小売の請求書、地域による記号の付け方の違いなど、実際の書類に近いデータです。
そのうえで、読み取り結果を確かめる辞書の層を足しました。金融・小売の業務用語の辞書と、文字列どうしの近さを測る計算(レーベンシュタイン距離)を組み合わせ、辞書にない不自然な語が出たときは前後の文脈から直します。ここをLLMではなくルールで作ったのは、数字を勝手に作らないこと、そしてどの補正がなぜ行われたかを後から追えることを優先したためです。エンジンはGPUを使わずCPUだけで動くので、読み取りから取り込みまで、外部のクラウドAPIにデータを送らずに処理しています。
知識の抽出精度は、改善前は70%でした。改善後、人の目で照合した検証用の請求書・契約書データでは、誤りは見つからなくなっています。以前は「情報が見つかりません」と返していた質問にも、答えられるようになりました。ただし、これはこの案件で検証したデータでの結果です。どんな書類でも誤りがゼロになる、という意味ではありません。
まだ残っている限界
3つあります。
業務辞書は、この案件の金融・小売の用語に合わせて作っています。医療など別の分野で同じ水準を出すには、その分野の辞書を足す必要があります。
追加学習に使ったデータは、この案件で多かった行政書類のフォント、小売の請求書、スマートフォンで撮った写真が中心です。自由に書かれた手書き文字のように、学習データに含まれない種類の書類については、精度をまだ確かめていません。
社内のサーバーで動かす方式のため、お客様の側でCPUサーバーを用意していただく必要があります。すぐに呼び出せるクラウドのOCR APIと比べると、使い始めるまでに時間がかかります。
要件がまとまっていなくても構いません。状況を聞かせてください。出品サービスのページからご連絡いただけます。