スケジュール
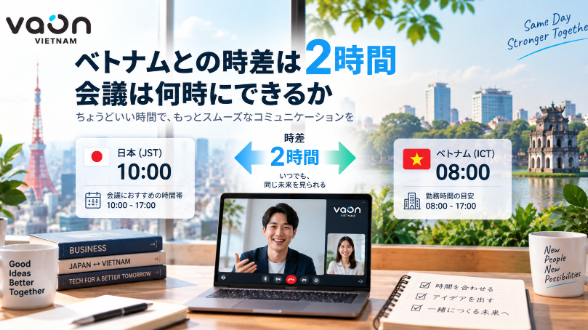
平日9時〜19時(日本時間)で対応しております。土日祝はお休みをいただいておりますが、緊急のご連絡には翌営業日の午前中までにご返信いたします。 初回のご相談はオンラインで30分ほど、資料のご用意は不要です。現在の状況を伺い、当社がお力になれるかどうかを率直にお伝えします。 お見積りは、ご相談内容を確認したうえで3営業日以内にご提示いたします。
ITエンジニア / フロントエンドエンジニア
経験年数 :
15年
ITエンジニア / バックエンドエンジニア
経験年数 :
15年
AI / AIエンジニア(機械学習)
経験年数 :
5年
C:5年
HTML:12年
Java:10年
JavaScript:12年
PHP:12年
Python:6年
Ruby:3年
Swift:5年
Flutter:5年
Next.js:10年
Node.js:10年
Ruby on Rails:3年
Spring Boot:5年
Amazon Web Services:7年
Firebase:8年
Docker:8年
MySQL:12年
PostgreSQL:10年
Git:10年
GitHub:10年
Movabletype:2年
WordPress:12年
Google スプレッドシート:10年
Google スライド:10年
Google ドキュメント:10年
EC-CUBE:5年
Shopify:6年
AppsFlyer:5年
Google Analytics:11年
Google Search Console:8年
Hubspot:5年
Microsoft Project:6年
ChatGPT:3年
Figma:8年
IT相談・システム開発 要件定義ラボ型開発AI・LLM活用レガシー刷新
建設
農業
EC
ベトナム語
ネイティブレベル
英語
ビジネスレベル