福井でホームページを作っています。「ChatGPTに自分の店のことを聞いても、サイトが出てこない」という話を聞くことが増えました。
AIの答えにどのサイトが出るかは、各社が決めることで、外からは分かりません。ただ、その手前に「AIのロボットが、そもそもサイトを読める状態か」という関門があります。ここは外から見れば分かります。
自分のサイト2つを、この目で調べ直しました。そのときに整理した「ロボットは3種類ある」という話を書きます。
■ 先に結論
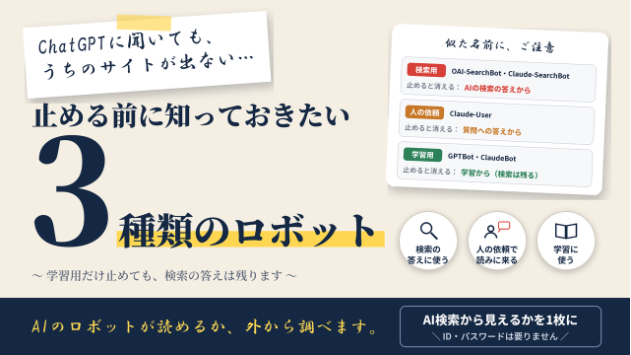
AIのロボットには、3つの種類があります。
・検索の答えに使うもの
・人がAIに頼んだときに、読みに来るもの
・学習に使うもの
止めたときに消えるものが、それぞれ違います。「学習に使われたくない」なら、学習用だけを止めれば足ります。検索の答えに使うものまで止めると、AIの検索の答えに出なくなります。
■ 1 検索の答えに使うロボット
AIの検索の答えにサイトを出すために、読みに来るロボットです。
・OAI-SearchBot(OpenAI)
OpenAIは、これを止めたサイトはChatGPTの検索の答えに出さない、と書いています。
・Claude-SearchBot(Anthropic)
止めると、Claudeの検索の索引に入らなくなる、とAnthropicは書いています。
・PerplexityBot(Perplexity)
Perplexityの検索結果にサイトを出し、リンクするためのものです。学習には使わない、と書かれています。
・Googlebot(Google)
Googleは、「AIによる概要」に出るのに特別な対策は要らず、通常の検索に出ていることが前提だとしています。つまり、ここを止めると、AIによる概要の前提から崩れます。
■ 2 人が頼んだときに読みに来るもの
人がAIに「このページを読んで」と頼んだり、質問したりしたときに、その場で読みに来るものです。
・ChatGPT-User(OpenAI)
検索に出るかどうかの判断には使わない、とOpenAIは書いています。また、robots.txtが効かない場合がある、とも書いています。
・Claude-User(Anthropic)
止めると、人の質問への答えに、そのサイトを使えなくなる、とAnthropicは書いています。
・Perplexity-User(Perplexity)
人が頼んだ読み込みなので、robots.txtはおおむね効かない、とPerplexityは書いています。
■ 3 学習に使うもの
・GPTBot(OpenAI)
・ClaudeBot(Anthropic)
・Google-Extended(Google)
・Applebot-Extended(Apple)
どれも、各社が「学習用」としているものです。たとえばAppleは、Applebot-Extendedを止めても、Siriやスポットライトの検索には出る、と書いています。GoogleのGoogle-Extendedも、検索の側を決めるのはGooglebotだ、という書き方です。
学習に使われたくない、と考えるのは自然なことです。止めるかどうかは、サイトの持ち主が決めてよいところです。
■ 取り違えやすいところ
名前が似ています。ClaudeBotは学習用、Claude-SearchBotは検索用です。GPTBotは学習用、OAI-SearchBotは検索用です。
「学習用を止めるつもりで、検索用まで止めていた」ということが起こり得ます。とくに、robots.txtで「User-agent: *」に対して止める書き方をすると、名前を挙げていない検索用のロボットも、ふつうの検索のロボットも、まとめて止まります。
海外の大手の新聞社のrobots.txtを読んでみると、3種類すべてを名前で挙げて止めていました。これは意図してのことで、間違いではありません。大事なのは、自分のサイトが「意図したとおりに」なっているかです。
■ robots.txtの外で止まることもある
ひとつは、置き場所の設定です。Cloudflareは2025年7月から、新しく登録したサイトで、AIのロボットを初期設定で止めています。robots.txtを見ても分かりません。管理画面の設定で止まっています。
もうひとつは、ページの作りです。ChatGPT・Claude・PerplexityのロボットはJavaScriptを動かさない、という調べ(Vercel)があります。画面をJavaScriptで後から組み立てる作りだと、ロボットが読みに来ても、中身が空に見えます。
■ llms.txtは置いたほうがいいか
AIのために置くファイルとして、llms.txtの名前をよく見かけます。Googleは、これを使っていないと公式に書いています。AIによる概要に出るために、新しい機械向けのファイルは要らない、とも書いています。
他社のAIの道具には読むものもあるので、置くこと自体が悪いわけではありません。ただ、置けばAIの答えに出る、というものではありません。
■ 自分のサイトで見たこと
YNHTのサイトと、運営しているもう1つのサイトを調べました。
・13種類のロボットのどれも、robots.txtで止めていませんでした
・ロボットの名前で開いても、止められませんでした
・本文は、JavaScriptを動かさなくてもHTMLに入っていました
・llms.txtは置いていません(上の理由で、急いで置く必要はないと考えています)
どちらも、読める状態でした。それでも、AIの答えに出るかどうかは、別の話です。この関門を通ったうえで、何を書いているかが問われます。
■ 自分で確かめる手順
1 ブラウザで「サイトのアドレス/robots.txt」を開く
2 「User-agent:」の行を探し、上の3種類の名前が出てこないかを見る
3 名前の下に「Disallow: /」があれば、そのロボットはサイト全体を読めません
ここまでは、1つのファイルを読むだけです。置き場所の設定やページの作りまで、30ページ分を1つずつ確かめるとなると、手で追うのは大変です。私はそこを機械にやらせています。
■ まとめ
・AIのロボットは、検索用・人の依頼用・学習用の3種類
・学習を止めたいなら、学習用だけを止めれば足りる
・名前が似ているので、取り違えに注意
・robots.txtの外(置き場所の設定・ページの作り)でも止まる
・llms.txtは、Googleは使っていない
AIの答えに出るかは約束できるものではありません。でも、読めない状態のままでは、その手前で止まっています。まず、通れるかどうかを見てください。
----------
AIのロボットが読める状態かを、アドレスだけで調べて1枚にしています。13種類のロボットごとに「通れるか」を表にしてお渡しします。
・AI検索(LLMO)から見えるか調べて1枚にします
ふつうの検索のほうは、こちらで調べています。
・検索に出ない原因を調べて1枚にします
ご質問だけでもお気軽にどうぞ。