ご覧いただきありがとうございます。
国立大学大学院で物理学専攻に在籍し、日々Pythonを用いた高度な数値計算やデータ解析を行っている現役の大学院生です。
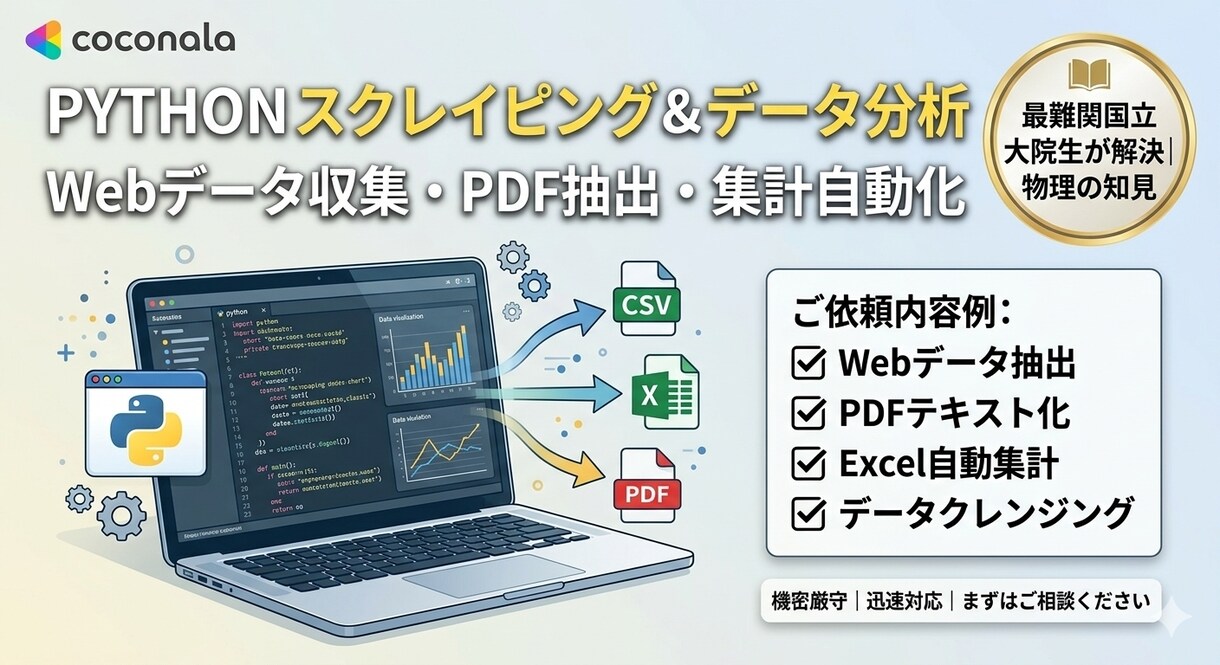
面倒なWebサイトからのデータ収集、大量のExcel/CSVデータの集計・可視化、画像PDFからのテキスト抽出など、データに関わるあらゆる業務をPythonを用いて迅速に自動化・効率化いたします。
物理学で培った数理的アプローチとロジック構築力を活かし、データの「正確性」にこだわったツール作成・データ納品を行います。
【このような方におすすめです】
・ECサイトや不動産サイトから商品情報を毎日自動で収集したい(スクレイピング)
・大量のPDFファイル(請求書や論文、リスト等)から特定の文字や数値を一括で抽出したい
・手作業で行っているExcel/CSVの集計・グラフ化を、ボタン一つで自動化したい
・集めたデータをPandasなどを用いて綺麗にクレンジング・整形して納品してほしい
【対応可能な業務内容】
① Webスクレイピング:指定サイトからのデータ抽出、自動ダウンロードツールの作成
② PDFデータ抽出:PDF(テキスト/スキャン画像)からの特定項目のテキスト・CSV化
③ データ前処理・分析:表記揺れの修正、異常値の除去、Pandas/NumPyを用いた集計
④ 自動化スクリプト開発:環境に合わせた実行ファイル(.exe等)やFastAPIを用いたAPI構築
【主な技術スタック】
Python(BeautifulSoup, Selenium, Pandas, NumPy, FastAPI, 各種PDF解析ライブラリ)
【基本料金(10,000円)に含まれる内容】
・単一サイトからの基本的なスクレイピング、または標準的なPDFからのデータ抽出
・納品物:抽出データ(CSV/Excel)、またはPythonスクリプトファイル
・無料修正:2回まで
※ターゲットサイトのセキュリティ、PDFの構造(スキャン画像の精度など)、データのボリュームによって作業量が変わるため、必ずご購入前に「見積り・カスタマイズの相談」よりご相談ください。
ご購入前に、トラブル防止のため以下のご確認とご準備をお願いいたします。
① 事前のご相談(必須)
サイトの仕様やPDFの形式によって、抽出の難易度が大きく変動します。事前に「見積り・カスタマイズの相談」から、以下の情報を添えてご連絡ください。
1. 対象のWebサイトURL(または、抽出したいPDFのサンプルファイル)
2. 抽出したい具体的な項目(例:商品名、価格、住所、PDF内の金額など)
3. 希望する納品形式(Excel、CSV、またはPythonプログラムそのもの)
② スクレイピングに関する注意点
ログインが必要なサイト、2段階認証があるサイト、または利用規約でスクレイピングが厳しく禁止されているサイト(Amazon、メルカリ等)は、ご依頼をお受けできない、または仕様を調整させていただく場合がございます。
③ 納期について
週10〜20時間の稼働時間を確保しております。ご相談時に具体的な納期をお伝えいたします。
※お預かりしたデータやログイン情報、PDF資料は機密を厳守し、お取引完了後に責任を持って完全に消去いたします。