WindowsのマシンでPythonを使用したWebスクレイピングを行います。
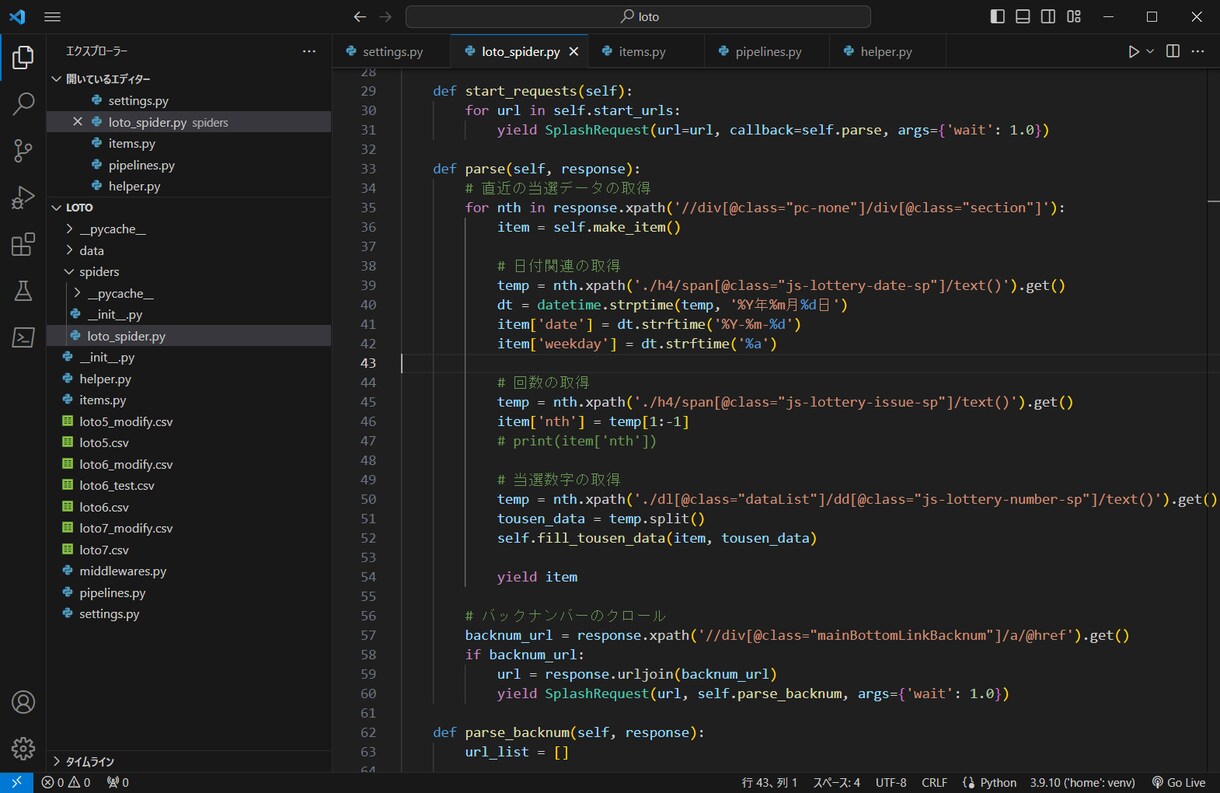
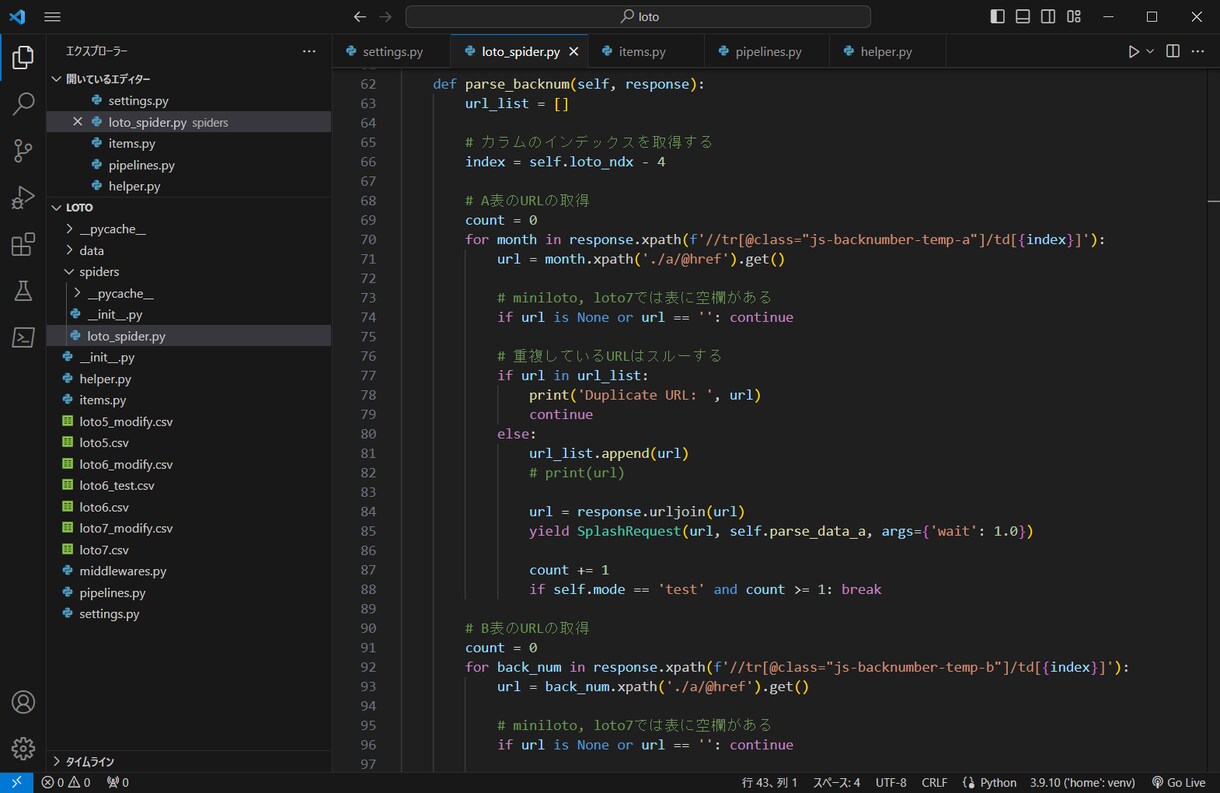
SelectolaxやPlaywright、Scrapy、splashなどのライブラリやツールを使用します。
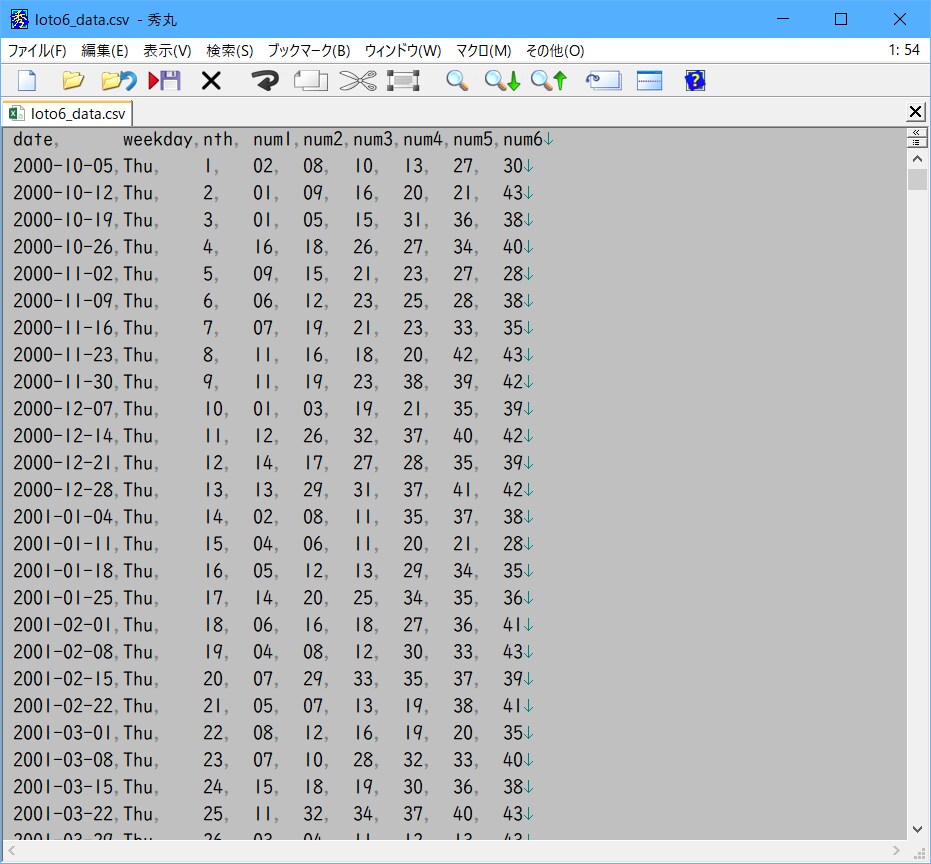
最終的な提出物は取得したデータファイル(CSV, JSON, Excelブックなど)となります。
もし、プログラムのソースコードも必要な場合には、有料オプションでお受けします。
ただし、ある程度のPythonの知識が必要となります。
(例:仮想環境の作り方、プログラムの実行方法、splashを使用した場合には、Dockerの基本的な使用方法(wsl2のインストール、イメージのダウンロードやコンテナの起動、終了、破棄など))
※ 当方はWindows環境ですので、Macの方はご注意ください。
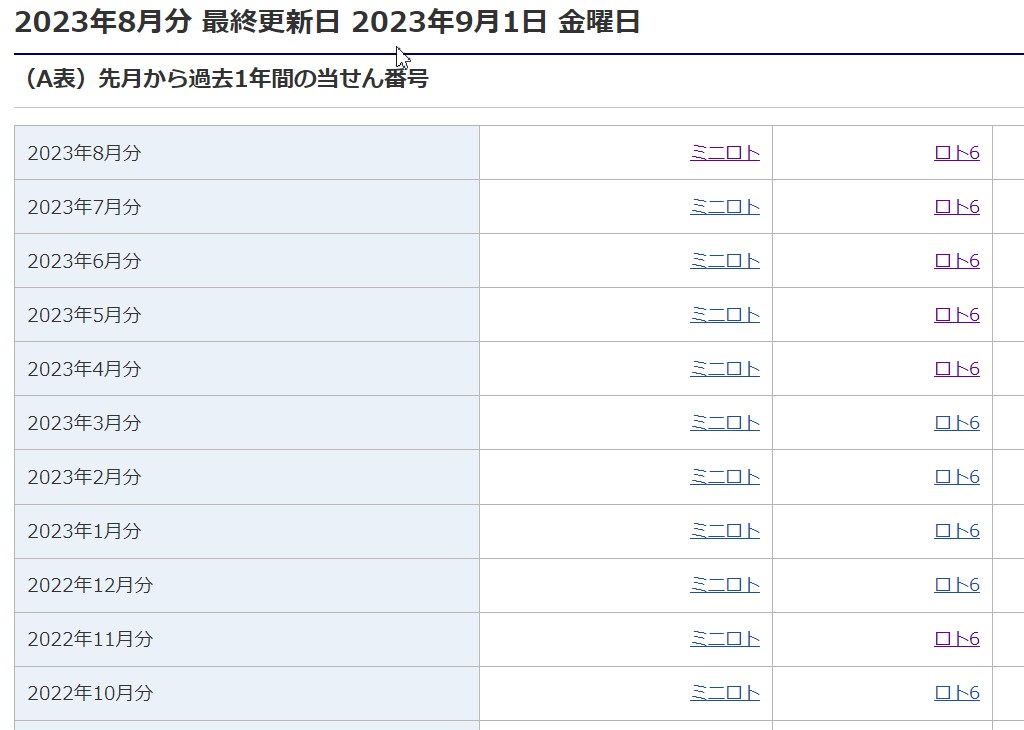
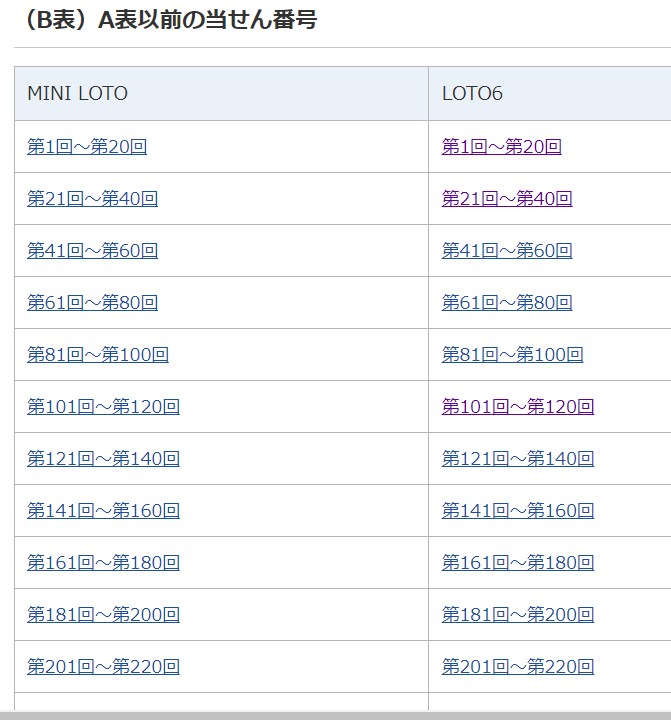
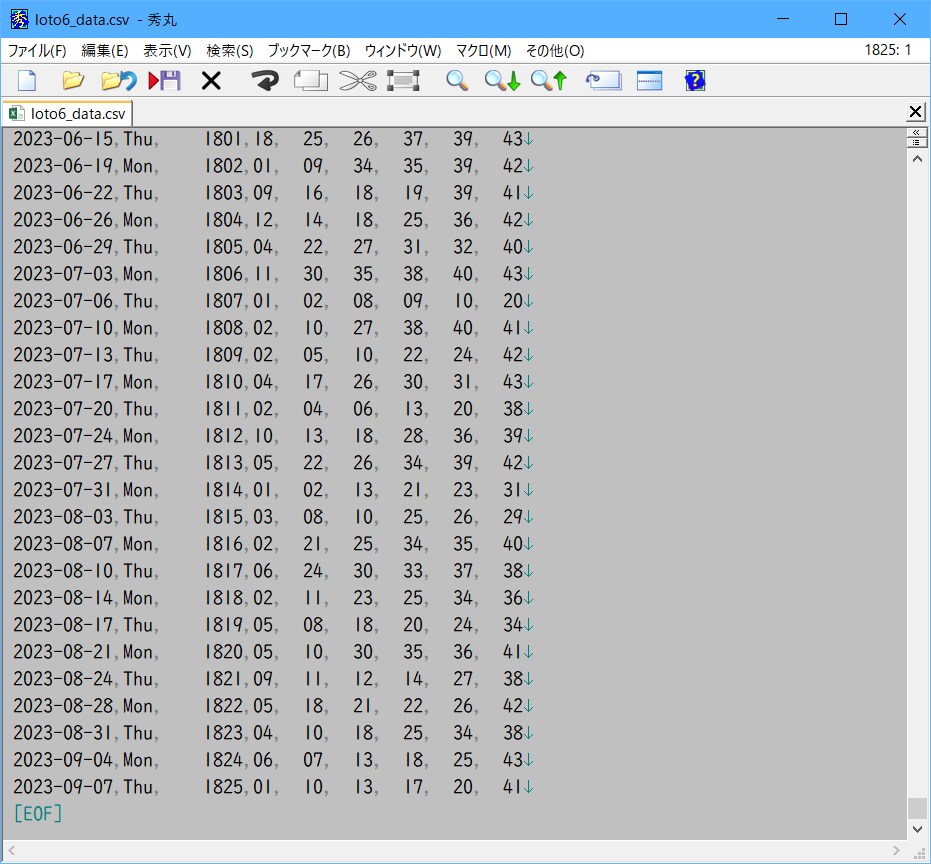
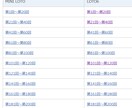
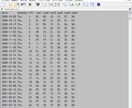
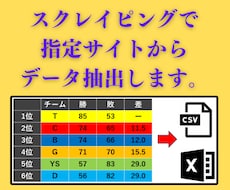
画像の欄に掲載しているのは、みずほ銀行のサイトから宝くじのロトの当選データを取得したものになります。参考にしてみてください。
このようなデータ収集が得意です。
-----------------------------------------------------------------
なお、私はまだココナラの初心者で、1件もお仕事を受注したことがありません。
従って、お客様とのやり取りで何か不手際があるかもしれませんが、どうかご容赦ください。
最近のWebサイトは構造が複雑なものもあり、私の知識と経験では対応できないものもあります。
その場合にはご依頼を完了することができないケースもあるかと思います。
その場合には、もちろん料金は頂きません。
まずは「どのサイト」から「どのようなデータ」を取得したいのかを具体的にご相談ください。
こちらで簡単に調査して、取得可能かどうかを判断致します。
それと、画像ファイルを収集する場合ですが、あまりに容量が大きくなる場合(トータルで3GBを超えるようなケース)には、ご依頼をお受けできないことがあります。
また、対象となるWebサイトがスクレイピングを禁止している場合には、
データ収集を行うことはできませんのでご了承ください。