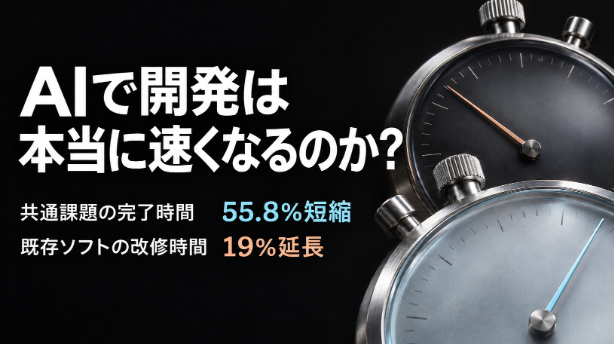
同じ課題を解き終えたプログラマーの平均はAIを使えるグループで71分、使えないグループで161分だった。全員が挑んだのは指定された12のテストにすべて合格するプログラムを作る仕事である。完了した人の間に約90分の差がついた(1)。
ところが別の実験では自分のソフトウェアを長く育ててきた開発者が普段の改修にAIを使えると、作業時間は推定19%延びた。さらに興味深いのは、実験を終えた参加者自身はAIのおかげで平均約20%短くなったと考えていたことだ(2)。
どちらの数字を信じればよいのだろうか。
一つ目の研究で時計が止まるのは、提出したコードが共通のテストに初めて合格したときだ。二つ目で測ったのは担当者が実際のプロジェクトを変更し、レビューを受けて手直しするのに自分で使った時間である。二つの研究は同じ「開発時間」という言葉で、違う範囲の仕事を測っていた。 ただし、この違いだけで結果が逆転した原因まで説明できるわけではない。参加者も課題も使ったAIも違うからだ(1)(2)。
では、たとえばデイサービスから「今日だけ、お迎えの時刻を変えられるようにしたい」と相談されたら、どちらの研究を見積もりに使えるだろう。時刻を選ぶ欄はすぐに作れても、火曜の迎えを9時から9時半に変えたとき、来週の火曜は9時のままだろうか。運転担当が手にする紙にも同じ時刻が載るだろうか。
発注者が知りたいのは、その朝から安心して使えるのかということだ。開発者が知りたいのは、AIに任せると自分の作業がどれだけ減るか。経営者なら、空いた時間で次の案件を引き受けられるか、支払いが実際に減るかまで知りたい。答えを出すための時計はそれぞれ少しずつ違う。
本稿では二つの原論文とその後の研究を読み、何が観測され、何がまだ仮説にとどまるのかを確かめる。そのうえで架空の送迎表の改修を一件だけ追い、どこでAIの利点が生まれ、どこで確認の手間に消えるのかを考えたい。
1 55.8%短縮した実験では時計はいつ止まったか
Pengらは2022年5~6月、フリーランス向けの仕事仲介サイトUpworkで職業プログラマーを募集した。契約した95人を無作為に分け、45人に当時のGitHub Copilotを使えるようにし、残る50人を比較群とした。論文の公表は2023年である(1)。
当時のCopilotは開発者が入力しているコードの前後を手がかりに、その続きを候補として示す道具だった。開発者は自分で作業を進めながら候補を採用するか、自分で書くかを選べる。この補助を使えるようにすると、同じ課題の成績がどう変わるかを調べた(1)。
課題はJavaScriptでHTTPサーバーを実装すること。簡単にいえば、ブラウザなどから特定の宛先に要求が届いたとき、決められた内容を返すプログラムを作る。参加者は課題の説明とコードのひな型を受け取り、判定に使う12のテストを事前に読むこともできた。テスト自体は変更できない。両グループともインターネットで調べ物をしてよかった(1)。
利用権を与えられた参加者のうち5人は、登録手続きを完了しないまま実験を始めている。論文はこの5人を後から比較群に移していない。最初にどちらへ割り当てられたかで集計している。したがって、そこで問われているのは提案を実際に何回採用した効果というより、Copilotを使える条件に人を置いたときの違いである(1)。
時計の両端はかなり明確だ。参加者が課題に参加し、各人用の課題ファイル一式が作られたときに時計が動き出す。参加者が変更を提出するとテストが走り、12件すべてに初めて合格した提出の時刻で止まる。提出は何度し直してもよい。速く正しく完成させることには報酬上の動機もあった(1)。
この仕事には、仕様を尋ねる取引先も翌朝まで返事を待つ承認者も登場しない。参加者は「この動作で依頼者に受け入れてもらえるだろうか」と考え続ける代わりに、目の前のテストを実行できる。ここまで完成条件がそろっているからこそ二群の時間差をきれいに観察できる。
最後まで解けたのは両群とも35人だった。完了者の平均時間はCopilot利用可で71.17分、比較群で160.89分。差は89.72分で、比較群の平均時間を分母にすると55.8%の短縮になる(1)。
同じ35人でも利用可能群では45人中35人、約78%である。比較群では50人中35人、70%だった。今回はこの完了割合の差については、偶然のばらつきと区別できるほど確かな結果は得られなかった。「解けた人が何分かかったか」と「割り当てられたうち何人が解けたか」は、同じ実験の中でも別々の問いである(1)。
発注側が95人全員に一件ずつ仕事を渡したと考えるとこの違いが見える。期日までに完了しなかった仕事は、別の人に回すか範囲を決め直してやり直す。完了者の平均71分と161分からは、その引き継ぎに費やす時間を見積もれない。全件を処理する予算を出すなら、途中まで作業した時間と残った仕事を引き取る人の負担も必要になる。
無作為に分けた実験でも、完了した人だけを後から取り出すとその顔ぶれまで無作為に一致する保証はない。AIのおかげで初めて完了できた人がいれば、AI側の平均にその人が加わる。極端に苦戦した人が途中でやめれば、その時間は完了者の平均に入らない。どちら向きにどれほど数字を動かしたかは分からない。この制約を理由に90分近い差を軽く見るのも、制約を忘れて顧客への納期を半分にするのも早計だろう。
著者らが報告した短縮率の95%信頼区間は21%から89%である。これは同じ設計で標本を取り、同じ方法で区間を作ることを繰り返したとき、できた区間の約95%が真の効果を含むという考え方に基づく。新しく発注した案件の95%がこの短縮率の範囲に収まるという予報には使えない。
完了に300分を超えた4人は全員が比較群にいた。その人たちを除いた分析でも、著者らは短縮という結論を維持している。平均が遅い少数の影響を受ける可能性については点検されている。それでも、どの案件でも55.8%短くなると予測するには実験の対象が限られている(1)。
この結果を読んで、私は完成条件が初めから明らかで答え合わせを何度もできる仕事を次の案件でAIを試す候補に挙げたい。ただし「テストがあるから速くなった」とまで結論すると一歩進みすぎる。両群には同じテストが渡っていた。実験から直接推定できるのはその環境でCopilotの利用を認めたときの差である(1)。
テストの有無がAIの効果を変えるという仮説を確かめるには、テストのある仕事とない仕事の両方で、さらにAIの有無を比べる必要がある。実験で短縮を観察できたことと、自分の案件でそれを再現する条件が特定できたことには距離がある。
2 19%延びたのはどんな開発者の何の時間か
AIの能力や影響を調べる研究組織METRのBeckerらは2025年2~6月、開発者に自分の仕事を実験に持ち込んでもらった。参加したのは公開ソフトウェアの開発に継続して関わってきた16人である(2)。
対象プロジェクトでの経験は平均約5年。すでに蓄積したコードや変更履歴があり、ほかの人たちも同じソフトウェアを使い続けている。取り組んだのは報告された不具合の修正や小さな機能追加など、実際にそのプロジェクトで必要な仕事だった(2)。
ここでくじを引いた単位は、開発者が持ち込んだ一つひとつの課題である。開発者がこれから取り組みたい作業を書き出し、それぞれをAIあり・なしで進めたらどれくらいかかるか、先に予想する。その後、原則として課題ごとにAIの利用を許すかを無作為に決めた(2)。
得意な仕事だけAIに任せ、苦手な仕事を手で行うといった選び方が割り当ての時点で結果に入り込みにくい。同じ開発者が両方の条件を経験するが、二回とも初めての仕事である。一度直した不具合をもう一度、解き方を知った状態で直すことによる有利さも避けられる(2)。
利用を許された課題では、本人が役に立たないと思えばAIを使わなくてもよい。主に使われたのはCursor ProとClaude 3.5/3.7 Sonnetだった。研究者は基本操作のトレーニングも行った。利用不可の側では生成AIによる補完も制限されるが、検索は利用できる。19%という数字はその時期の道具を普段の仕事に使える条件へ割り当てた効果の推定値である(2)。
担当者は普段の手順で変更案を送り、ほかの開発者に読んでもらい、必要な手直しをする。測ったのは担当者本人がレビューの前後に使ったと申告した作業時間である。確認した同僚の労働時間や返事を待った一晩はこの時計に入らない(2)。
研究期間内にレビューが済まなかった27件ではレビュー後に担当者が使う時間を直接観測できなかった。研究者は同じ割り当て条件での平均を当てはめ、補い方を変えても結論が大きく動かないかを確かめた。論文が報告した19%には観測できた時間と欠けた部分を補った推定の両方が含まれる(2)。
分析した246件のうち、AI利用可能が136件、利用不可が110件だった。単純に両群の作業時間の平均を比べると、利用可能側は約34%長い。論文が主結果とする19%はどうやって得られたのだろうか(2)。
偶然にも利用可能側には、割り当て前の本人の見積もりでやや時間がかかりそうな課題が入った。著者らはこの事前情報を使って、もともとの難しさの違いを考慮し、時間の変化を推定した。同じ仕事の記録から単純な平均比を計算すると約34%延長、事前見積もりを取り入れた主分析では約19%延長となる(2)。
難しさを尋ねた時点は重要だ。くじを引く前の数字なら、AIを使って苦戦してから「もともと難しかった」と理由を付け直す余地が小さい。事前予想と実際の時間にも関連があった。このため私は19%を主結果、34%を比較の仕方によって数字がどれだけ動いたかを示す材料として読む(2)。
もっとも、246件は16人が繰り返し取り組んだ課題だ。246人を一回ずつ観察した場合と同じ広さの証拠にはならない。実際に、開発者の顔ぶれと各人の課題の両方を元の記録から何度も抽出し直して不確かさを計算すると、推定の幅は少し広がる。くじ引きが公平であることと、別のチームにも同じ数字を持ち出せることは分けて考えたい(2)。
自己申告には時計の押し忘れや別の作業と重なった時間を思い違いする余地もある。研究では一部の画面録画を調べ、主な作業が何であったかを分類した。詳しい行動比較に使えたのは74件、84時間分である。短い録画の分類を優先したことなども付録に記されている(2)。
映像からは人が手でコードを書く活動の割合が減り、出力を読んだり、指示したり、応答を待ったりする時間が生じたことが分かる。ただし、提案を読む5分が丸ごと無駄だったかどうかは映像だけでは決まらない。そこで不具合を見つけたなら必要な5分かもしれない。自分で書いていれば初めから入らなかった不具合なら同じ5分が追加負担になる(2)。
この研究の強みは既存の仕事に残る面倒まで測定が届いたことだ。弱点はその仕事を持ち込める16人がすべての開発者を代表するわけではないことにある。参加者にはおおむね2時間以内を見込める単位で課題を出し、長いものは分けるよう依頼していた。
数か月の新規プロジェクトで設計から運用までAIを組み込んだらどうなるか。あるいは経験の浅い人が初めて触るソフトウェアの構造を理解するために使ったらどうか。どちらもこの実験の19%だけでは答えられない(2)。
3 二つの数字を平均すると何を取り違えるか
Pengらがそろえたのは仕事と採点方法である。人を二群に分け、全員に同じひな型と12のテストを渡した。得られた数字は一つの課題を解けた人たちの所要時間の差だった(1)。
Beckerらは開発者がそれぞれ持ち込んだ仕事の側でくじを引いた。同じ人が違う課題をAIあり・なしで経験し、普段の品質確認や手直しを経た。得られた数字は持ち込まれた既存の仕事でAIを使えると、その人の作業時間がどう変わるかだった(2)。
AIなしの時間をそれぞれ100と置くと、一方はAIありで約44、もう一方は119に相当する(1)(2)。ここで、時間と件数の言い換えにも注意したい。100分の仕事が119分になると、同じ質の仕事を休みなく続けて片付けられる件数は元の約84%になる。100を119で割るからだ。作業時間が19%増えたとき、時間当たりにできる件数の減り方は約16%である。
では、仮に一社がこの二種類の仕事を同じ件数だけ引き受けたらどうか。一件目はもともと100分、二件目は400分と置こう。説明のためそれぞれに二つの報告値を当てはめる。一件目は55.8%短縮して44.2分、二件目は19%延びて476分。二件の合計は500分から520.2分へ、かえって長くなる。
これは実案件の予測ではなく、割合の扱いを示す架空の計算である。総工数への影響は元の仕事にそれぞれ何時間かかっていたかで変わる。 件数が半々でも長い方の仕事が結果を大きく動かす。そのうえ実際には、担当者、道具、完成条件も異なる。55.8%と19%を平均して、業界や自社の時短率を作ることはできない(1)(2)。
自分の案件に当てはめるなら、私はまず「誰が、何をもって完成と決められるか」を確かめる。答えが仕様書とテストに書かれている仕事もあれば、利用者・開発者・運用担当者が話して初めて決まる仕事もある。これは見積もりのために確かめたい違いであり、二つの実験の差の何割を説明したかは分からない。
たとえば「ベテランほどAIで遅くなる」という読み方がある。確かに熟練者が自分のプロジェクトを直した研究で時間は延びた。だが、最初の研究の参加者も職業プログラマーで、完了して調査に回答した人のコーディング経験は平均約6年だった。「初心者には効き、ベテランには効かない」という分け方では最初の研究の参加者をうまく説明できない(1)(2)。
開発歴が12年でも昨日引き継いだ会計画面の事情には詳しくない。逆に職歴2年でも毎朝使う送迎表の変更履歴なら、チームで一番よく知っているかもしれない。一般的な経験年数と、その場所に積み上げた知識を分ければ「すでに答えを知っている仕事では、AIに事情を説明する方が長いのではないか」という検証可能な仮説になる。
もう一つは「2022年のAIの方が2025年のAIより優秀だった」という読み方だ。二つの研究が同じ問題を新旧の道具で解かせていれば、比較の余地がある。実際には道具を替えたのと同時に、課題、参加者、採点、作業環境が替わった。新しい道具に多くの能力があっても、利用者が元から短時間で終えられる仕事を頼めば節約できる時間は小さくなりうる(1)(2)。
反対に「一方は研究用の課題だから参考に値しない」と切り捨てると、何を変えたら速くなるかを観察する機会を失う。全員に同じ説明とテストを与える設計は知りたい違いを絞り込むための工夫だ。業務システムの中にも入力例と正しい出力がすでに決まっている変換処理はある。
実地実験の方もあらゆる現場の縮図ではない。大きなプロジェクトをよく知る人の小規模な改修は、新製品の試作に入るチームとは条件が違う。次の依頼がどちらの条件に近いかを考えると、それぞれの研究を使える範囲が見えてくる。
原因をもう一段調べるなら、一つのチームの中で同じ世代の道具を使い、担当者がよく知る箇所と初めて触る箇所を着手前に区別する。それぞれの種類でAIの使用可否をくじで割り当て、同じ完成条件までを測る。さらに、事情をAIに説明した時間と提案を確認した時間を拾えば、どの工程に差が出たかも調べられる。
もし、慣れた箇所でも説明の手間はほとんどなく、差が確認工程に集中したら、担当者の経験年数より検証手段に注目する理由になる。ただし、担当者がどの仕事に詳しいか自体をくじで決めることはできない。規模や仕様の明確さも近い案件を比べるほど、別の理由で生じた差を見分けやすくなる。
4 続報で数字が変わったとき、何を訂正するか
2025年前半の19%をこれから買う開発ツールの性能表に載せてよいだろうか。同じMETRが2025年8月に始め、2026年2月に途中経過と設計の見直しを報告した調査では以前からの10人と新たな47人が参加し、800件を超える課題のデータが集まった(3)。
以前からの参加者では推定18%短縮、新規の参加者では推定4%短縮だった。ただし95%信頼区間は前者が38%短縮から9%延長、後者が15%短縮から9%延長である。追跡調査ではどちらのグループの区間にも「時間差なし」が含まれる。 同じ続報で2025年前半の結果に添えられた区間は2~39%延長だった(3)。
中心の数字が延長から短縮に変わったなら、以前の報告は間違いだったのだろうか。「2025年前半に対象に選んだ開発者と課題で延長を観測した」という過去の記述は次の調査で消えない。一方、「経験者は今後も必ず遅くなる」とまで述べていたならその一般化は取り下げるべきだ。同じチームが追跡したとしても、参加を選んだ人も、持ち込まれた課題も変わっていた(3)。
続報でとくに考えさせられるのは、実験に申し込まなかった人の存在である。AIが日常の道具になると、研究のために半分の仕事で利用を控えることを望まない人が現れた。参加はしてもAIなしではしたくない仕事を候補に出さなかった人もいた(3)。
研究者が尋ねると、そのように一部の課題を出さなかったと答えた開発者は、調査によって3~5割に上った。これは課題全体の3~5割が除かれたという意味ではない。一つの課題を出さなかった人も、多数を出さなかった人も、人としては一人である。その割合から取り逃した時間の長さまでは分からない(3)。
架空の例で考えよう。旧形式の帳票を20種類変換する仕事に担当者がぜひAIを使いたいと思っている。この仕事を研究に提出すると、半分の確率で手作業になる。そこで、代わりに日常的な小修正を提出する。提出後のくじが完全に公平でも20種類の帳票は初めからくじの箱に入っていない。無作為化が守ってくれるのは、箱に入った後の公平さである。
ここには逆向きの批評も必要だ。担当者が「AIならとても速い」と信じていることと、本当に速いことには隔たりがあるかもしれない。まさにその二つがずれたのが最初のMETRの結果である。
「参加しなかった人ほど効果が大きかったはずだ」と決めれば、2025年前半には疑った自己評価を今度は都合よく客観測定に使ってしまう。しかも時間当たりの協力報酬も変わっている。研究チーム自身、新しい調査によって現在の効果の大きさを確かに測れたとは評価していない(2)(3)。
さらに、AIがあるときに初めて「やってみよう」と思う仕事がある。仮に少人数の事業所が紙の送迎表を見やすくする三案を職員に試してもらえたとする。AIがなければ試作品を一つも作らなかった場合「何時間から何時間へ短縮したか」の出発点が存在しない。
それでも採用前に文字の小ささに気づけたなら、その試作には価値がある。こうした場合は想像上の手作業時間に大きな値を置くより「いくらで三案を比較でき、どの判断が変わったか」を残す方が誠実だ。追跡調査にもAIがあると挑戦する課題の種類が変わるという報告がある(3)。
会社で導入効果を尋ねるときにもこの構図は使える。利用者に「一番うまくいった作業を一件」と頼めば、技術の使い道を探す材料にはなる。翌期の予算に必要な「全体で何時間空くか」に答えるには、最初からAIに回さなかった仕事や途中で担当者が引き取った仕事も要る。成功例を集める調査とすべての依頼が片付く時間を測る調査では、最初に用意する仕事の一覧が違うのである。
5 なぜ「速かった」という実感は真逆の結果とも両立するのか
METRでは着手前に期待した24%短縮、終了後に参加者が推測した20%短縮、申告された実作業時間から推定した19%延長の順に数字を読むとよい。最後の二つはどちらも人が答えた情報に基づく。それでも「この課題に何分使ったか」と「もう一方の条件なら何分で済んだはずか」は違う質問である(2)。
Pengらの調査にも主観的な回答がある。両群とも効果を平均約35%の生産性向上と見積もったが、比較群は課題を終えてから短い紹介動画を見て、使っていたらどうだったかを答えた。使わなかった人の予想まで「使った人の実感」に含めると、数字の意味が変わる。 35%を完了者の所要時間の短縮率からそのまま引いて人が何ポイント過小評価したかを計算するのは避けたい(1)。
作業中に自分が実際に見たものと最後に質問されるものの違いを考えてみよう。開発者は、自分なら一から書く表をAIが十数秒で表示するのを見る。一方、その表を採用したために後で確認箇所が増えたのか、手書きでも同じ確認が必要だったのかは直接には見えない。
ある仕事をAIありで一度終えた瞬間に、その人がAIなしで同じ仕事を初めて解く機会は失われている。終了時の質問は目撃した一日の感想に加えて、経験しなかったもう一日の長さまで推測させている。
それでも実感には時計が教えてくれない中身がある。Barkeらは20人のプログラマーがコード生成ツールを使う様子を観察し、使い方を大きく二つに整理した。進み方をすでに知っていて入力を早く済ませたい場面と進み方を見つけるために候補を出させる場面である。これは、各場面で全開発者が何分得るかを推計した研究ではない。だが「役に立った」と答えた人が何を指しているかを聞き直す手がかりになる(4)。
たとえば一人で作る管理画面で日付をまたぐ予約だけが一覧から落ちるとする。原因の見当がつかない開発者がAIとの対話で「保存した日付」と「画面上の日付」を分けて調べる方針を得た。人手なら15分で同じ方針にたどり着いたかもしれず、AIには説明を含めて20分かかったかもしれない。
それでも「行き詰まったところから次に試す方法が分かった」という感想には事実がある。5分長くかかったことと手が止まった状態を解消できたことは一緒に起こりうる。依頼者が今知りたいのが納期か、開発を続けられる見込みかでこの5分の意味は違う。
逆に、AIが一瞬で候補を出して気持ちよく書き進められた日に、自分がどれだけ検証を省いていたかは翌日まで気づかないことがある。こうした可能性を語るだけではMETRの結果の説明にはならない。録画で確かめられたのは、手でコードを書く活動の割合が減り、生成物の確認や指示の活動が加わったことまでだ(2)。
楽だった記憶が強く残ったのか。AIなしで要したはずの時間を長く見積もったのか。同じ変更を普段より丁寧に仕上げたのか。どれも考えられるが、それぞれを単独の原因として切り分けた実験ではない。
そこで私は「今日はAIで速かったですか」と一度で尋ねる代わりに、「どの場面で作業を進められたか」「後で読み直したのはどこか」を聞きたい。記録上の時間は同じでも、決まった処理を打ち続けたのか、三案を比較して根拠を残したのかで次の判断が違う。
前者の繰り返しなら、定型処理を任せる価値を測れる。後者の比較が後日使えるなら、判断の記録も成果に含める理由が生まれる。本人の感覚を所要時間の代わりに使うと両方の意味がぼやける。所要時間を記録したうえで、その内訳を本人に聞く方が、何を改善すればよいかが分かる。
6 (架空事例)火曜日の迎えを30分遅らせる
冒頭の送迎表に戻ろう。以下は仕組みを考えるための架空の事例である。
火曜の朝、利用者Aさんから「今日は9時半に迎えに来てほしい」と電話が入る。普段の迎えは9時。受付の職員は変更を記入し、運転担当が出発前に見る当日の一覧と事務室で印刷する紙にも反映させたい。依頼文を「利用者の迎え時刻を編集できるようにしてください」と書いてAIに渡すとどこまでが正解だろうか。
簡単な実装の一つは、利用者の登録情報にある「9:00」を「9:30」に更新する方法だ。職員が保存して今日の画面を開き直せば希望どおりに見える。ところが来週の火曜も同じ情報を読んでいれば、そちらも9時半になる。先週分を印刷し直したときまで9時半になれば、過去の予定を調べる用途にも影響が出る。
今日の画面に正しい数字が一度出た。これは、意図した機能ができた場合にも普段の時刻を誤って上書きした場合にも起きる。開発者がその画面だけを見て時計を止めれば、どちらを作ったのか判定できない。
私なら実装の前に時刻を三つ並べた例を施設に返す。「先週の火曜は9時。今日だけ9時半。次の火曜は9時。この並びでよいですか」。職員はデータベースの設計を知らなくても答えられる。
ここで「今日の出発前なら変更できるが、出発後の訂正は区別したい」と返ってきたら、その運用を含めるかを改めて決める。一方、「そこまでは要らない。まず今日配る紙だけ正しくしたい」という答えもありうる。どちらの返事も、依頼主にしか決められない仕組みの境界を一つ確定させる。
この対話に時間を使ったことをそのままAI導入の損とは数えられない。手書きで登録画面を直す開発者にも必要な確認だからである。むしろ最初に実装を出さず、AIに「この依頼から考えられる運用を二つ、職員が答えられる質問に直して」と頼む選択もある。
週をまたいだ違いに気づくきっかけを作り、打ち合わせの往復が一度減ればコードを一行も書かせない段階で開発は速くなる。これは二つの主研究では直接試していない使い方だ。効果を確かめるなら、質問の候補を何件出せたかより仕様の誤解でやり直した件数を追いたい(1)(2)。
話を絞るためこの施設は「指定した日の迎え予定だけを変える。ほかの日とすでに確定した過去の予定は保つ」と決めたとする。当日の一覧とその時点で新しく印刷した紙は一致させる。すでに車に持ち出した紙をどう差し替えるかは現場が決め、システムは紙に印刷時刻を出す。これで職員は手元に二枚の紙があったとき、どちらが新しいかを照合できる。
開発者が扱うのは、まず「毎週の標準時刻」と「その日だけの変更」である。当日の一覧では指定日の変更を優先し、変更がなければその日に有効な標準時刻を使う。画面と印刷が同じ決定に従えば、今日の予定をそろえられる。
ここで見落としやすいのが過去分の再印刷だ。常に最新の標準時刻を読む実装だと、標準を後から変更しただけで例外のなかった先週の帳票まで書き換わる。「毎週の標準」と「一回限りの変更」を区別しただけでは、過去の記録が保たれるとは限らない。
この施設では「確定した過去の予定は保つ」と決めた。ならば日付ごとに確定時の値を残すか、いつからどの標準時刻が有効だったかを記録し、当時の状態を再現できるようにする。どちらを選ぶかは既存の記録方法に合わせればよい。依頼者が合意したのは過去の正しい予定を再現できることである。
次に、架空の利用者と三つの火曜で答え合わせをする。一つ目の試行では、先週は9時、今日だけ9時半、次週は9時。今日の変更を取り消せば今日は9時に戻り、次週に影響しない。印刷見本も同じデータで確認する。
二つ目の試行では、今日を9時半のまま確定し、その後、来週から標準時刻を8時50分に改める。再印刷した先週は9時、確定済みの今日は9時半、来週は8時50分なら合格だ。「今は正しく出る」と「後から同じ記録を再現できる」は別々に試せる。
ここまで具体例があれば、AIの提案を試すたびに職員へ電話する必要はない。この点は正否を手元のテストで確かめられたPengらの課題に近い。似ているのは作る機能の種類より、答え合わせの条件だ(1)。
逆に一覧画面と印刷機能が過去の事情で別々に時刻を読んでいたらどうか。画面だけを確認するデモでは修正が終わったように見える。過去に両者を分けた理由を知る担当者は印刷の側もたどってから変更する。この事情を知らないAIの変更案を読む人は直した箇所が少なすぎる可能性と、余計な箇所まで広がった可能性を調べる必要がある。
これは、成熟したソフトウェア固有の暗黙の前提が影響した可能性を挙げるBeckerらの考察と重なる。ただし、送迎表は本稿の設計例であり研究の参加者がこの業務を扱ったわけではない(2)。
答えが決まり、過去の例も用意され、関係する箇所が特定された後なら複雑に見える改修でもAIの方が得な場合がある。反対に、入力欄を一つ増やすだけに見えても、誰がどの時点の紙を正とするかが決まっていなければ人への確認が続く。同じ依頼でも午前の仕様確認と午後の実装では、AIに任せる意味が変わるのである。
7 手書きより何分早ければ確認に時間をかけても得か
送迎表の変更を同じ合格条件で終えると仮定しよう。ここでの時間は計算のために置く架空の値である。一人の担当者が順番に作業する。
通常の方法では仕様や既存の仕組みを確かめるのに25分、変更を書くのに45分、合意した動作を試すのに30分かかった。合計100分。AIを使う場合も最初の25分と最後の30分は同じと仮定する。
AIに指示を出して実装案を得るまでに、待機込みで18分。自分で書くときより余分にかかる読み直しと手直しが12分だったとする。合計は25+18+12+30=85分。通常の手順の100分と、同じ完成条件までを比べている。
この仮定では、実装案を用意する時間は60%短縮、合格までの総時間は15%短縮である。実装の45分が18分になった差は27分だが、そのうち12分は追加の確認に使った。依頼者に約束できる時間を考えるならまず差し引き後の15分を見る。
この例で判断が変わる境目は27分である。実装案で節約した45-18=27分を追加の読解と手直しが上回れば、総時間は延びる。共通の30分のテストを「AIが書いたから必要になった」としてもう一度差し引けば、AIの負担を水増しする。
反対にAIの案はそのまま通し、自分で書くときだけ30分確認するなら、時短の中に検査を取りやめた効果が混じる。比較する二つの進め方で同じ値を引けるかは、工程名より実際に同じ仕事をしたかで決まる。
では同じ施設の担当者が以前にも何度か直した印刷欄を少し変更する場合はどうか。通常は25分の事前確認、12分の実装、30分の最終確認で67分とする。AI側では実装案が10分、追加の読解が7分なら合計72分で5分延びる。
改修内容の見た目が大きく似ていても、今度は元の実装に12分しか使っていない。AIの案の見栄えが前の例と同じでも節約できる時間はもともと少ない。METRでよく知っている課題ほど遅くなる傾向を示した一部分析を読むときにも、この違いは一つの説明候補になる。ただし、研究では担当者がその仕事にどれだけ詳しいかだけをくじで変えたわけではない(2)。
この分け方には例外もある。AIが実装中に既存のテストを見つけてくれた結果、最後の確認の30分も減るかもしれない。反対に、最初の25分で決まったと思っていた仕様の食い違いを見つけ、一度職員に聞き直す必要が生じるかもしれない。
前者では節約の範囲が広がり、後者では不具合を早く見つけた価値が増す。こうした仕事を「実装時間以外は一定」という仮定のまま評価し続ければ、自分で作った計算式が改善の発見を邪魔する。式は次にどこの時間を取り直せば結論が変わるかを見つけるために使いたい。
もう一つ、裏で動くAIには別の時計が要る。朝9時から5分で指示を出し、AIが9時半まで作業する間、担当者は25分すべてを別件の見積もりに使った。その後10分で変更を確認すれば、送迎表の案ができたのは9時40分である。
送迎表に人が使ったのは15分、確認済みの案が返るまでに過ぎたのは40分だ。 別件にも25分使えた。40分と25分を足して「担当者が65分働いた」とするのは二重計上だ。しかし利用者は9時15分に完成品を受け取れたわけでもない。人の余力を問うときは15分、仕事が返るまでを問うときは40分が必要になる。複数のAIを同時に動かす人の作業時間をどう扱うかはMETRの続報でも測定上の問題として挙げられている(3)。
もし25分の間、失敗するかもしれない処理を見守って席を離れられなかったら、同じ時刻表でもほかの仕事に振り向けられる時間は減る。AIが動いている25分を「空いた時間」と呼べるかは自分の注意を別に使えたかで判断したい。
自動化で人件費が浮いたという提案を受けたときにも私はその25分で担当者が実際に何をしたかを尋ねる。コード生成の速さだけを並べた比較には、その答えが含まれていない。
8 開発者の手が空いた日と利用者に届く日は一致するか
現実の職場ではどんな成果が観測されたのか。CuiらはMicrosoft、Accenture、社名を公表していない大企業で開発者の一部にコード補完ツールの利用権を無作為に割り当てた三つの実験を分析した。対象は計4,867人である(5)。
利用権を渡しても全員が使い始めるわけではない。著者らは割り当てが実際の利用に生んだ差を使って、利用による仕事の完了件数の変化を推定した。3社を合わせた推定は26.08%増だったが、各社の結果にはばらつきがあった(5)。
一件と数えたのは完了したプルリクエストである。プルリクエストとは変更案をひとまとめにして、本体への取り込みを依頼する仕組みだ。研究では開発者一人につき一週間に何件完了したかを数えた。週当たりの変更件数が増えたことと、同じ改修が短時間で終わったことは別の成果である(5)。
この研究は、企業で働く人が一定期間に仕上げる変更が増えうることを示した。一方、Beckerらが調べたのは課題一件に開発者が費やす時間である。週に扱う仕事が増えても、一件を届けるまでに依頼者が待つ日数は延びる場合がある。件数から納期を論じるには、一件の規模、完了待ちの仕事、実際の提供日について、もう一段の記録が要る(2)(5)。
たとえば送迎表の対応を「当日の編集」「紙への反映」「過去分の確認」と三つに分けて提出した開発者と一つにまとめた開発者がいる。どちらも仕様どおりに完成し、職員が受け取る機能は同じでも数えられる変更件数は3対1になる。
だから件数という指標を捨てるべきだろうか。私はそうは思わない。同じチームがおおむね同じ切り方で続けるなら、日常的に仕上げる仕事がどの程度変わったかを広く追える。ただし、件数を人事評価や受託単価にそのまま結びつければ、小さく分けるだけでも有利になる。集計しやすいことと、仕事の分け方に左右されることは、同じ指標の性質である。
2026年9月改訂のDemirerらの研究は、さらに利用者に近い段階まで指標を変えている。50万人を超えるGitHub開発者の記録とAIの利用履歴を組み合わせ、似た条件の人を対応づけ、導入の前後を比べた(6)。
複数世代の道具の導入を通じた累積の推定は、自律的に作業を進める道具まで含めた段階でコード変更を記録した回数が約240%増、取り組んだプロジェクト数が約80%増、公開リリース数が約30%増だった。同じ240件の変更を追いかけて最後に30件だけが残ったという集計ではない。それぞれ別の指標を各指標の基準と比べた増加率である(6)。
この研究は仕事ごとに利用をくじで決めた実験とも異なる。よく似た人を比べても、大きな仕事に取りかかるから道具を導入した、といった観察しきれない違いが残りうる。また、ソフトウェアには公にリリースせず組織内で何度も改善するものもある。リリース件数で測れない価値までゼロにはできない。
それでも利用が広がればコードの変更、プロジェクト、公開がすべて同じ倍率で増える、という期待を見直す材料にはなる。なおCuiら、Demirerら、冒頭のPengらの研究には共通の著者もおり、対象と指標も異なる。数字が三つ並んだことを同じ問いに対する三組の独立した再現実験と数える理由はない(1)(5)(6)。
送迎表で考えよう。現場の確認会が金曜の午後だけなら月曜のコード完成が昼から朝へ早まっても、使い始めは金曜のままかもしれない。一方、金曜の確認会に15分だけ間に合わず、次回に回りそうだった案件なら同じ15分で利用開始が一週間早まる可能性がある。
時間がどこで縮んだかと次の工程に入れる時刻を組み合わせなければ、納期への影響は読めない。確認会を随時開ける職場なら、この例の効果は消える。職場ごとに尋ねたいのは、「実装が速いですか」に加えて、「次の人はいつ、その成果を受け取れますか」ということだ。
開発の予算を預かる立場なら、AIによって増えた変更案がレビュー待ちに積まれているのか、現場に届く変更まで増えたのかを同時に見たい。前者なら次に手を入れる候補は担当者が一度で判断できる大きさに変更を分け、確認に必要な説明をそろえることだ。後者ならAIをもう少し広い範囲の仕事で試す根拠がある。どの段階で仕事が滞っているかによって、同じ予算の使い先が変わる(5)(6)。
9 今日の合格と翌月に直せることを分けて調べる
送迎表の変更をAIと人がそれぞれ仕上げ、双方とも約束したテストに通ったとする。どちらにも同じ一件を数えてよいだろうか。今日職員が使う機能という点ではよい。
ただ、翌月「曜日によって迎え場所も変えたい」という依頼が来たとき、別の担当者がどこを直せばよいか理解できるかは今日の合格だけでは分からない。逆に、将来に備えてあらゆる例外を盛り込み、今は頼まれていない構造を複雑にしてしまうのもコストになる。「品質が高い」という一語ではその二つの負担は区別できない。
この時間差を考える材料として、ShenとTamkinの実験がある。参加者は
Pythonの不慣れなライブラリ、つまり他の人が用意した部品を使ってプログラムを書き、その後、概念の理解やコードの読み取り、不具合の判断を問う問題に取り組んだ。主要実験で全段階を終えたのは53人である(7)。
AIを使えた群の完了時間には統計的に明確な改善を確認できず、事後の小テストは27点満点で平均4.15点低かった。ここで実験が捉えたのは初めて学ぶ部品を使った課題を終えることと、その直後に仕組みを説明できることの違いである。若手がAIを使い続けた場合の数年後の技能まで追跡した研究ではない(7)。
私がここから受託開発に持ち帰りたいのは、引き継いだ開発者が「今日だけの変更はどこに保存されるか」「朝の一覧に誤った時刻が出たら何を比べるか」を自分の言葉で説明できるかという問いだ。この二問に答えられる人がいれば障害時の最初の確認ができる。
答えられなければ残されたテストの名前や変更理由を読み直す。詳細な設計書を毎回作る前に、次の人が必要とする判断を実際に一度頼んでみる。それで足りるなら引き継ぎは軽くて済むし、足りなければ何を書き足すべきかが分かる。
もちろん、AIとの対話が理解を助ける使い方もある。担当者が先に「標準時刻を更新すれば済む」と考え、AIにその考えが破れる具体例を一つ求める。翌週の予定まで変わる例を得て、自分で二週分のデータを作ってみる。ここで残るものはなぜ一つの値を二つに分ける必要があったかという理解だ。
Shenらの観察にも使い方によって理解度の異なる傾向が見られる。ただし、利用者の質問の仕方まで無作為に割り当てたわけではない。「この聞き方をすれば誰でも必ず学べる」という効果量までは示されていない(7)。
もう一つ、速さに有利な評価期間になっていないかも調べたい。金曜に検収し、翌月曜に最初の実運用があるとする。金曜までだけを集計すると、印刷で崩れた行を月曜に直す仕事は両方式ともゼロに見える。かといって、何年先の不具合もこの変更の責任として足せば比較は終わらない。
私なら次の一回の送迎サイクルを含む期間を先に決め、その間に変更との関係を確認できた手戻りと、もともと予定していた追加要望を別に残す。原因が調べきれないものにはそのまま「関連未確認」と書く。単純な不具合件数より、次の案件の見積もりに使いやすい記録になる。
ForsgrenらのSPACEは、開発者の生産性を活動量だけで測ると結果の質、働く人の満足、協働、作業の流れといった要素を落とす問題を整理した。AIの時短率を示す研究ではないが、「速さの数字を一つ選んだら依頼者と開発者のどちらが何を失うか」を考える根拠になる(8)。
すべてを点数にまとめる必要はない。私ならこの例では検収までの作業時間を主にし、誤った日の変更を一件も通さないことを採用の条件に置く。担当者の理解は引き継ぎの二問に答えられるかで別に確かめる。こうしておけば利用者Aさんの翌週の迎え時刻まで書き換えた実装が「生成が速かったから総合点は合格」になることを防げる。
10 自分の仕事で二つの研究を小さくやり直すなら
論文を読んだ依頼者から「では、うちでは何%ですか」と聞かれたとする。私なら最初の一週間で答えの数字を約束するより、次の仕事から何を記録するかを提案する。「このチームで来月も繰り返しそうな仕事のうち、どれなら完了までの人手を減らせるか」。この問いなら小さな試行でも次の選択に役立つ答えを作れる。
Pengらから取り入れたいのは完成と言える条件を先に明らかにすることだ。Beckerらから取り入れたいのはこれから取り組む仕事を決め、その後で
AIの利用可否を割り当てることだ。両方を合わせるとAIがうまくできた仕事だけを終わってから選んで見せることを避けやすい(1)(2)。
まず、一つの案件の中で、画面の定型変更、既存処理の修正、不具合の原因調査を混ぜて一括にしない。着手する前の仕事一覧から公開用に作った例題か、いつもの品質確認ができ、変更の影響が小さい仕事を選ぶ。
各件に「できたと言える具体例」「既存部分で壊してはならないこと」「通常どおりだと何分くらいか」を一行ずつ書く。機密の実データを使わなくても、三つの日付や二つの権限の違いを仮の値で確かめる仕組みは作れる。結果を公開するなら架空データの検証なのか、実務の集計なのかも添えたい。
担当者一人が両条件を試すとき、先週手で解いた課題を今週AIで解き直すのは簡単だ。ただ、二回目の自分は一回目に苦労して特定したファイルの場所を知っている。順番を逆にしても今度はAIに教わったことを人手の条件へ持ち込む。
そこで、たとえば同種の帳票にある異なる変更を難しさの見立てごとに二件ずつ組にし、組の中でどちらにAIを許すかをくじで決める。担当者と仕事の種類をできるだけそろえつつ、同じ答えを覚えている影響を減らせる。二件の難しさが偶然ずれる余地はあるので、結果は何組分かと一緒に示す(2)。
完了の判断が担当者の期待に引っ張られる場合には、他の人が読める短い判定例を先に残す。送迎表なら「例外を保存した後、今日の紙は9時半で、翌週は9時」と書ける。できれば確認する人にはAI利用の有無を伏せ、同じ例で判定してもらう。
一人開発で別の人を用意できなければ事前に作った期待値と実際の表示を突き合わせる。途中で依頼者が新しい希望を出したら、新しい条件に変わった時刻を記録する。一方の試行でだけゴールを遠ざけたのに遅くなった理由を道具に求める誤りを避けられる。
記録は一件につき短くてよい。たとえば「当日の時刻変更。AI利用可。担当者45分、同僚の確認8分。受け取りは翌日。合格。翌週の手戻りなし」と残す。担当者と同僚を足した53分はチームが使った労働時間だ。依頼者が待った一日とは目的が違う。
同時進行した別件は別に記録し、AIの可否にかかわらず同じ区切りで時計を止める。候補を試して失敗した時間まで集めれば、検収できた一件当たりの負担も計算できる。
AI利用可と利用不可のそれぞれで同じ観察期間に始めた全試行の時間を足し、そのうち合格した件数で割る。合格がゼロなら一件当たりの時間は計算できない。投入時間と未完了件数をそのまま記す。「完成したものだけが台帳に載る」という偏りを残さないためである。
特に大事なのが、途中で人が引き取った仕事だ。AIと20分ほど対話した後、これ以上は難しいと判断し、人が30分で仕上げたとする。「最終的に手で書いた」という理由で50分すべてをAIなしに付け替えればAIに挑戦した時間が帳簿から消える。
途中で手作業に切り替えても、その時間は最初の割り当てに含める。 ここでは利用可の仕事に50分を計上し「20分でAIとの対話を切り上げた」と書く。期限で打ち切り、完成さえしなかったら成功一件として数えず、投入時間を残す。チームでAIを使えるようにする判断には、うまくいかなかった試行を含む記録が要る。どんな使い方なら成功したかを調べるときには、そこから個別の経過を読む(1)(2)。
集計では平均の見かけが逆転する例も押さえたい。以下は架空の数字である。簡単な仕事は人手40分でAIあり32分、難しい仕事は人手120分でAIあり108分とする。同種の仕事を比べれば両方とも短縮だ。
ところが先月の人手が簡単4件・難しい1件なら、平均は56分。今月のAI利用が簡単1件・難しい4件なら平均は92.8分になる。総平均だけを見た会議では「AIで大幅に遅くなった」と報告できてしまう。逆にAI側へ簡単な仕事を寄せれば、実力以上によく見せることもできる。計算は合っている。比べている仕事の構成が違うのである。
同じ例を来月は簡単と難しい仕事が半々と見込んで、同じ比率にそろえてみる。人手は平均80分、AIありは70分、短縮は12.5%になる。この数字が役立つのは仮定した仕事の構成が来月の見込みに合うときだ。
「今月に実際に何時間を使ったか」と「来月が同じ仕事の構成ならどれだけ変わるか」をそれぞれ計算する。そうすれば、今月は難しい仕事が多くて忙しかったという現場の体験と、同種の仕事ではAIが役立ったという結果の両方を説明できる。METRで単純比較と難しさを考慮した推定に差があったことを小さなチームでも実感できる例だ(2)。
数件で結果が大きく動いたら、まず一件ずつの時間と理由を見る。特に長かった試行を除くと結論が変わるか、その試行が来月も起こりそうかを別々に考える。前者は集計の安定性、後者は事業上の重要性である。
まれでも起きれば納期を逃す案件では、平均が少し良くなっても発注時に約束できる日付は動かしにくい。反対に、やり直しが安く、翌日に持ち越せる社内の試作なら、小規模な好結果でも試用範囲を広げる判断はできる。一律に「何件成功したら採用」と決める前に、その判断を間違えたとき誰が何を失うかを考えたい。
11 15分の時短で値段をいくら下げられるか
架空の送迎表の改修は担当者一人の作業が100分から85分になった。依頼者から「時間が15%短くなったら価格も15%下がりますか」と聞かれたとする。私はまずその15分が見積もりのどの部分に含まれているかを確かめる。打ち合わせ、納品準備、依頼者の確認待ちに同じ割合を掛ける根拠はまだない。
担当者が自分の時間を仮に1時間4,000円と評価した場合、空いた15分は1,000円相当だ。案件にだけかかったAIの利用料が150円なら、差は850円相当になる。4,000円はこの計算用に置いた値で料金相場を表すものではない。
空いた時間を金額に換算した段階では利益はまだ増えていない。 個人事業主がその15分を使って追加の依頼を納品したなら、実際に増えた代金と費用を記録できる。別の案件を入れず早く仕事を終えたなら、自分に戻ったのは15分の自由時間だ。どちらにも価値がある。だが、翌月の売上見込みに計上できるかどうかは違う。
一方、本当に支出が減る場合は回収件数を計算できる。以下はすべて架空の金額である。従来、作業時間に応じて外部に支払っていた費用が一件1,000円減り、ツールに月額3,000円と一件150円がかかるとする。ほかの費用が同じなら、一件当たり850円の削減になる。月3件では月額を賄えず450円の持ち出し、4件なら差し引き400円の支出減である。
同じ仕事でも新たに別の人へ一件600円のレビューを発注するなら一件当たりの削減は1,000-150-600=250円。月12件で月額と釣り合い、13件目から支出が従来を下回る。ここで引く600円はAIを使う場合にだけ別の人へ支払う費用だ。前から両方式で行っている確認は二重に差し引かない。
最初の例に戻ると、月4件で400円の支出減という計算にはどれほど余裕があるだろう。その4件のうち一件で納品後の手直しに追加の外注費1,200円が一度発生すれば、その月は差し引き800円の支出増に変わる。回収を判断するには検収した日に採算表を締めず、納品後に支払った金額もその案件の記録に戻す必要がある。
自分一人で作り、外注費も残業代も減らないなら出発点の「1,000円の支出減」が成立しない。月4件・12件という回収ラインもその事業には移せない。来月ツールを契約するかを決めるときは実際に消える支出、増える支出、空いた時間の使い道を別々に書き出したい。
発注者の側から見れば、同じ金額でも朝の変更がきちんと紙に載り、翌週に誤りを残さないことには価値がある。完成が一週間遅れれば、その間は従来どおり人が紙を書き直す。「送迎表の一覧と紙を照合する作業をどの程度減らしたいか」を先に聞ければ、最も早く届けるべき範囲が見えてくる。
多数の利用者の時刻を一括変更する管理画面より、当日の一件を正しく直せる小さな変更を先に検収したい、という答えもある。コード生成を速くした価値が生まれる場所は発注者が一日のどこで困っているかによって変わる。
同じ時短でも依頼者への返し方は契約と案件で変わる。合意した一式の金額で引き受けるなら変更の範囲と検収条件を示し、次回以降は実測できた工程の見積もりを更新できる。実作業時間に応じた料金なら請求対象の作業時間が減れば、その合意に沿って請求額に反映する。利用ツール名だけから一律の割引率は決まらない。
送迎表なら日付別のテストと印刷見本を次回も使えることは、短く見積もれる具体的な理由になる。新しい運用を決める打ち合わせについては職員の判断にどれだけ時間を取るかを別に伝える。速くできる範囲を示すことで、依頼者は「何にお金を払うか」を自分でも判断できる。
時間そのものへの投資も同じ考えで検討できる。帳票の比較を自動化する準備に2時間、以降の同種改修は一回15分短縮、維持の負担は変わらないと仮定すれば、8回で準備時間を回収する。一度きりの案件と毎月同じ変更を繰り返す案件では同じ技術の値打ちが変わる。ここで回収している単位は時間であり、8回目に現金収入が生じるという意味ではない。
私なら月末にはツールを使った回数と検収を通った同種改修の件数を並べる。利用料を払っていても確認待ちが増え、納品件数も外注費も変わらなければ、次に試すのはレビューの詰まりを解く方法だ。実際の支出が減り、納品後の手戻りも増えていなければその種類の仕事に予算を広げる。
経営者にとって71分や19%という研究の数字は試行の候補を選ぶ根拠にはなる。予算を継続する根拠になるのはその後に自社で何を、いくらで、いつ引き渡せたかである。
12 次の一件でどちらの研究を使うか
発注者からの最初の質問に戻る。「AIで作るならこの送迎表は速くできますか」。依頼書が一行だけの段階で、私なら完成日を半分にするとは答えられない。しかし「分かりません」で終える必要もない。
今日・来週・過去の三つの予定がどう振る舞うかを先に確かめ、既存の画面と紙が時刻をどこから読むかを調べる。そのうえで例外を保存する処理と表示のテストは同じ条件にそろえてAIあり・なしの時間を比べられる。依頼者には今答えられる部分とあと一つの確認で答えられる部分を具体的に返せる。
目的の動作が決まっており、ひな型と繰り返し実行できるテストがある案件なら、Pengらの結果を小さく試してみる根拠にする。既存の仕組みを長く担当する人に改修を頼むならBeckerらの結果を踏まえ、事情の説明と出力の確認に使う時間を測る。二つの結果の使い分け方は、案件を丸ごと「AI向き」「AIに不向き」と判定することより、一件の中のどの工程で見積もりを取り直すかを決めることに近い(1)(2)。
どちらでも、まずそろえるのは同じ品質で引き渡すまでに誰が何分を使ったかだ。次に、空いた時間で納品が前倒しになったのか、外部への支払いが減ったのかを見る。自分の案件でどの数字が動いたかが分かれば初めて次の見積もりを変えられる。
私の見立てに対する最も強い反論は、AIの性能や使い方が変わればこれまで負担だった確認もAIが引き受けられるというものだ。十分ありうる。送迎表の詳しい設計を与えなくてもAIが既存のテストと印刷機能を自分で見つけ、三つの日付の違いを正しく示し、担当者の確認まで短くできるなら、の仕事では評価を上方に変える。
逆に、テストが明確な定型作業でも出力の読み直しが繰り返し節約分を食うなら「条件が明確なら向いている」という期待を下げる。新しいモデルの名前が発表された日より、同じ完成条件で自分の記録が変わった日の方が見積もりを改める理由になる(2)(3)。
71分と161分の間にあった約90分は共通の課題を完了した二つの集団の平均差だった。19%長かった時間も自分のソフトウェアに変更を届けようとした開発者の仕事から得た推定である。両方の結果を読んだあと、次の現場で最初に確かめるべきことは案外小さい。
火曜の紙には9時半と印刷され翌週の火曜は9時のままか。それを確かめたのは誰で、依頼を受けてから何分かかったか。AIで開発が速くなったと言いたいとき、私ならその一件の記録から話を始める。
参考文献
(1) Peng, S., Kalliamvakou, E., Cihon, P., and Demirer, M. (2023). “The Impact of AI on Developer Productivity: Evidence from GitHub Copilot.” arXiv:2302.06590v1, 2月13日公開。実験手順、計時方法、完了者の集計は「Study Design」「Results」を参照。
(2) Becker, J., Rush, N., Barnes, E., and Rein, D. (2025). “Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity.” arXiv:2507.09089v2, 7月25日改訂。割り当てと計時は第2節、主結果と録画分析は第3節、説明候補と推定法は付録C・Dを参照。
(3) Becker, J., Rush, N., Cunningham, T., Rein, D., and Mahamud, K. (2026). “We are Changing our Developer Productivity Experiment Design.” METR, 2月24日公開。2025年後半の追跡調査と参加者・課題の選ばれ方についての研究チームの報告。
(4) Barke, S., James, M. B., and Polikarpova, N. (2023). “Grounded Copilot: How Programmers Interact with Code-Generating Models.” Proceedings of the ACM on Programming Languages, 7 (OOPSLA1), Article 78. DOI 10.1145/3586030。コード生成ツールを使う20人の行動を観察した質的研究。
(5) Cui, K. Z., Demirer, M., Jaffe, S., Musolff, L., Peng, S., and Salz, T. (2026). “The Effects of Generative AI on High-Skilled Work: Evidence from Three Field Experiments with Software Developers.” Management Science, 72(11), 9408–9420. DOI 10.1287/mnsc.2025.00535。3社の実験を統合し、開発者一人・一週間当たりの仕事の完了件数を分析。
(6) Demirer, M., Musolff, L., and Yang, L. (2026). “Writing Code vs. Shipping Code: Productivity Effects Across Generations of AI Coding Tools.” NBER Working Paper No. 35275, 5月公開、9月改訂版。開発活動と公開リリースで異なる推定値を扱う観察研究。
(7) Shen, J. H., and Tamkin, A. (2026). “How AI Impacts Skill Formation.” arXiv:2601.20245v2, 2月1日改訂。主要実験の完了時間と理解度の差は第5.2節、使い方による違いは第6節を参照。
(8) Forsgren, N., Storey, M.-A., Maddila, C., Zimmermann, T., Houck, B., and Butler, J. (2021). “The SPACE of Developer Productivity: There's More to It Than You Think.” ACM Queue, 19(1). DOI 10.1145/3454122.3454124。開発者の生産性を複数の観点から捉える枠組み。
文献の最終確認日:2026年11月20日