追加の学習をせず、既製の物体検出モデルと領域の指定だけで、立入禁止区域への侵入を検知するPoCを作りました。
最初にお断りしておくと、これは特定のお客様のために作ったものではなく、私たちが社内で試作した社内PoCです。作ったのは2026年7月で、確認に使ったのも手元のデモ映像だけです。現場に導入した実績の話ではありません。
何を作ったか
倉庫や生産エリアの立入禁止区域は、常駐の警備員か、何かあった後のカメラ映像の確認で管理されている現場が多いと思います。防犯カメラは録画を続けても、自分から知らせてはくれません。映像を見返して初めて、あの時もう入っていたと分かります。
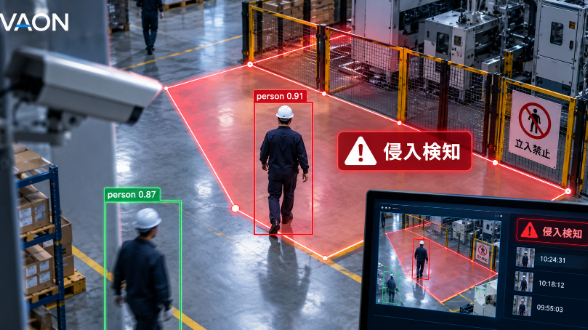
今回作ったのは、人が立入禁止区域に入ったその瞬間に、画面でアラートを出す仕組みです。越えたフレームで検出枠の色が変わり、「侵入アラート」のバナーが出ます。録画をあとからまとめて処理した結果ではありません。
「機械の周りには入らないこと」は、人に向けた言葉です。システムに渡すには、カメラのフレーム上で立入禁止区域を多角形の座標として定義する必要がありました。検出した人物の中心点を1フレームごとにその多角形と照合して、区域の内側にいるかどうかを見ています。画面のどこかに人が映っただけの場合と、区域に入った場合を、これで分けられます。
なぜ追加学習をしなかったのか
使ったのは、人と車両という一般的な2クラスを認識する、事前学習済みの物体検出モデルです。設置場所ごとに映像を集めてラベルを付け、学習し直すことはしていません。
人や車両の検出は、汎用のモデルですでによく解けている課題です。そこに専用モデルを作っても、得られるものはあまり増えません。データ集めとラベル付けの期間が足されて、結果が見えるまでが遠くなります。試作の段階では、それがいちばん困ります。
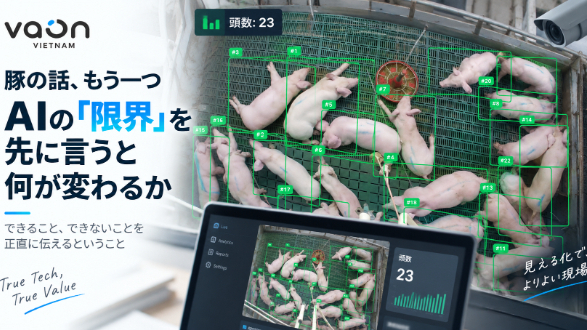
追加学習が見合うのは、もっと特殊な対象を扱うときだと考えています。私たちが別のPoCで取り組んだ家畜の頭数カウントは、そちらの側でした。同じ画像認識でも、学習し直しが要る課題と要らない課題があります。最初にその線を引いておくと、進め方がかなり変わります。
学習を挟まないので、既存のカメラの画角のまま動かせる点も、この方式の利点でした。
実際に動かして分かったこと
デモ映像では、近距離で照明が十分な場面で、人物の検出信頼度が88〜93%でした。人が区域の線を越えたフレームでは、アラートが同時に出ています。距離が離れて人物がフレームから一部外れる場面では、信頼度は55〜57%まで下がりました。
数字は丸めずに、映像に表示されたラベルをそのまま読み取っています。ただ、これはモデルが出す信頼度です。正解データと突き合わせて測った精度ではないので、「88〜93%の精度で見つけられる」という意味には取らないでください。
同じ人物でも、距離や映り方で信頼度がここまで変わります。画面全体に同じ基準を当てる作りには、無理があります。
限界(照明、カメラ角度など)
映像で確認できていないことを、先に挙げておきます。
照明については、近くて明るい場面しか数字がありません。夜間や赤外線カメラの映像では、動きを見ていません。
カメラの位置と角度にも左右されます。遠い人物の信頼度が下がったように、監視したい範囲の全体で高い信頼度を保ちたいなら、モデルに手を入れる前に、カメラをどこに付けるかの検討が先になります。判定に人物の中心点を使っているため、斜め上から見下ろす配置では、区域の手前に立つ人の上半身が画面上で区域に重なる場合もありそうです。デモの画角では越境のタイミングと合っていましたが、別の位置のカメラで同じようにいくかは分かりません。
車両は、同じ仕組みで認識できる見込みです。ただ、手元のデモ映像には人物の場面しか入っていないので、車両で動くとは言えません。時間帯で検索できる管理画面や、スマートフォンへの通知も、設計までで、動いている様子は映像で見せられる状態にありません。
確認できたのは、リアルタイムの検出と、区域に入ったフレームでのアラート表示までです。それ以外は、この先に試す部分として残っています。
要件がまとまっていなくても構いません。状況を聞かせてください。出品サービスのページからご連絡いただけます。