仕入先から届いたCSVに「数量」が2列ある。ファイルでは3と8が見えているのに、Pythonで読み込むと8しか残らない。こんなときは、元ファイルを直す前に読込方法を確かめます。
今回扱うのは、同じ列名が複数あるCSVをcsv.DictReaderで辞書にする場面です。列名が見つからないエラーや、データ行の重複とは別の問題です。
この記事では、Pythonで確かめた入力例と結果を使って、集計前に止める条件と、その後の確認事項を説明します。
まず小さい例で確認
確認用のCSVを用意しました。UTF-8系の文字コード、カンマ区切り、先頭レコードが見出しという前提です。
入力例
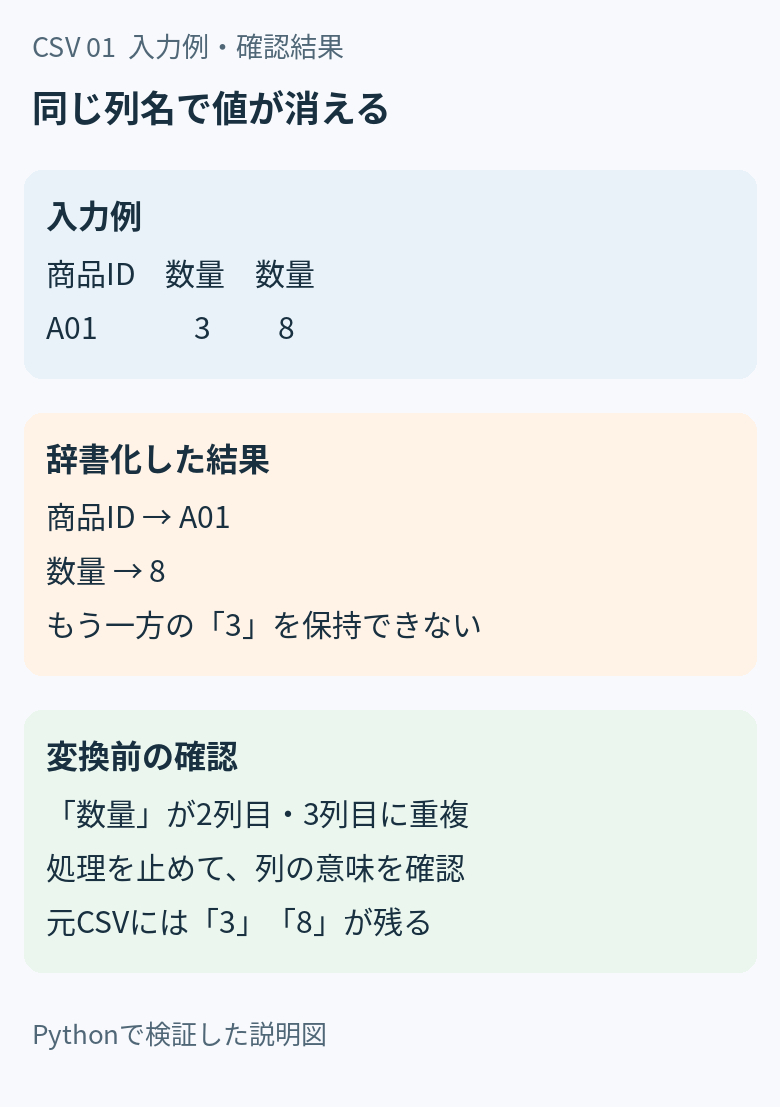
見出し:商品ID,数量,数量
データ:A01,3,8
2列目も3列目も見出しは「数量」ですが、値はそれぞれ3と8です。これをDictReaderで読むと、今回の実行環境では次の内容だけが取り出せました。
辞書化後に取り出せた内容
商品ID → A01
数量 → 8
辞書は同じキーで2つの値を区別できません。この例では後の数量が残り、前の数量を取り出せなくなっています。元CSVから3が削除されたわけではありません。
処理がエラーにならずに進むと、数量3を使うはずの集計にも8が使われるおそれがあります。「読めたから正しい」と判断する前に、列名を確認する必要があります。
列名の重複があれば、辞書にする前に止める
まずcsv.readerで、列の位置を保ったまま読みます。同じ入力では、1列目にA01、2列目に3、3列目に8が残りました。ここで先頭の見出しを確認すると、「数量」が2列目と3列目にあると分かります。
位置を保って確認した結果
1列目:商品ID → A01
2列目:数量 → 3
3列目:数量 → 8
重複している見出し:数量
重複位置:2列目・3列目
今回の検証では、同名列の位置を表示して、辞書への変換や集計に進む前に停止できることを確認しました。DictReader自体が重複を検知して止まるわけではないため、処理側にこの確認を設けます。
大切なのは、辞書にしてから失われた値を探すのではなく、3と8が両方残っている段階で止めることです。
止まったら、列の意味を確認する
機械的に「数量2」と連番を付けるだけでは、その列が発注数なのか納品数なのか分かりません。再開する前に、次の3点を確認します。
1. 発行元の仕様や元画面と照合し、2列目と3列目がそれぞれ何の数量かを確認する。見出しや数値の大小だけで意味を決めない。
2. 意味を確認できたら、元の列位置と処理で使う項目名の対応表を作る。例えば、2列目が発注数量、3列目が納品数量と確認できた場合に、その対応を記録する。
3. 加工後の小さい例で、2列目の3と3列目の8が、それぞれ確認した項目に残っているか照合する。片方が消えていたり、入れ替わっていたりする状態で集計を再開しない。
元ファイルは保管し、加工が必要なら別名の作業用ファイルを使ってください。同名列を片方削除したり、値が同じだから不要だと判断したりするのは避けます。
この確認で分かる範囲
今回検出したのは、完全に同じ列名です。「数量」と、末尾に半角スペースがある「数量 」は別扱いです。先に空白を一括削除すると、それまで別扱いだった見出しが同名になる可能性があります。空白も分かる表示で元の見出しを確認し、名前を整理した場合は重複が生じていないか再確認します。
見出しなし、複数段見出し、別の文字コードや区切り文字の場合は、その仕様に合わせる必要があります。行ごとの列数不足・過剰の検査も別途必要です。同名列がないことだけで、CSV全体の正しさを判断することはできません。
今回、Pythonで同名列の再現、位置を保った読込、重複位置の検出を実行確認しました。Excelの操作画面を確認した記事ではありません。
繰り返し届くCSVなら、集計式を増やす前に「同じ列名があれば止める」確認を入口に置くと、数字が片方消えたまま処理が進むのを防ぎやすくなります。
参考:Python公式ドキュメント「csv.DictReader」
CSVの読込や出力を毎回手作業で確認している場合は、PythonのCSV加工・集計ツール作成サービスからご相談いただけます。