カテゴリ:Python
CSVに「金額」があるのにKeyError。読み込んだ列名に「 金額」のような空白がないか確認しましょう。
1.読み込んだ列名を確認する
今のread_csvの直後、エラー行より前に追加します。dfは自分の表データの変数名に置き換えてください。
print([repr(name) for name in df.columns])
print("修正前の行数:", len(df))
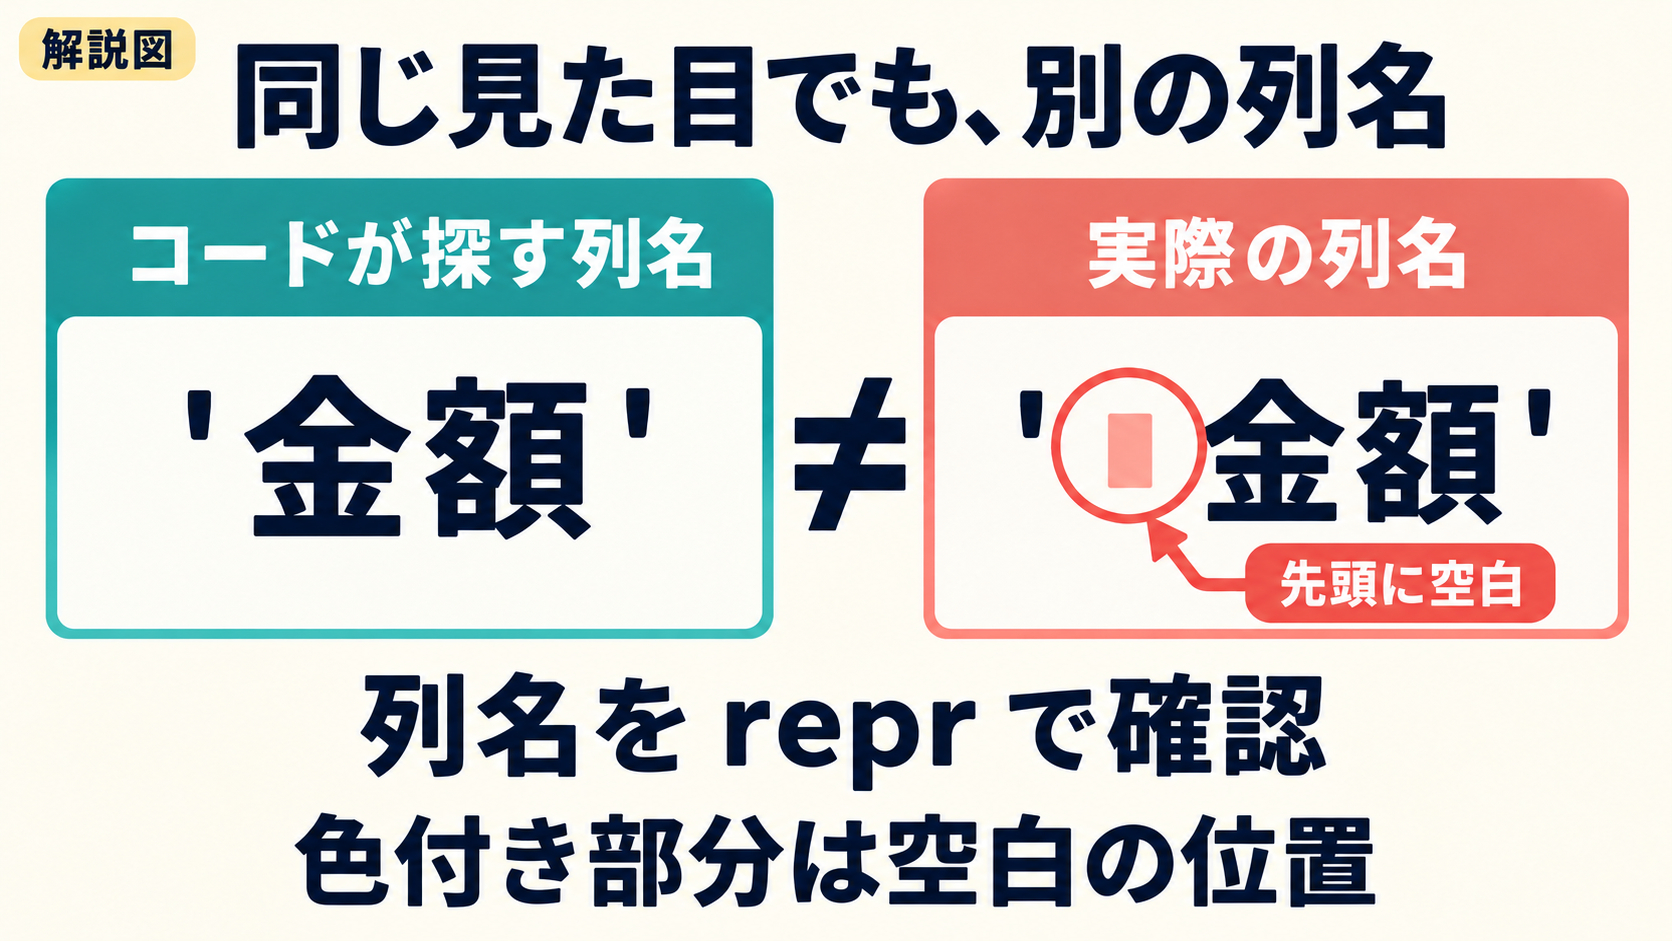
reprは引用符付きで列名を表示します。この例の「金額」の前には半角スペースが1つあり、「金額」とは別名です。図では空白を色付けしています。
["'顧客番号'", "' 金額'", "'メモ'"]
NotebookもCSVの読込から実行し直します。encoding・sep・header・dtypeなど、今の読込設定は変えません。
2.空白が付いた1列だけ直す
「 金額」が使いたい列だと確認し、診断の後、エラー行より前に追加します。
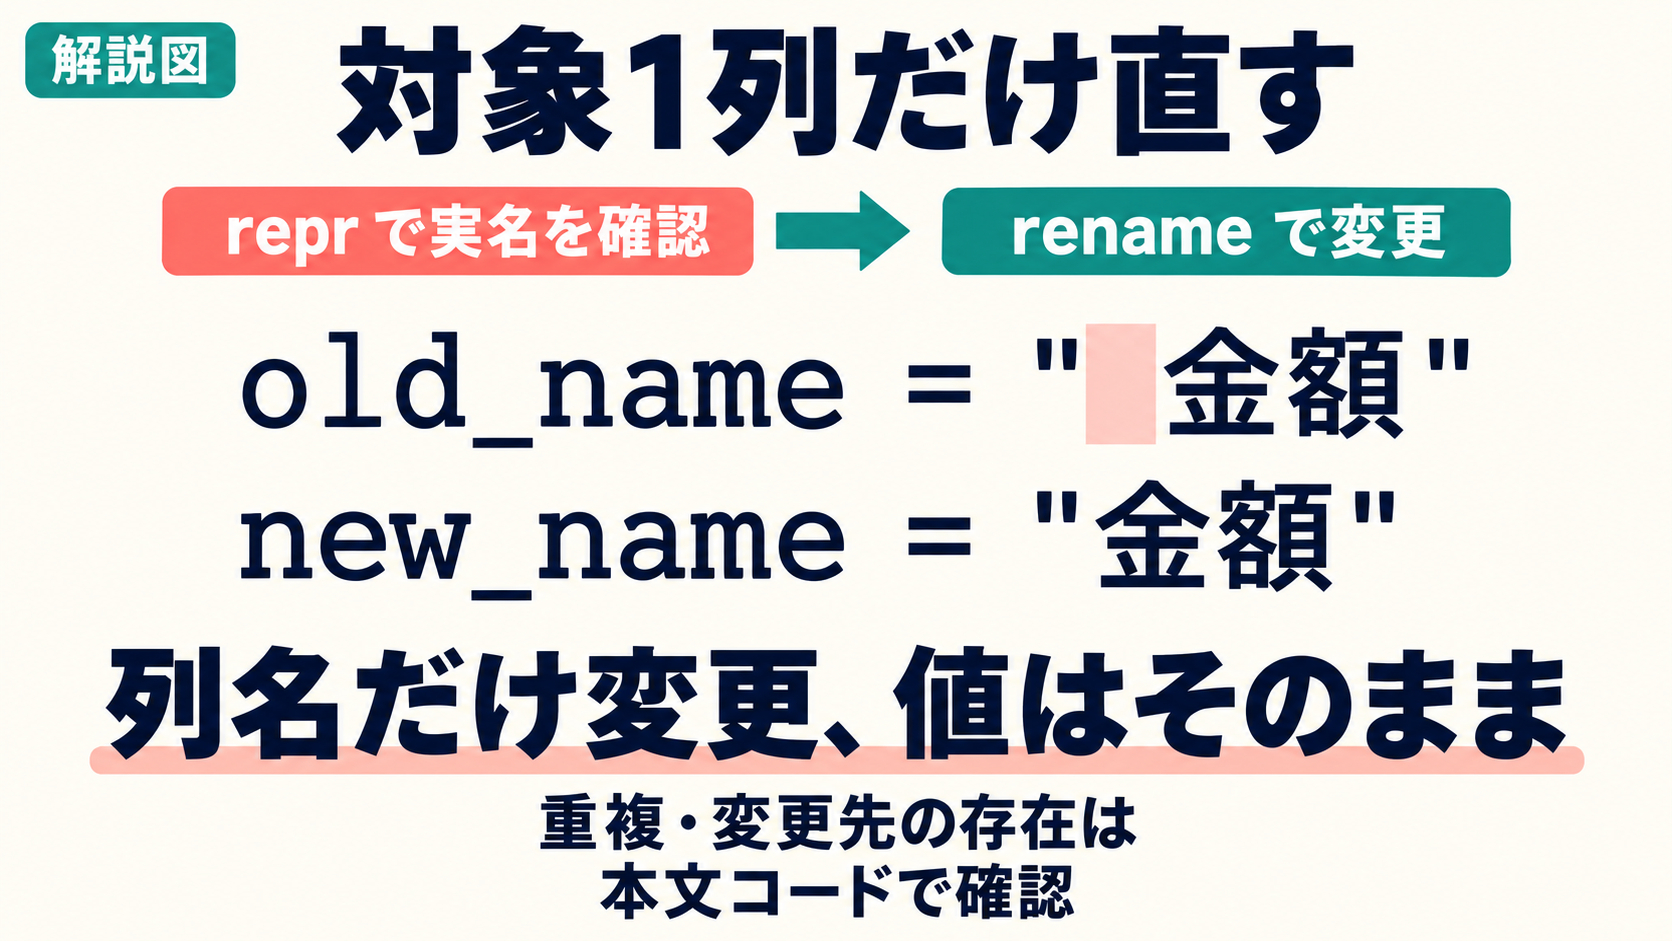
old_name = " 金額"
new_name = "金額"
if not df.columns.is_unique: raise ValueError("列名が重複しています")
if new_name in df.columns: raise ValueError("変更先の列名がすでにあります")
df = df.rename(columns={old_name: new_name}, errors="raise")
old_nameは確認した実際の列名を空白ごと指定し、new_nameは使いたい列名にします。
重複・変更先の衝突・旧名の不一致はエラーで停止します。止まったら確認コードを消さず、手順1へ戻ってください。
全列へのstripは別の列まで変えたり列名を重複させたりするため、対象1列だけを変更します。
3.元の列参照と値を確認する
修正後に、もともと止まっていた列参照を実行します。
print(df["金額"].head())
print("修正後の行数:", len(df))
print(df.head())
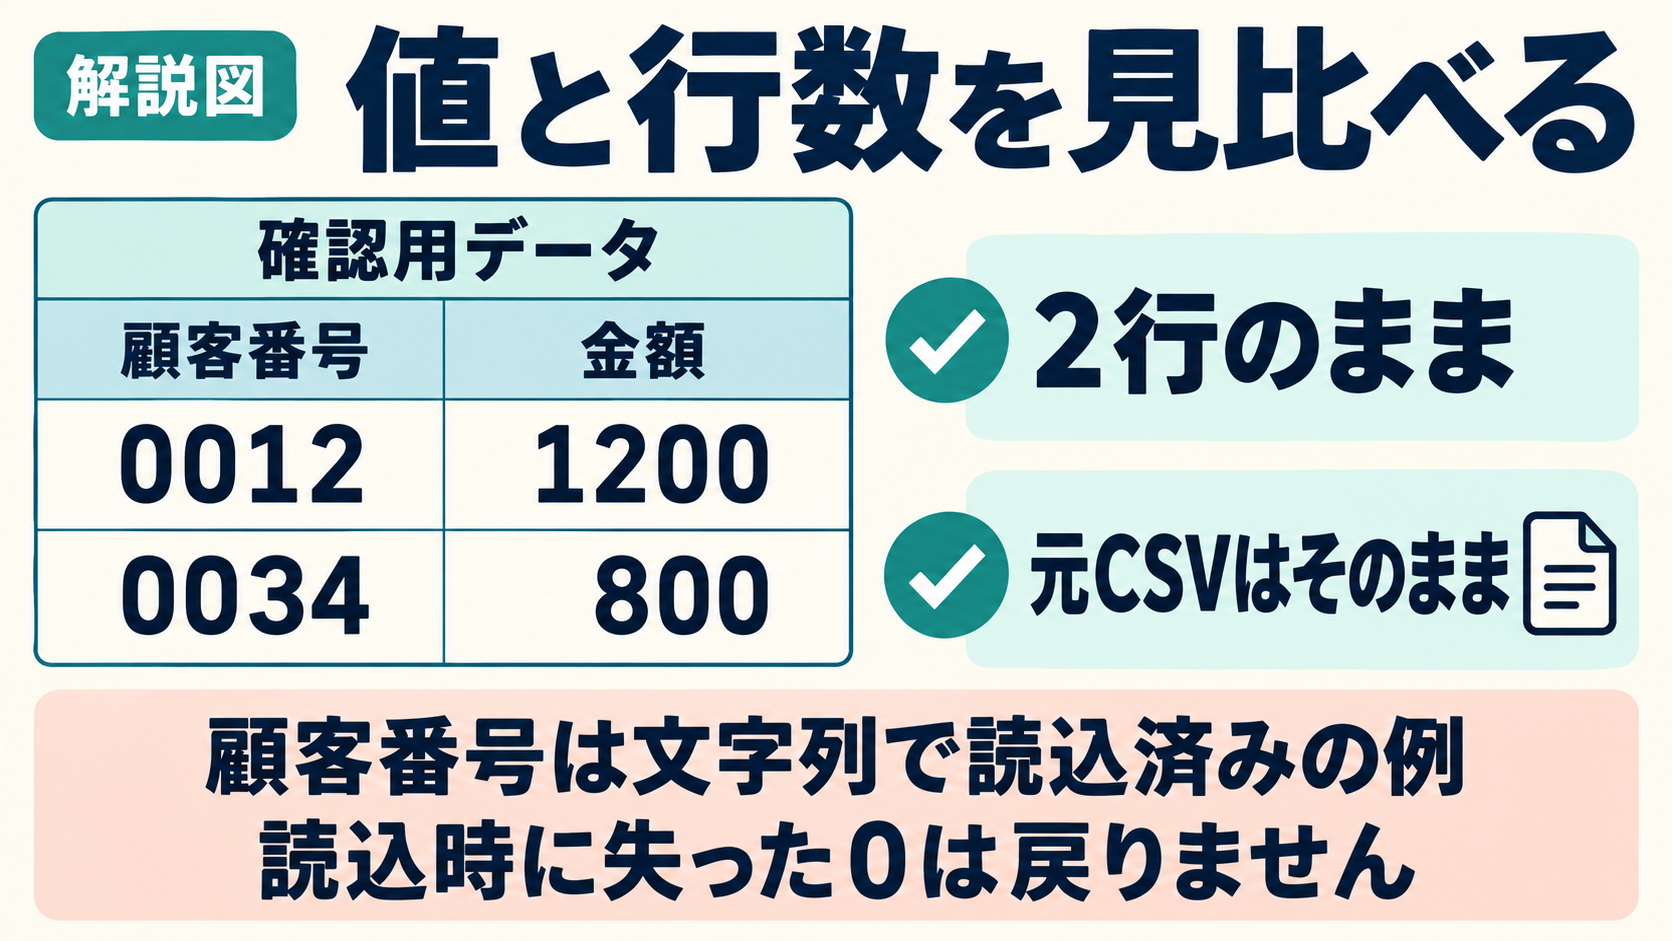
金額・行数・番号が修正前と同じか見比べます。図の例では1200・800の2行です。head()は先頭5行までの表示で、全件確認ではありません。
変わるのは読込済みの列名だけ。元CSVの保存し直しは不要です。「0012」をすでに「12」と読み込んでいた場合は戻らないので、読込時のdtypeを別に確認します。
空白の違いが見つからないとき
無理に列名を変えず、次を確認します。
・見出しが1列につながる:区切り文字のsep
・先頭のデータが列名になる:見出し行のheader
・同じ「金額」がある:エラー行で使う表が確認したdfと同じか
複数段の見出し(MultiIndex)や.locで行を指定したときのKeyErrorは別の確認が必要です。足りない列を0で作ると集計結果が変わるため、避けましょう。
コード確認環境:Python 3.12・pandas 2.2.3/Linux。
「自分のCSVだと、どこを直せばいい?」という場合も、お気軽にご相談ください。