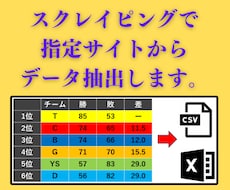
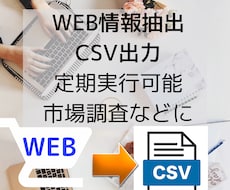
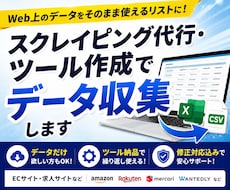
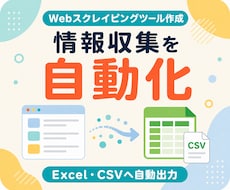
Pythonを使い、Webサイトの情報をスクレイピングで自動取得します。
同じことの繰り返しを自動化することで業務が効率化できます。
BeautifulSoup・Selenium・Requestsを主に使用します。
テキストデータの取得のほか、画像の取得も可能です。
出力はCSV・JSONのいずれかになります。
例)
- ランキングサイトの1位から50位までのデータとそれぞれのリンクを取得
- あるサイトの画像をまとめて保存
- 取得した情報をcsvやJSONに保存
【特長】
- 変数をできるだけ設定ファイルに入れるようにし、可能な限りコード変更が発生しないようにします。
- メンテナンスが必要な場合でも、最小限の変更・格安でお受けできるようにします。
- データが大量にある場合は、途中からデータ取得を再開できるようにするなど考慮した設計にいたします。
【過去の実績】
- 某ネットスーパーのWebサイトから商品名・価格・画像を取得
- 某ドラッグチェーンストアの全店舗の住所・電話番号などを取得
- 銀行DBのWebサイトから全ての銀行の支店名・住所・電話番号などを取得
- etc.
【成果物】
- exeファイル
- スクレイピングのデータ
【注意点】
スクレイピング自体が禁止されているWebサイトもあります。
内容によっては、ご依頼をお断りする場合もあります。
あらかじめご了承ください。
まずはご相談ください。
ご相談にあたって、以下の情報を教えていただきたいと思います。
・対象のWebサイトのURL
・取得したい情報
・出力形式
・納期 (余裕を持ったスケジュールでお願いします)