はじめに ― 前回のあらすじ
前回の記事で、ソフトウェアがどこから来たのかを追いかけました。織機の穴あきカードから始まって、プログラム内蔵方式、OS、キラーアプリケーション、仮想機械まで。
そして最後に、こう書いて終わりました。
では、その段取りは、どうやって書かれているのでしょうか。
今回はその続きです。人間が「まずこれをして、次にこれをして、もしこうなったらこっちへ」と考えたことが、どうやって0と1の並びに変わるのか。
結論を先に言ってしまうと、**間に翻訳者がいます。**その翻訳者がコンパイラとインタープリターです。
ただ、この記事で本当に扱いたいのは「翻訳者がいる」という事実ではありません。その翻訳者が、中で何をやっているのかです。
そしてもうひとつ。翻訳という作業が、私たちが日本語を読むときに無意識でやっていることと、驚くほど同じ形をしているという話をします。ここが今回のいちばん面白いところだと思っています。
1. 機械が読める唯一の言葉
まず、翻訳の行き先を確認しておきます。
だいぶ前のお話しになりますが、コンピューターが0と1しか扱わないことや、その0と1をプロセッサがどう処理するかを追いかけました。あそこで出てきたとおり、プロセッサが実際に受け取るのは命令を表す数値です。
たとえば「この値とこの値を足せ」という命令に、ある番号が割り当てられている。「この値をメモリのここに書け」という命令には別の番号が割り当てられている。プロセッサはその番号を見て、対応する回路を動かします。
この、数値で書かれた命令の並びが機械語です。
機械語には、人間にとって決定的な欠点が二つあります。
ひとつは、読めないこと。ずらりと並んだ数値を見ても、何をしているのか分かりません。
もうひとつ、こちらのほうが厄介なのですが、プロセッサの種類ごとに違うことです。あるプロセッサで「足せ」を意味する番号が、別のプロセッサでは全く違う命令かもしれません。
前の記事で、機械が違えばプログラムを書き直さなければならなかった時代の話をしました。その根っこにあるのが、この二つ目の欠点です。
~~一段だけ人間に寄せた言語~~
そこで、最初の一手として作られたのがアセンブリ言語です。
やったことは単純で、数値の命令に名前を付けただけです。「足せ」を表す数値に ADD という名前を、「メモリからレジスタに読み込め」を表す数値に MOV という名前を付ける。人間はその名前で書き、機械語への変換は機械にやらせる。
この変換をするプログラムをアセンブラと呼びます。
アセンブリ言語の重要な性質は、機械語と一対一で対応していることです。アセンブリの1行が、ほぼそのまま機械語の1命令になります。だから読みやすくなった代わりに、抽象度は一段も上がっていません。
プロセッサが違えば、やはり書き直しです。名前が付いただけで、問題は解決していません。
~~「高水準」「低水準」は上下ではない~~
ここで用語をひとつ整理しておきます。
機械語やアセンブリ言語のように、機械の都合に近い言語を低水準言語と呼びます。逆に、人間の考え方に近い言語を高水準言語と呼びます。
初心者のうちに誤解しやすいのですが、**これは優劣の話ではありません。**低水準が劣っているわけでも、高水準が高級なわけでもない。
正確には、機械からの距離を表しています。低いほど機械に近く、高いほど人間に近い。
そして距離には、ちゃんと対価があります。機械に近いほど、何が起きているかを細かく制御できて、無駄のないコードが書けます。人間に近いほど、書くのは速いけれど、機械が実際に何をしているかは見えなくなります。
**どちらを選ぶかは、何を作るかで決まります。**この見方をしておくと、このあとの話が整理しやすくなります。
2. 高水準言語が隠しているもの
では、高水準言語は具体的に何を肩代わりしてくれているのか。
例を一つ挙げます。「商品の価格に個数を掛けて、合計を出す」という処理です。
高水準言語なら、こう書けます。
total = price * count
一行です。ところが、これを機械の側から見ると、実際には次のようなことが起きています。
1.price という名前が指しているメモリの場所を特定する
2.その場所から値を読み出して、レジスタに入れる
3.count についても同じことをする
4.二つのレジスタの値を掛ける命令を実行する
5.結果をどこかのレジスタに置く
6.total という名前が指しているメモリの場所を特定する
7.その場所に結果を書き込む
**七段階です。**アセンブリ言語で書くなら、この一つひとつを自分で書くことになります。
高水準言語がやってくれているのは、この七段階を一行に畳み込むことです。そしてもっと重要なのは、「price はメモリのどこにあるか」を人間が覚えていなくていいことです。名前を付けておけば、場所の管理は翻訳者がやってくれる。
少し前の記事で、「違いを吸収する層を間に挟む」という型を繰り返し見ました。高水準言語も、まさにこの型です。挟んだ層が、機械の細かい都合を吸収してくれている。
言語が生まれた順に並べてみる
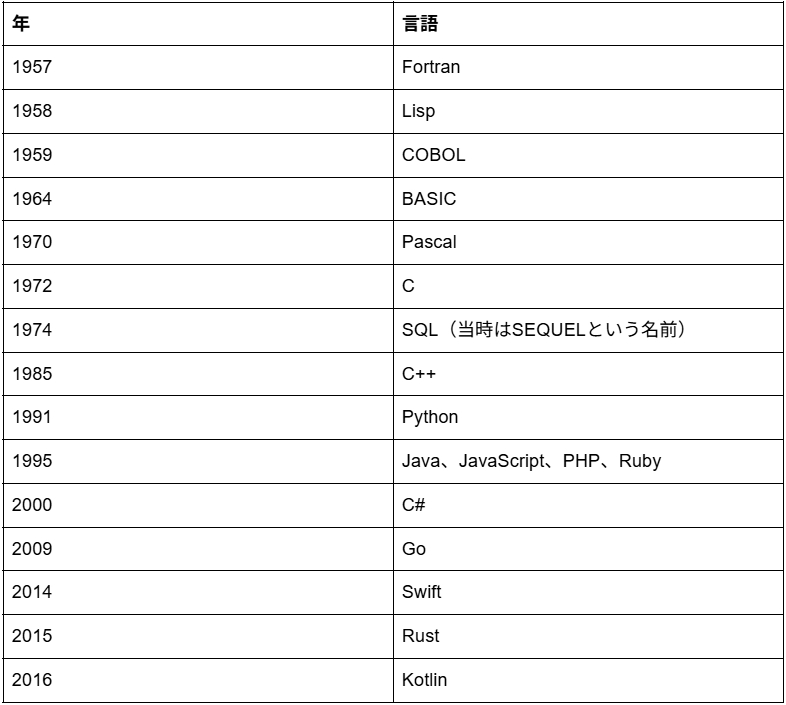
主要な言語がいつ登場したかを並べると、この「距離を広げていく」動きが見えてきます。
ひとつ断っておくと、**この表の「登場年」は基準がそろっていません。**最初に公開された年を採っている言語もあれば、安定版が出た年を採っている言語もあります。言語の「誕生」をいつと数えるかは、実は資料によって割れます。目安として見てください。
そのうえで目を引くのは、1995年に4つ並んでいることです。
このうちJavaScriptとPHPは、はっきりとネットワークの需要から生まれています。インターネットが一般に広がり始め、ブラウザの中で動くものとサーバー側で動くものが急に必要になった時期でした。
ただし残りの2つは事情が違います。Javaはもともと1991年に家電向けの言語として始まったものが、Web向けに位置づけを変えて世に出たものですし、Rubyの作者が語っている動機はネットワークとは関係なく、「書いていて楽しい言語がほしい」というものでした。
**同じ年に並んでいても、理由は同じとは限らない。**ここは正直に書いておきます。
~~現在の勢力図~~
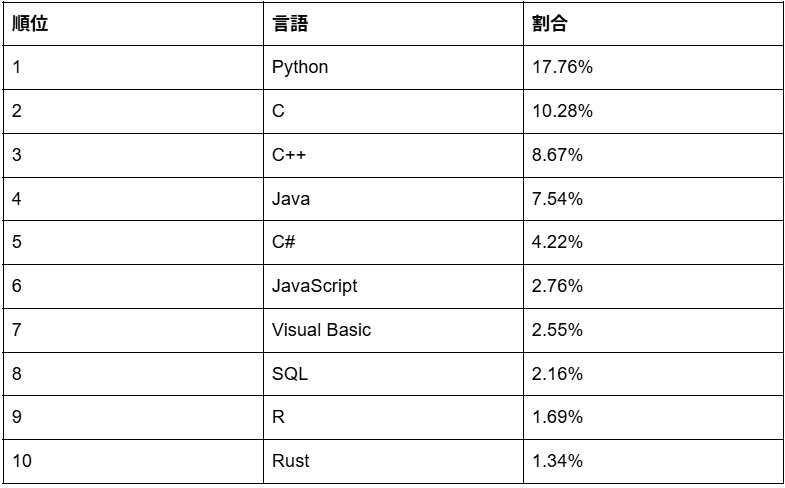
ちなみに、2026年9月時点で最も広く使われている言語は次のようになっています。これは執筆時点で調べ直した数字です。
注目してほしいのは、2位にCが居座っていることです。1972年に生まれた、この記事でいう「低水準寄り」の言語が、半世紀以上たっても2番目に使われている。
理由は、OSや組み込み機器のように機械の都合を細かく制御しなければならない領域が、今も確実に存在するからです。前の記事で見たLinuxの中核部分も、主にCで書かれています。
新しい言語が古い言語を駆逐するわけではない。用途ごとに適した距離が違うので、それぞれの層に住み分けている、というのが実態です。
3. 「意味を取る」とは何をすることか
さて、ここからが本題です。
翻訳者が最初にやらなければならないのは、書かれた文字の列を理解することです。これが、思っているより難しい。
いきなりプログラムの話をすると分かりにくいので、日本語で考えてみます。
次の文を読んでください
すもももももももものうち
読めましたか。
正解は「李も桃も桃のうち」です。李(すもも)も桃も、どちらも桃の仲間だ、という意味ですね。
さて、いま何をしましたか。
おそらく、こういう作業をしたはずです。「す」「も」「も」……と読みながら、どこかで「すもも」という単語を見つけ、次に「も」という助詞を見つけ、また「もも」を見つけ──と、文字の列を意味のあるかたまりに切り分けた。
この作業には名前があります。分かち書き、あるいは専門的には形態素解析と呼びます。
なぜこれが難しいのか
英語なら、この問題はほとんど起きません。
Plums and peaches are both peaches
単語のあいだにスペースが入っているからです。どこで切るかを、書き手が最初から指定してくれている。
日本語にはそれがありません。だから読み手が毎回、自分で切る場所を判断する必要があります。
そして、判断を間違えることがあります。
くるまでまつ
「車で待つ」なのか「来るまで待つ」なのか。文字は完全に同じです。どちらに切るかで意味が正反対になります。
もう一つ。
うらにわにはにわにわとりがいる
素直に読めば「裏庭には二羽、鶏がいる」です。しかし「うらにわには」の部分を「裏に/ワニは」と切ってしまえば、「裏にワニは二羽、鶏がいる」とも読めます。文字は一字も違いません。
人間でも迷うこの作業を、機械は毎回やっています。
~~機械はどう解いているのか~~
日本語を機械に読ませるときに使われる仕組みを、少しだけ覗いてみます。ここは今回のコンパイラの話に直結するので、飛ばさないでください。
代表的なやり方はこうです。
まず、**辞書を引きます。**文の先頭から順に、「この位置から始まる単語として、辞書に載っているものは何か」を全部拾い出す。「すもももももももものうち」なら、先頭からは「すもも」「す」の二つが候補になります。
こうして各位置の候補を全部並べると、分かれ道がびっしり並んだ経路図ができます。始点から終点まで、通り方が何通りもある状態です。
次に、それぞれの道に点数を付けます。
点数は二種類あります。ひとつはその単語自体の出にくさ。よく使われる単語ほど点が低く、珍しい単語ほど点が高い。もうひとつは単語のつながりの不自然さ。たとえば「名詞のあとに助詞が来る」のは自然なので点が低く、「助詞のあとに助詞が二つ続く」のは不自然なので点が高い。
そして、合計点がいちばん低くなる道を選びます。
これが答えです。つまり機械は「正しい意味」を理解しているのではなく、「いちばんありそうな切り方」を計算しているだけなのです。
点数の付け方は、大量の文章をあらかじめ学習して決めてあります。だから機械は、読んだことのない文でも、過去の統計から「これがいちばんありそうだ」と判断できる。
実際に使われている解析器の中身を覗くと、数字は具体的です。ある解析器では「東京」という単語の出にくさが3003点、その直前とのつながりの自然さが-310点、そこまでの合計が2693点、という形で計算が進みます。マイナスの点数があるのは、「つながりが自然なら合計を引き下げる」という設計だからです。
そして、候補の道が何十通りあっても、**全部を試す必要はありません。**途中まで同じ道を通るなら、そこまでの最小点は一度計算すれば使い回せるからです。この「一度計算した結果を覚えておいて使い回す」やり方を動的計画法と呼びます。
つまり日本語の分かち書きは、辞書引きと、点数付けと、最短経路探索の組み合わせで解かれています。意味を理解しているわけではありません。
切り分けても、まだ終わらない
単語に切れたとして、次の問題があります。どの語がどの語に掛かるのかです。
有名な例文があります。
頭が赤い魚を食べる猫
これは複数の読み方ができます。「頭が赤い」が何に掛かるかで、少なくとも次の二つに分かれます。
**頭が赤いのは猫。**その猫が魚を食べている
**頭が赤いのは魚。**猫がその魚を食べている
さらに「食べる」が猫の習性を言っているのか、いま食べているところなのかでも変わります。この例文は5通りに読めるとして知られています。
単語への切り分けは一通りしかありません。**切り方は決まっているのに、意味が決まらない。**掛かり先が定まらないからです。
この、語と語の掛かり方を決める作業を構文解析と呼びます。
ここでプログラミング言語の話に戻ります
さて。日本語を読むのがこれほど大変なら、プログラミング言語を読むのはもっと大変なのでしょうか。
逆です。ずっと簡単です。
理由は、プログラミング言語があらかじめ曖昧さを排除するように設計されているからです。
単語の区切りは、スペースや記号で明示される
使える単語は、あらかじめ決められている(勝手な新語は使えない)
解釈が割れそうなところには、あらかじめ優先順位が定めてある
三つめが肝心です。プログラミング言語にも、実は曖昧になり得る書き方が残っています。
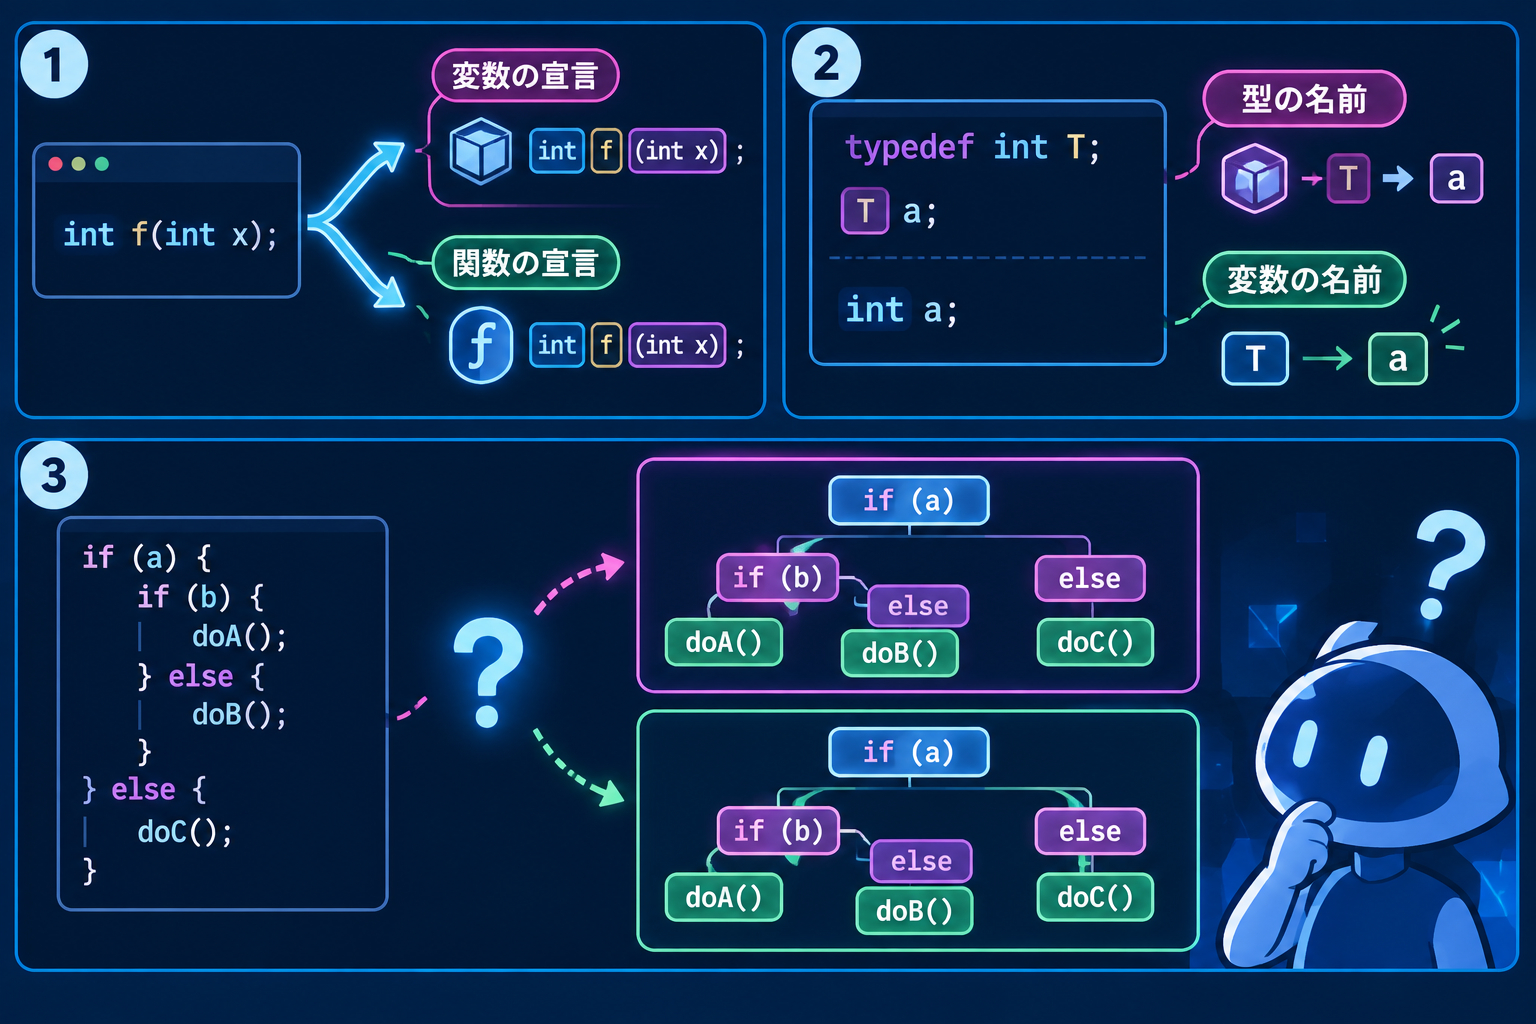
たとえばC++には、書き方によって「変数の宣言」とも「関数の宣言」とも読める形があり、文法だけでは決まりません。C言語にも、ある名前が型の名前かどうかで意味が変わる書き方があります。条件分岐が入れ子になったとき、片方の分岐がどちらの条件に属するのかが形の上では決まらない、という問題もあります。
これらは言語の規則の側で「こう解釈せよ」と決め打ちすることで解決されています。曖昧さが生じないのではなく、生じたときの勝ち負けがあらかじめ決めてあるのです。
日本語との違いは、ここにあります。日本語は人間が長い時間をかけて自然に育ててきた言語なので、曖昧さの量が桁違いに多く、しかも解決の規則がありません。だから統計で「いちばんありそうな読み」を推測するしかない。
プログラミング言語は曖昧さの量が圧倒的に少なく、残った分も規則で潰してある。だからコンパイラは、推測をせずに、規則をたどるだけで一つの答えにたどり着けます。
ただし──やっている作業の中身は、日本語を読むときと同じです。
1.文字の列を、意味のあるかたまりに切り分ける
2.かたまり同士の掛かり方を決める
この二つを、順番にやる。これがコンパイラの前半です。
そして、この二つにはちゃんと名前が付いています。字句解析と構文解析です。
4. 第1段 字句解析 ― 文字をかたまりに切る
では、コンパイラの中身を一段ずつ見ていきます。
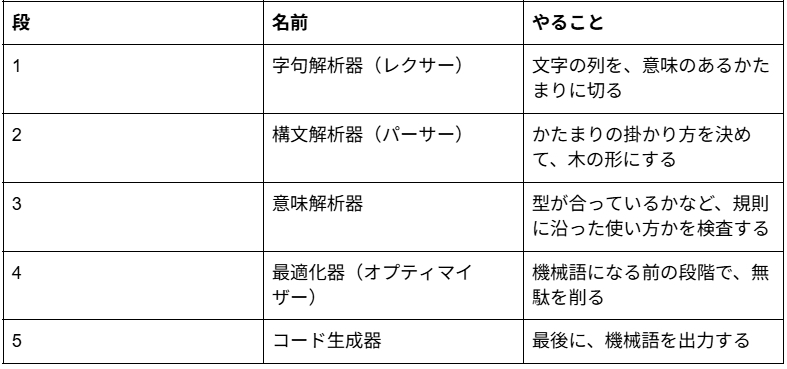
コンパイラは、いくつかの工程が一列に並んだ構造をしています。
ここで一つ、順番に注意してください。最適化はコード生成の前です。
直感的には「機械語を作ってから、その無駄を削る」と思いたくなりますが、実際は逆です。**機械語になる前の、まだ扱いやすい形のうちに整理してしまう。**そのほうが、何が無駄なのかを判断しやすいからです。
この記事でもこの順で説明します。
前の記事で、プロセッサのパイプラインを見ました。「洗う→乾かす→たたむ」と工程を分けて、それぞれが専門の仕事をする、という話でした。
**コンパイラも同じ構造です。**一つの巨大な変換をするのではなく、小さな工程に分けて、各段が前の段の出力だけを受け取って次に渡す。こうすると各段が単純になり、作りやすく、直しやすくなります。
~~レクサーがやること~~
第1段のレクサーは、ソースコードを1文字ずつ読みながら、意味のあるかたまりに切り分けます。
たとえば、次の1行を読ませたとします。
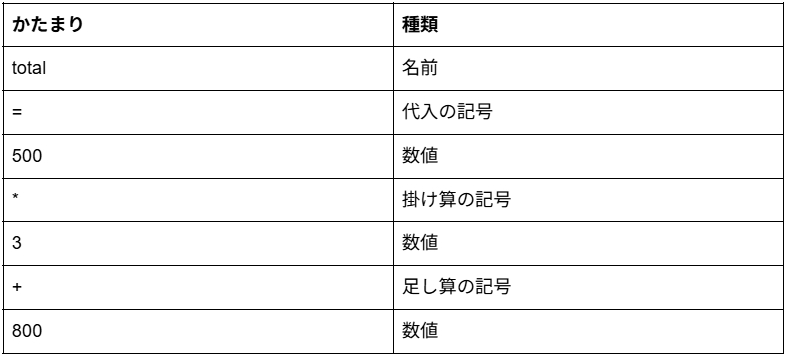
total = 500 * 3 + 800
レクサーが出力するのは、こういうかたまりの並びです。
この一つひとつのかたまりをトークンと呼びます。
日本語の形態素解析と、やっていることが同じなのが分かるでしょうか。**文字の列を、意味のある最小単位に分ける。**違うのは、プログラミング言語では区切りが記号やスペースで明示されているので、統計的な推測が要らないことだけです。
~~捨てるものがある~~
ここで、レクサーの重要な仕事をもう一つ挙げておきます。要らないものを捨てることです。
具体的には、次のものは捨てられます。
スペースやタブ(読みやすくするために入れた空白)
改行
コメント(プログラマが自分のために書いた説明文)
これらは人間が読むためのもので、**プログラムの動作には一切関係ありません。**だからこの段階で落とします。
初心者の頃、「コメントをたくさん書くとプログラムが遅くなるのでは」と心配したことがあるのですが、そんなことはありません。コメントはレクサーの段階で消えるので、出来上がる機械語には1バイトも含まれないからです。安心して書いてください。
(言語によっては、説明文を実行時にも参照できる形で保持する仕組みを持つものがあります。それは「コメント」とは別の仕掛けです。)
名前を台帳に登録する
もう一つ。レクサーは、あらかじめ決められた単語かどうかを判定します。
if while return のように、言語があらかじめ意味を決めている単語を予約語と呼びます。これらは特別扱いされます。
予約語でない単語が出てきたら、レクサーはそれをプログラマが付けた名前だと判断します。変数名や関数名ですね。
このとき、名前を台帳に登録します。「total という名前が出てきた。これは1番目の名前として記録しておく」という具合です。以降、コードの中で total が出てくるたびに、「1番の名前」として扱われます。
なぜ番号に置き換えるのか。そのほうが後の処理が速くて確実だからです。文字列を毎回比較するより、番号を比較するほうが圧倒的に速い。
少し前の記事で「違いを吸収する層を挟む」という型を見ましたが、これは少し違う型です。扱いやすい形に置き換えてから処理するという、これもコンピューターの世界の常套手段です。
~~どこで切るかを決める規則~~
ここで、レクサーが毎回判断していることを一つ挙げておきます。記号をどこまで一つのかたまりと見るかです。
多くの言語では、= は「代入」、== は「等しいかどうかの比較」を意味します。まったく別の意味です。
さて、レクサーが == という2文字に出会ったとき、これをどう切るべきでしょうか。
= と = の二つに切る
== という一つのかたまりと見る
文字を1つずつ読んでいる立場からすると、1文字目の = を読んだ時点では、まだ決められません。
そこで使われるのが最長一致という規則です。「その位置から始まるトークンとして成立するもののうち、いちばん長いものを選ぶ」。
この規則があるので、== は常に1つのトークンになります。= 2つに切られることはありません。
この規則は、思わぬところで顔を出します。たとえば、多くの言語で a--b と書くと意図しない解釈になるのは、最長一致によって -- が一つの記号(1減らす操作)として切られてしまうからです。a - -b と空白を入れれば、意図どおりに切られます。
空白はレクサーが捨てると書きましたが、正確には「捨てる前に、区切りとしての役割は果たしている」わけです。
5. 第2段 構文解析 ― かたまりを木にする
トークンの並びができました。次は、それらの掛かり方を決めます。
なぜ並びのままではいけないのか
さっきの例をもう一度見てください。
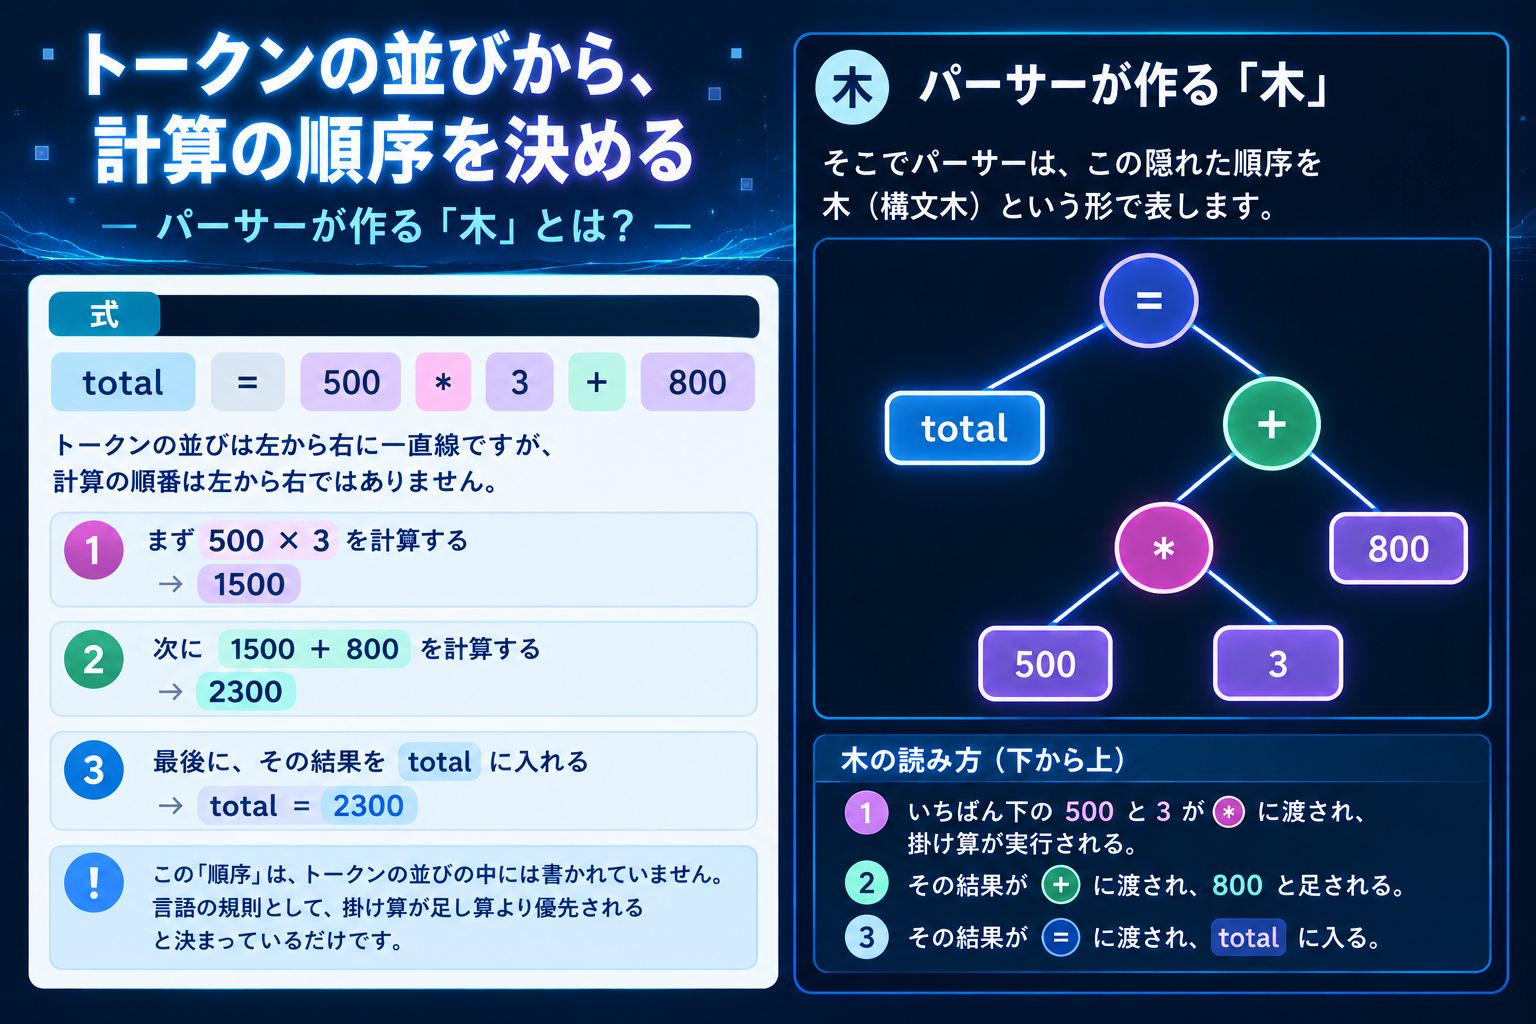
total = 500 * 3 + 800
トークンの並びは左から右へ一直線です。しかし、計算の順番は左から右ではありません。
掛け算は足し算より先に計算します。つまり、
まず 500 * 3 を計算して 1500
次に 1500 + 800 を計算して 2300
最後に、その結果を total に入れる
という順序になります。
**この「順序」は、トークンの並びの中には書かれていません。**言語の規則として、掛け算が足し算より優先されると決まっているだけです。
パーサーの仕事は、この隠れた順序を目に見える形にすることです。
木という形
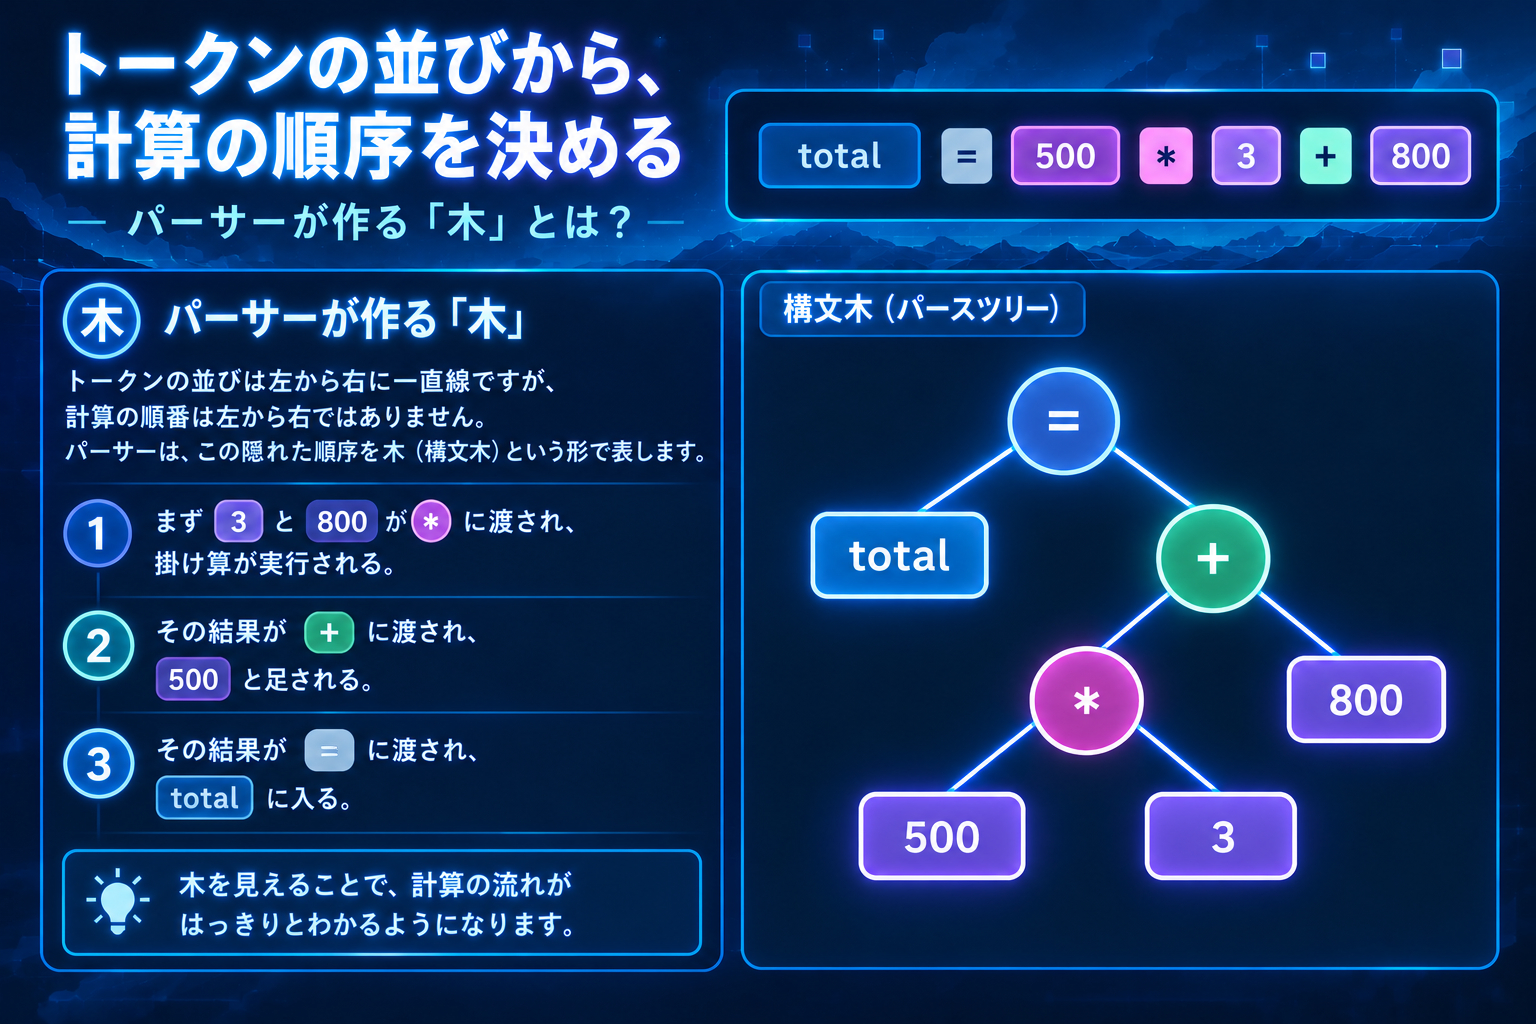
そこで使うのが木の形です。
読み方は、下から上です。
いちばん下の 500 と 3 が * に渡されて、掛け算が実行される。その結果が + に渡されて、800 と足される。その結果が = に渡されて、total に入る。
枝の深いところほど、先に計算されます。
この形にしてしまえば、計算の順番はもう考えなくていい。木の構造そのものが順番を表しているからです。これが木を使う理由です。
括弧は木の形を変える道具
ここで、ひとつ腑に落ちる話をします。
数式に括弧を書くことがありますね。
total = 500 * (3 + 800)
括弧を付けると答えが変わります。では、括弧は何をしているのか。
木の形を変えています。
さっきは * が + の下にありました。今度は + が * の下にあります。深いほうが先に計算されるので、足し算が先になった。
括弧というのは、「この部分を一つのかたまりとして、先に計算せよ」という木の組み替えの指示なのです。
学校では「括弧の中を先に計算する」と習いますが、機械の側から見ると「括弧は木の深さを変える記号」です。同じことを言っているのですが、こちらの見方のほうが、なぜそうなるのかが腑に落ちると思います。
条件分岐も木になる
計算式だけでなく、条件分岐も同じように木になります。
もし 在庫 が 10 より少なければ
発注数 に 50 を入れる
そうでなければ
発注数 に 0 を入れる
これを木にすると、いちばん上に「条件分岐」という節があり、その下に三本の枝が伸びます。条件の枝、条件が成立したときの枝、成立しなかったときの枝の三本です。
横に広がる形で描くと崩れやすいので、縦に並べて書いてみます。
条件分岐
├ 条件 : 「より小さい」( 在庫 , 10 )
├ 成立したとき: 「代入」( 発注数 , 50 )
└ 不成立のとき: 「代入」( 発注数 , 0 )
( ) の中身が、その節にぶら下がる子です。「より小さい」という節の下に「在庫」と「10」がぶら下がり、比較の結果が上に返る。数式の木とまったく同じ構造です。
繰り返しも同じです。「繰り返し」という節の下に、続ける条件の枝と、繰り返す中身の枝がぶら下がる。
**プログラムがどれだけ複雑になっても、最終的には一本の大きな木になります。**いちばん上の節がプログラム全体を表し、そこから枝分かれして、いちばん下の葉が個々の値や名前になる。
この木を構文木と呼びます。パーサーの出力がこれです。
~~構文エラーの正体~~
ここで、日常的に出会うあれの正体が分かります。
コードを書き間違えたとき、「構文エラー」と怒られることがありますね。括弧を閉じ忘れたとか、記号が余分だとか。
あれは、パーサーが木を組み立てられなかったという報告です。
規則どおりに木を作ろうとしたら、どうしても形にならなかった。だから「ここでおかしくなりました」と位置を教えてくれている。
エラーメッセージが指す行と、本当に間違えた行がずれることがあるのも、これで説明がつきます。パーサーは組み立てに失敗した場所を報告しますが、原因はもっと手前にあることが多いからです。括弧を閉じ忘れたら、失敗が表面化するのはずっと後ろになります。
~~言語によって、解析のしやすさが違う~~
もう一点、知っておくと言語の見え方が変わる話をします。
パーサーは、トークンを左から順に読みながら木を組み立てます。このとき問題になるのが、**「いま読んでいるトークンだけでは、次に何をすべきか決まらない」**場合です。
たとえば、ある言語で name というトークンを読んだとします。これは変数を読み出しているのか、それとも関数を呼び出そうとしているのか。次のトークンが ( かどうかを見ないと決まりません。
こういうとき、パーサーは先読みをします。1つ先を覗いて判断する。
言語によって、この先読みがどれだけ必要かが違います。1つ先を見れば決まる言語もあれば、何トークンも先を見ないと決まらない言語もある。先読みが少なくて済む言語ほど、パーサーは単純で速くなります。
ここで、ある言語の設計が腑に落ちます。すべてを括弧で囲む書き方をする言語がありますね。一見すると括弧だらけで読みにくい。しかし括弧が木の構造をそのまま書き表しているので、パーサーはほとんど何も考えずに木を組み立てられます。
「書きやすさ」と「解析しやすさ」は、しばしば逆を向きます。人間に優しい表記ほど、機械は苦労する。言語の設計とは、この綱引きのどこで折り合いをつけるかを決めることでもあります。
6. 第3段・第4段 ― 使い方を検査して、無駄を削る
木ができました。ただ、すぐに機械語を作るわけではありません。あいだに二つ工程が入ります。
~~型が合っているかを見る~~
まず、書かれている使い方が規則に沿っているかを検査します。
構文解析を通ったということは「形としては正しい」という意味でしかありません。形は正しくても、意味が通らないことがあります。
たとえば、文字列と数値を掛け算しようとしている。存在しない名前を使っている。関数に渡す値の個数が合っていない。どれも形の上では木になりますが、実行できません。
この検査を意味解析と呼びます。多くの言語で「型が合いません」というエラーが出るのは、この段です。
前の章で、構文エラーはパーサーが木を組み立てられなかった報告だと書きました。型のエラーは、木は組み立てられたが、中身の辻褄が合わなかった報告です。出てくる段が違うので、直す場所も違ってきます。
~~そのあとで、無駄を削る~~
検査を通ったら、次は最適化です。ここでまだ機械語になっていないうちに、無駄を削ります。
なぜこの順番なのか。機械語になってしまうと、一つひとつの命令が細かすぎて、元の意図が読み取りにくくなるからです。木や、それに近い形のうちなら「この計算は毎回同じ結果になる」といった判断がつきやすい。
削られるものを、代表的なものだけ挙げます。
その1:答えが最初から決まっている計算
秒数 = 60 * 60 * 24
この式には変数が一つも入っていません。**答えは書いた時点で 86400 に決まっています。**だったら掛け算を残す意味がないので、86400 という値に置き換えてしまう。
その2:同じ計算の繰り返し
同じ式が近くで二度出てきたら、一度計算して結果を使い回せば済みます。二度目の計算を消せる。
その3:絶対に実行されない部分
もし 1 が 2 と等しければ
(何かの処理)
1 が 2 になることはありません。中身は永遠に実行されないので、まるごと削除します。
その4:繰り返しの中の、動かない処理
繰り返しの中に、毎回同じ結果になる計算が入っていることがあります。それを繰り返しの外へ追い出せば1回で済みます。1000回まわるなら、999回分が消えます。
~~「最適化なし」でも最適化されている~~
ここで、実際に手を動かすと分かる面白い事実があります。
多くのコンパイラには「最適化しない」という指定があります。ところが、その指定をしても、その1の定数計算だけは行われることが多いのです。
60 * 60 * 24 と書いたコードを最適化なしで変換しても、掛け算の命令は出てこず、86400 という値が直接現れます。
理由は、この種の計算が言語の規則そのものに組み込まれているからです。「定数どうしの計算は、そこで値が決まる」というのは言語の定義の一部で、最適化というより前処理に近い扱いになっています。
つまり「最適化なし」は「何もしない」ではなく「踏み込んだ最適化をしない」という意味です。ここは実際に確かめると裏切られる部分なので、書いておきます。
~~なぜ人間が手で最適化しなくていいのか~~
これらに共通しているのは、人間が書いたコードの「読みやすさ」と、機械にとっての「効率」は別物だということです。
60 * 60 * 24 と書くのは、それが「1日の秒数」だと読んで分かるからです。86400 と直接書くより意図が伝わります。
**人間には読みやすい形で書き、機械には効率的な形に直してもらう。**この分業を成り立たせているのが最適化器です。
だから可読性を犠牲にして手で最適化する必要はありません。むしろ、下手に手で書き換えると読みにくくなるうえ、最適化器の判断を邪魔することすらあります。
**素直に書いて、最適化は任せる。**これが現代の基本方針です。
7. 第5段 コード生成 ― 木を歩いて機械語を出す
整理が済みました。最後に機械語を作ります。
~~型紙に穴埋めをする~~
コード生成器がやることは、思いのほか素朴です。
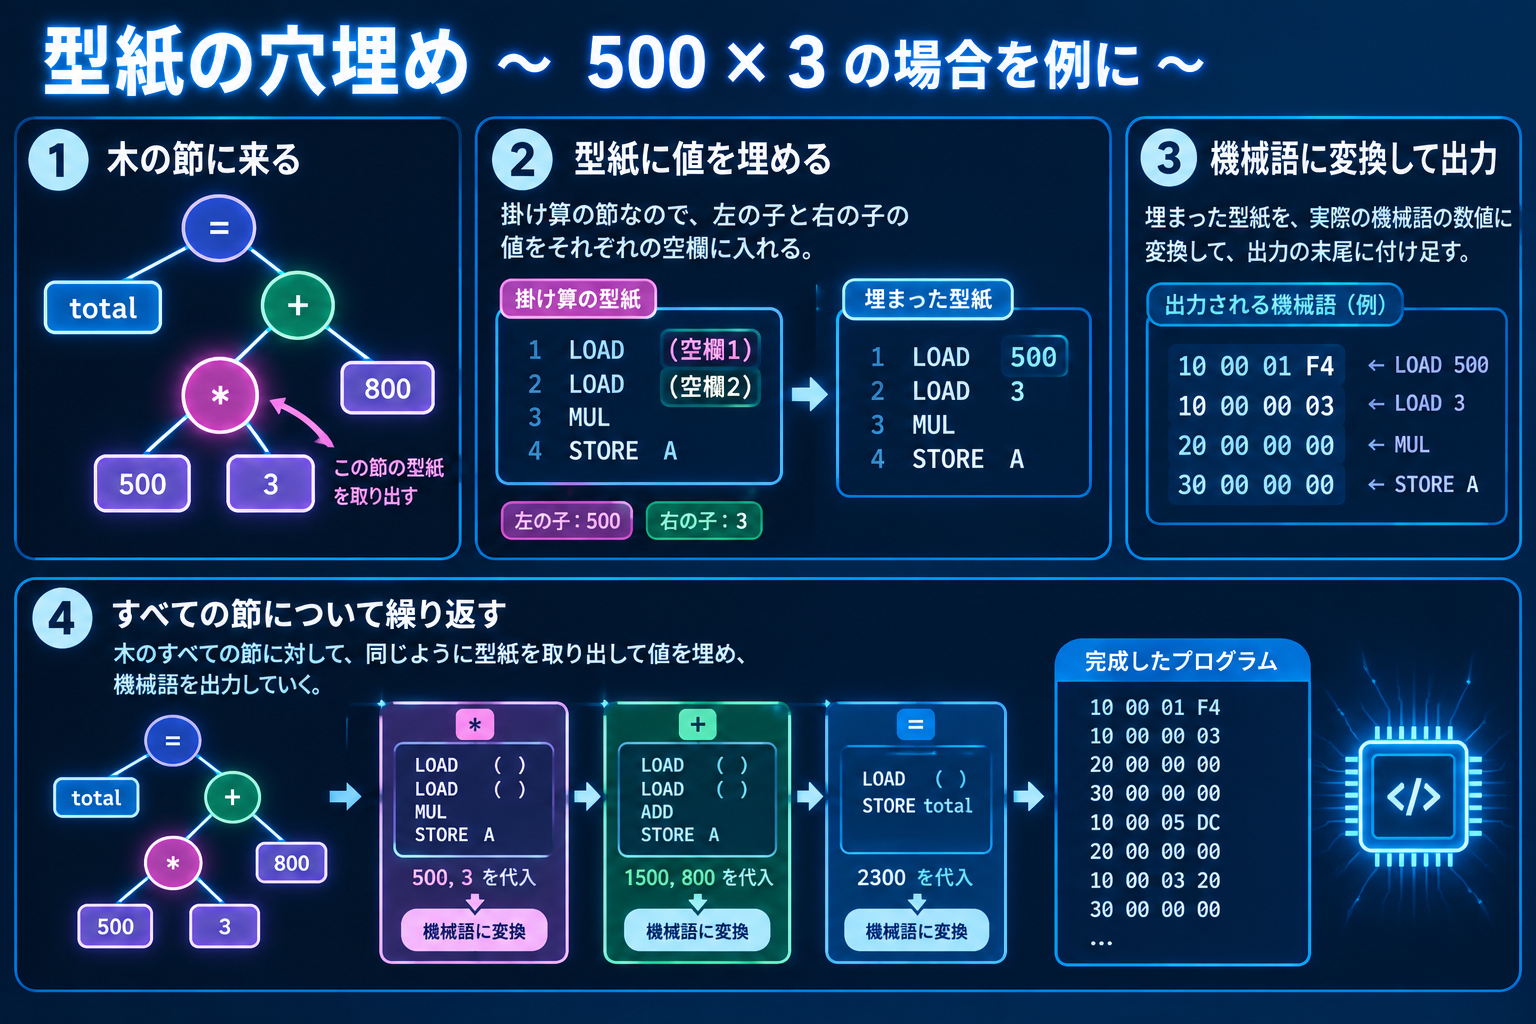
あらかじめ、節の種類ごとに機械語の型紙を用意しておきます。
「足し算の節なら、この機械語の並びを出す」 「代入の節なら、この機械語の並びを出す」 「条件分岐の節なら、この機械語の並びを出す」
という対応表です。
そして木を下から順にたどりながら、節の種類に合う型紙を選び、空欄に具体的な値や場所を埋めていく。
少し前の話で、OSとアプリの関係を「役所の窓口」にたとえました。決まった書式の申請書を出せば、中で何が起きているかを知らなくても処理してもらえる、という話です。
コード生成も似た構造です。**型紙という決まった書式があり、そこに値を流し込むだけ。**個々の節について、いちいち創意工夫をするわけではありません。
~~型紙の穴埋めを、少し具体的に~~
さっきの 500 * 3 の部分を例にします。
掛け算の型紙が、たとえばこういう形だったとします。
(空欄1)の値をレジスタAに読み込む
(空欄2)の値をレジスタBに読み込む
レジスタAとレジスタBを掛けて、結果をレジスタAに置く
コード生成器は、木の * の節に来たとき、この型紙を取り出します。そして左の子が 500、右の子が 3 だと分かっているので、空欄1に 500、空欄2に 3 を埋める。
埋まった型紙を、実際の機械語の数値に変換して、出力の末尾に付け足す。
これを木の全部の節について繰り返すと、プログラム全体の機械語ができあがります。
~~順番が効いてくる~~
ここで、木の形が効いてきます。
木を下からたどるということは、深い節の機械語が先に出力されるということです。そして深い節ほど先に計算されるべきものでした。
つまり、木の構造がそのまま実行される順番になります。
パーサーが木を作った時点で、実行順序は決定していた。コード生成器は、その順序どおりに機械語を並べているだけです。
**だから木が必要だったのです。**トークンの並びのままでは順序が分からないので、機械語をどの順で出せばいいかも決まりません。
~~実際の命令数は、機械によって変わる~~
ひとつ補足しておきます。
第2章で、total = price * count の1行が機械の側では七段階になる、と書きました。あれは何をしているかを分解した説明であって、実際に出てくる命令が7個という意味ではありません。
プロセッサの種類によって、一つの命令でどこまでできるかが違います。「メモリの場所を特定して、そこから読み出す」が1命令で済む機械もあれば、2命令必要な機械もある。
**やっている仕事の種類は変わりませんが、命令の個数は機械によって変わります。**記事3で見たとおり、命令の設計思想は機械ごとに違うからです。
8. 部品をつなぎ合わせる ― リンク
ここまでで、ソースコードが機械語になりました。しかし、まだ実行できません。
まだ一工程あります。ここは見落とされやすいのですが、実務でつまずく箇所でもあるので、きちんと扱います。
~~コンパイルはファイル単位で行われる~~
少し前の記事で、ソフトウェアが複数のファイルに分かれていることに触れました。中心になる部分があり、その周りに機能ごとの部品がある、という構造です。
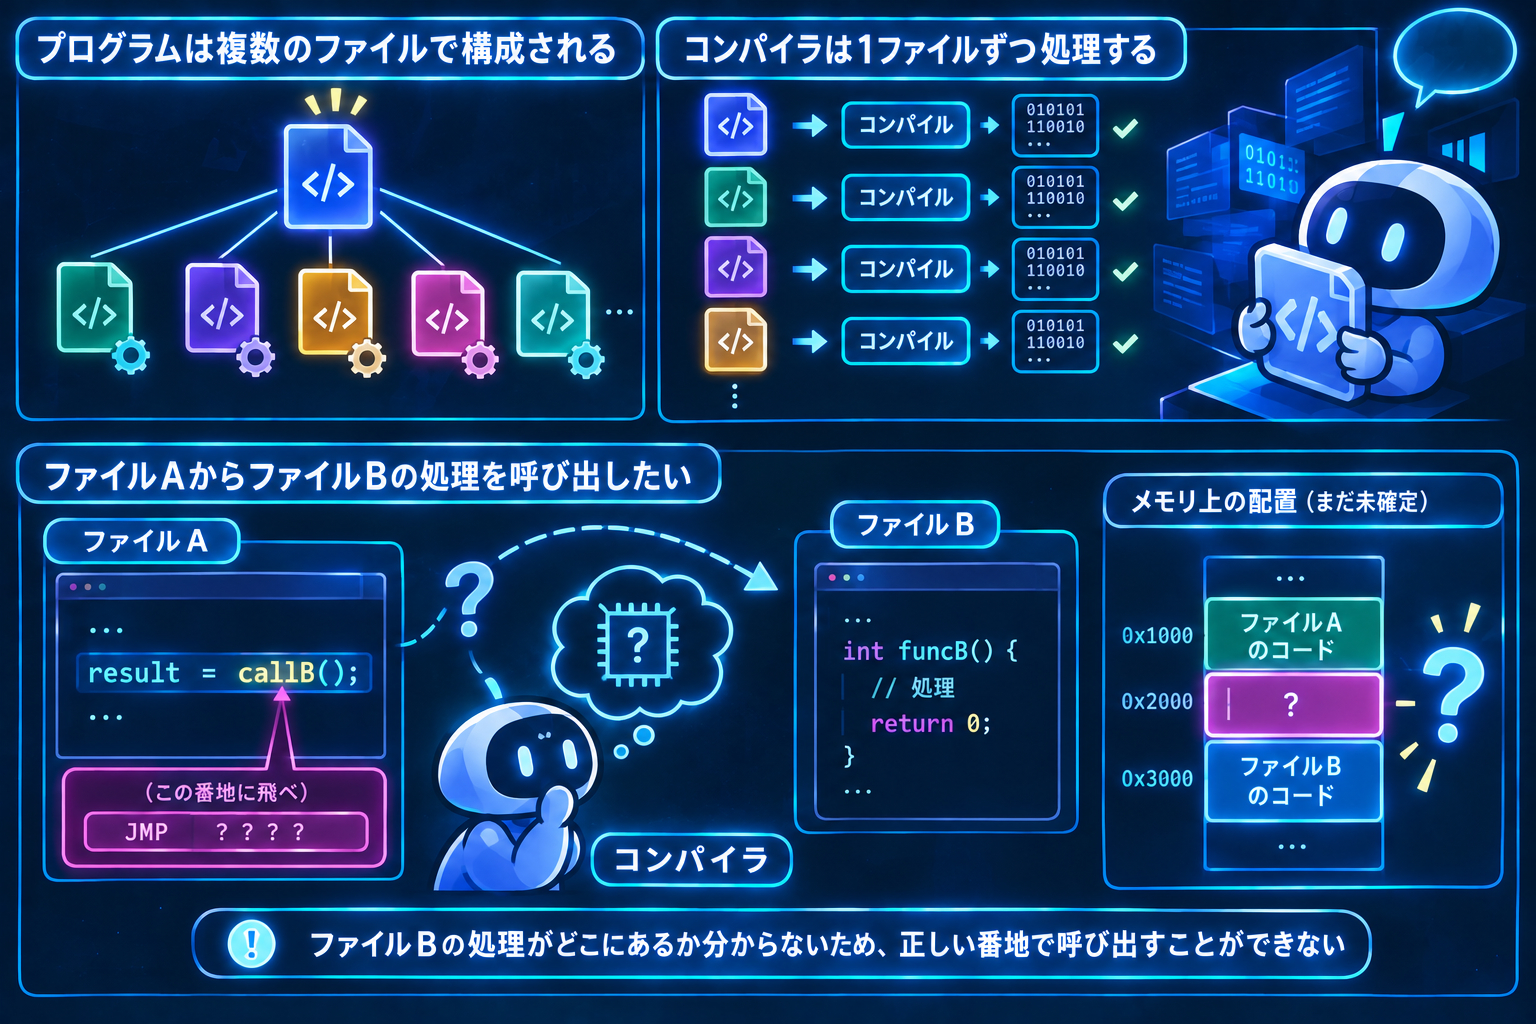
現実のプログラムは、1つのファイルには収まりません。数十、数百のファイルに分かれています。
そして、コンパイラは1ファイルずつ処理します。
ここで問題が起きます。ファイルAの中から、ファイルBにある処理を呼び出したいとします。コンパイラがファイルAを処理しているとき、ファイルBのことは何も知りません。
呼び出したい処理が、メモリのどこに置かれるのか分からない。
呼び出しの機械語には「この番地に飛べ」という情報が必要なのに、その番地が決まっていないのです。
~~空欄のまま出しておく~~
コンパイラの答えは、割り切ったものです。
番地の部分を空欄にしたまま出力し、「ここは後で埋めてください」という付箋を付けておく。
こうして出来上がった、空欄つきの機械語ファイルをオブジェクトファイルと呼びます。ファイル1つにつき、1つできます。
リンカが空欄を埋める
最後に登場するのがリンカです。
リンカは、すべてのオブジェクトファイルを集めて、こういう作業をします。
1.全部を並べて、それぞれがメモリのどこに置かれるかを決める
2.各ファイルが「ここに置きます」と申告している処理の名前と番地を、一覧にまとめる
3.各ファイルに残された付箋を1つずつ見て、一覧から番地を探して、空欄を埋める
4.すべて埋まったら、1つのファイルにまとめる
こうして実行可能ファイルができます。これでようやく動きます。
なぜこの方式にするのか。1ファイル直したときに、そのファイルだけコンパイルし直せばいいからです。全体を毎回やり直していたら、大きなプログラムでは待ち時間が現実的でなくなります。
~~「見つかりません」エラーの正体~~
ここまで分かると、あのエラーの意味が分かります。
プログラムを書いていて、**「その名前は見つかりません」**という趣旨のエラーに出会うことがあります。しかも、コードには確かにその名前が書いてあるのに出る。
これは、リンカが付箋を埋められなかったという報告です。
「ここに飛べ」と書かれた付箋があるのに、どのファイルも「その処理はうちにあります」と申告していない。だからリンカは番地を埋められず、実行可能ファイルを作れません。
原因はたいてい、必要な部品ファイルを渡し忘れていることです。コードの書き方が間違っているのではなく、材料が足りない。
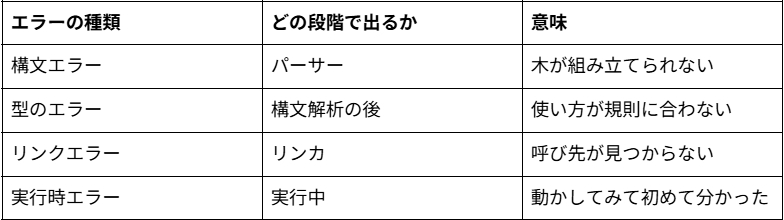
構文エラーとリンクエラーは、出てくる段階がまったく違います。
**エラーが出た段階が分かると、どこを直せばいいかが絞れます。**構文エラーならその周辺の書き方、リンクエラーなら材料の渡し方、実行時エラーなら処理の中身。
エラーメッセージを読むときは、内容より先に「これはどの段階で出たのか」を見る。これだけで、かなり早く原因にたどり着けます。
~~二つのつなぎ方~~
リンクには二通りのやり方があります。
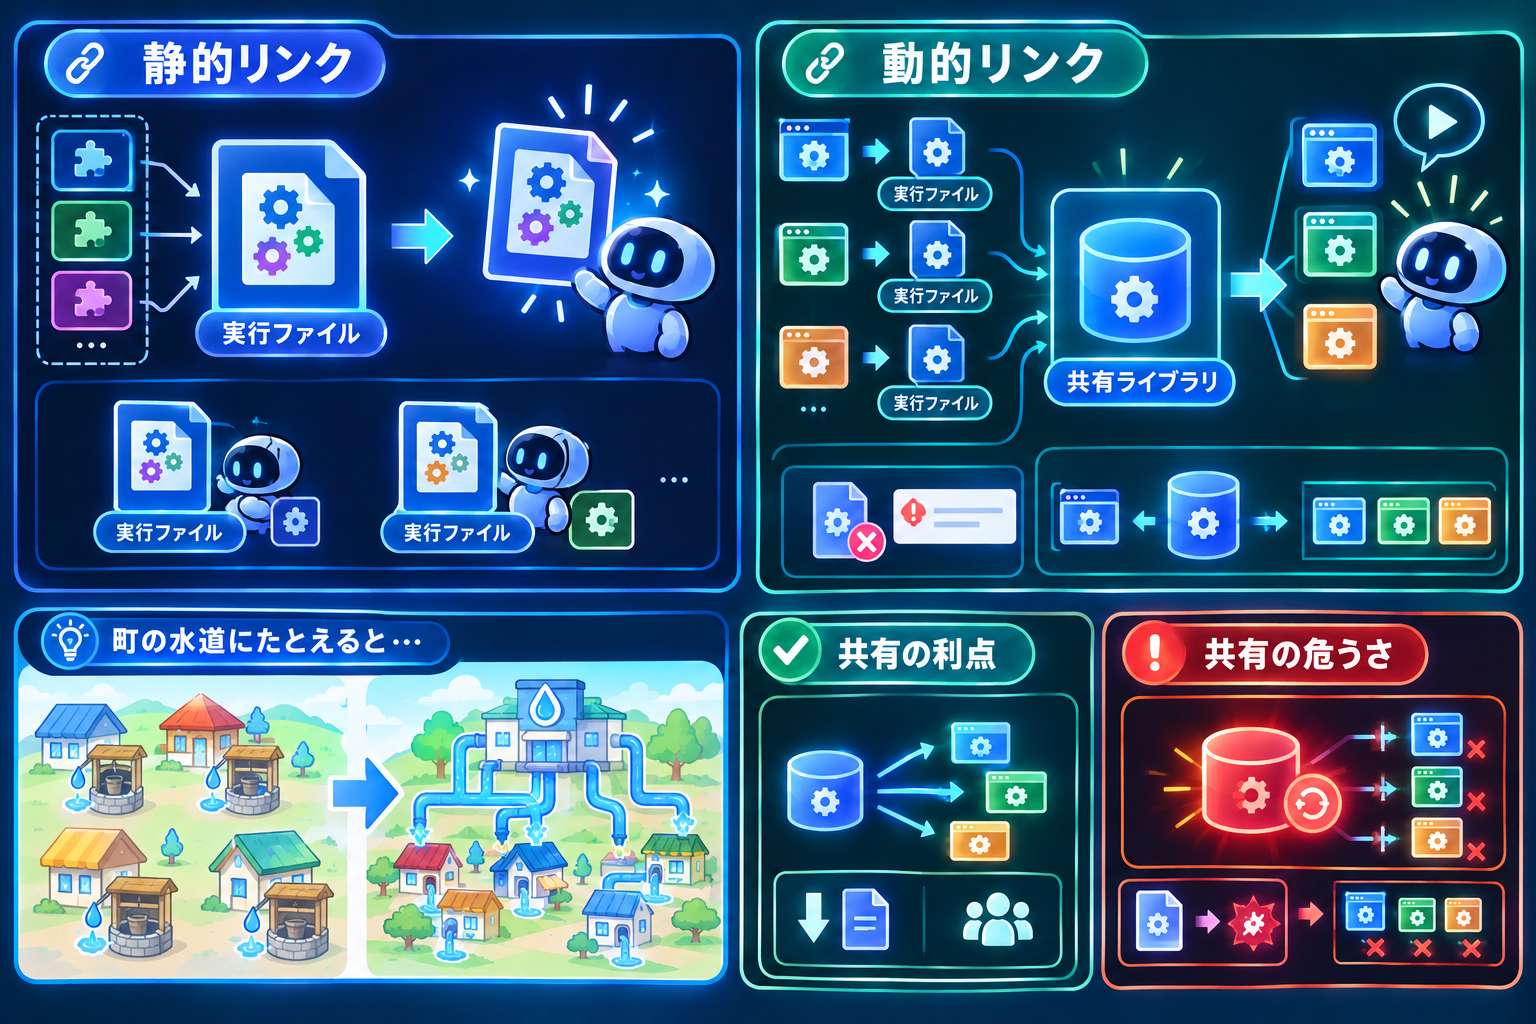
**ひとつめ。静的リンク。**必要な部品を全部、実行可能ファイルの中に取り込んでしまう。こうすると、そのファイル1つを配ればどこでも動きます。ただしファイルは大きくなり、同じ部品を使う別のプログラムがあれば、それぞれが自分用の複製を持つことになります。
ふたつめ。動的リンク。部品は別ファイルのまま置いておき、実行するときに読み込む。こうするとファイルは小さくなり、同じ部品を複数のプログラムで共有できます。この共有される部品ファイルを共有ライブラリと呼びます。ただし、その部品ファイルが無いと動きません。
起動しようとしたら「必要なライブラリが見つかりません」と言われて動かない、という経験はないでしょうか。あれは動的リンクの副作用です。
少し前の記事で、OSが共通の下働きを引き受ける話をしました。「町じゅうの店主がそれぞれ井戸を掘っている」状態を、上下水道でまとめた、という話です。
ふたつめのやり方は、まさにその発想を部品の単位でやっています。よく使われる部品は、一箇所に置いて全員で共有する。
ただし共有には副作用があります。
**その部品を更新すると、それを使っているすべてのプログラムに影響が出る。
**修正が一度で全体に行き渡るのは利点ですが、互換性が崩れると全部が一斉に動かなくなる。
この「共有の利点と危うさ」は、前の話で見たOSの互換性の話とまったく同じ構図です。一箇所にまとめた瞬間に、そこが全体の急所になります。
9. インタープリター ― 訳しながら走る
ここまでコンパイラの話をしてきました。もうひとつの翻訳者、インタープリターに移ります。
~~名前が仕事を表している~~
interpreter という英単語は、そのまま「通訳」という意味です。翻訳者(translator)ではなく通訳者。この語の選び方に、仕組みの違いが表れています。
翻訳は、全部読んでから訳します。通訳は、聞きながら訳します。
コンパイラはソースコード全体を読んで、機械語のファイルを作ります。作り終わったあと、そのファイルだけで動きます。翻訳者はもう要りません。
インタープリターは違います。
**プログラムを1行ずつ読んで、その場で解釈して、すぐ実行する。
**そして次の行へ進む。
つまり、プログラムが動いているあいだ、ずっとインタープリターが横にいることになります。
~~料理でたとえると~~
前の記事で、プロセッサの中を台所にたとえました。作業台がレジスタで、横に立ててあるレシピカードが次の指示だ、という話です。その台所をもう一度使わせてください。
外国語で書かれたレシピを見て料理をすることになったとします。やり方は二通りあります。
**ひとつめ。
**料理を始める前に、レシピ全体を日本語に訳してしまう。訳し終わったら、その日本語のレシピだけを見て料理する。これがコンパイラ。
**ふたつめ。
**訳さずに台所に立ち、1行読んでは訳し、その手順をやり、また次の1行を読んで訳す。これがインタープリター。
この比較から、長所と短所がそのまま出てきます。
~~何が違ってくるか~~
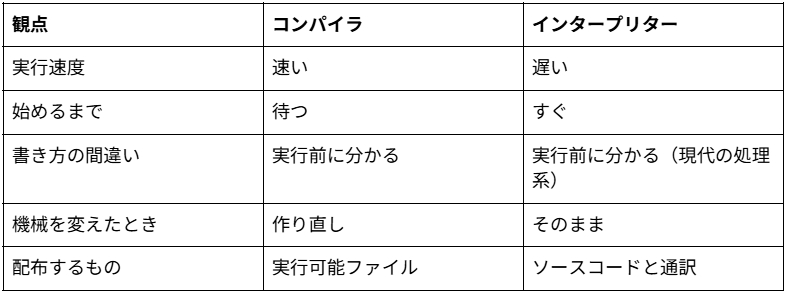
料理中に毎回訳すぶん、ふたつめは遅くなります。しかも、同じ手順を100回繰り返すなら、**100回とも訳し直します。**訳す手間が丸ごと100回分かかる。
コンパイラなら、訳すのは最初の1回だけです。
始めるまでの時間
逆に、ふたつめはすぐ料理を始められます。ひとつめは、全部訳し終わるまで一歩も動けません。
大きなプログラムのコンパイルには時間がかかります。1行直すたびに全部コンパイルし直すのは、開発中には相当な待ち時間になります。つまり、速さの違いです。
~~エラーの見つかり方~~
ひとつめは、訳している段階で「この文は文法的におかしい」と分かります。料理を始める前に間違いが見つかる。
ふたつめについては、少し注意が要ります。
素朴に考えると「50行目の書き間違いは、49行目まで実行してから発覚する」と思えます。実際、昔の行単位のインタープリターはそうでした。
**しかし現代の主要な処理系は違います。**PythonでもRubyでも、実行前にファイル全体を読んで解析します。だから50行目の書き間違いは、1行目を実行する前に報告されます。
では何が違うのか。実行してみないと分からない種類のエラーです。存在しない名前を参照した、0で割った、などといったものは、そこに到達するまで分かりません。
つまり正確にはこうなります。
書き方の間違い(文法・型)── どちらの方式でも、実行前に分かる
動かしてみて起きる間違い(存在しない値、0での割り算など)── その行に到達するまで分からない
この区別は次の章で扱うバイトコードの話につながるので、頭に入れておいてください。
機械を変えたとき
ひとつめで作った日本語のレシピは、日本語が読める人にしか使えません。別の国に持っていくなら、また訳し直しです。
ふたつめは、その国の通訳を連れてくればいい。レシピ自体はそのまま使えます。
これが、少し前の記事で見た「一度書けば、どこでも動く」の正体です。プログラムは書き換えず、機械ごとに違うインタープリターを用意する。
どちらが優れているか、ではない
まとめると、こうなります。
上の表に「優れている」列がないことに注目してください。どの項目も、一方の長所がそのまま他方の短所になっています。
少し前に、仮想機械の話をしたときに「速度を多少犠牲にして、動く場所を増やす」という取引の構図を見ました。ここでも同じ構図が出ています。得るものと失うものが、きちんと対になっている。
そして、両方が欲しくなるのが人間です。
10. 中間の解 ― バイトコードとJIT
「速く動いてほしい。でも、どの機械でも動いてほしい。始めるまで待ちたくもない」
この欲張りな要求に対する答えが、1990年代半ばから一般に広がりました。考え方そのものはもっと古く、1960年代から断続的に試されていたものです。広く使われるようになったのがこの時期だった、ということです。
~~途中まで訳しておく~~
考え方はこうです。
ソースコードを、機械語の一歩手前まで訳しておく。
人間の書いた文字列のままでは、解釈のたびに字句解析と構文解析をやり直すことになります。これは無駄です。なぜなら、その結果は毎回同じだからです。
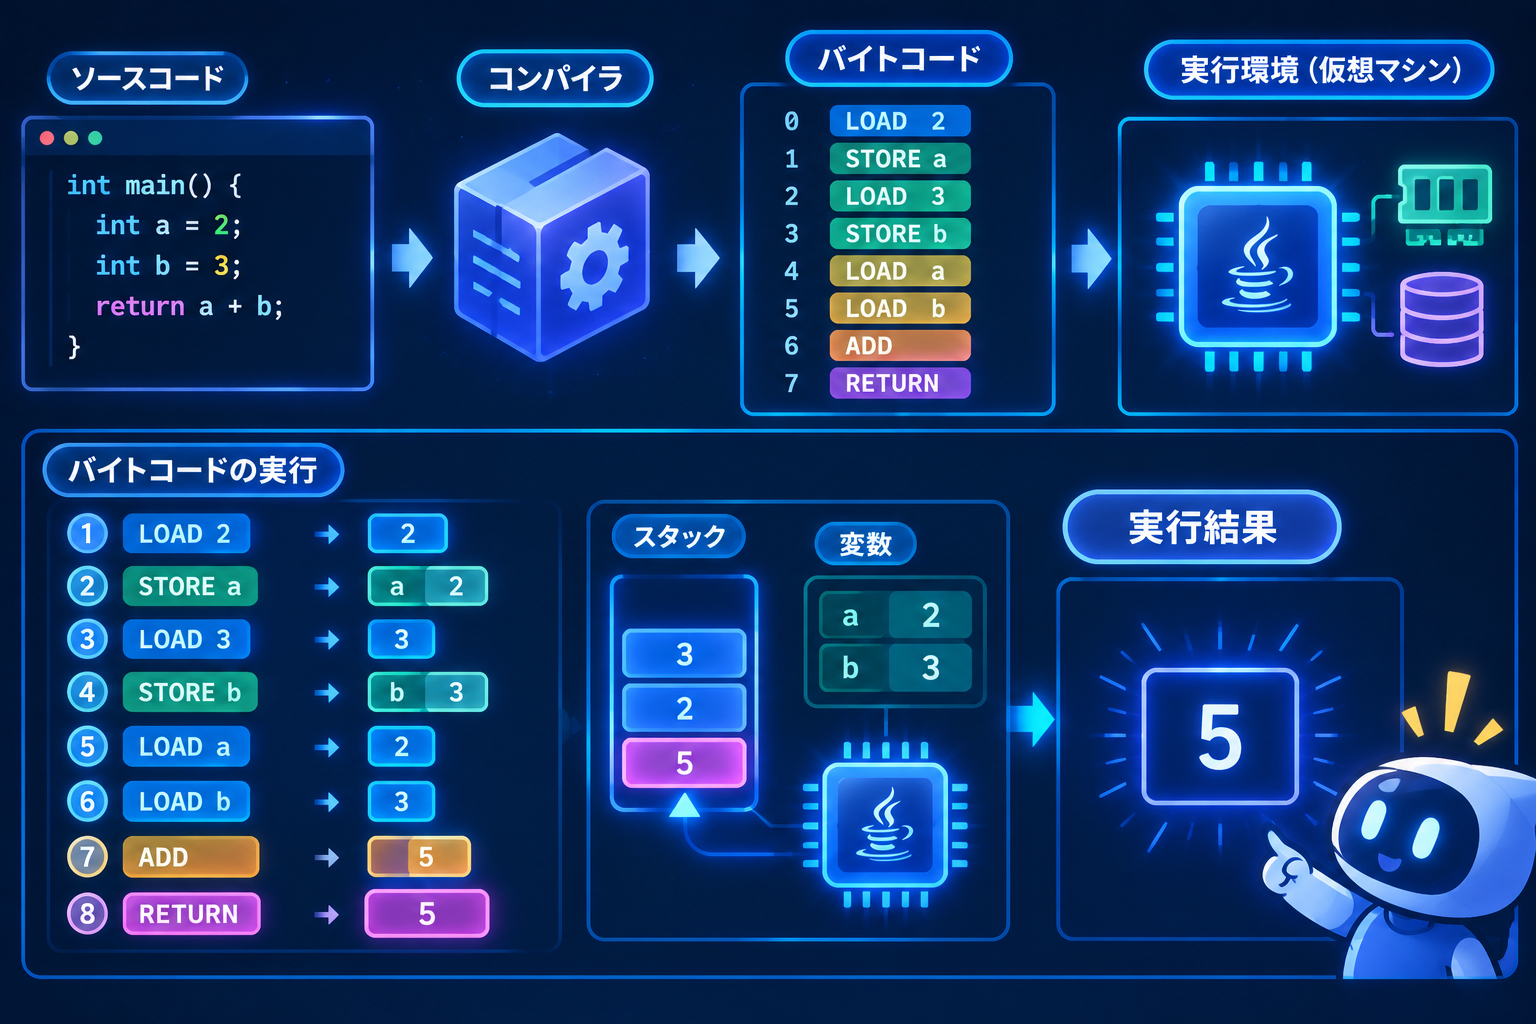
そこで、字句解析と構文解析まではあらかじめ済ませておいて、整理済みの中間形式に変換しておく。この中間形式をバイトコードと呼びます。
バイトコードは、機械語に似た形をしていますが、**実在するどのプロセッサの機械語でもありません。**記事5で出てきた「架空の機械」向けの命令です。
実行時には、この架空の機械のふりをするプログラム(仮想機械)がバイトコードを受け取って動かします。
これで何が得られるか。
解釈の手間が減る(字句解析と構文解析が済んでいるので)
どの機械でも動く(実在のプロセッサに依存していないので)
ソースコードをそのまま解釈するより速く、機械語より移植性が高い。中間の位置を取ったわけです。
~~それでも遅い部分がある~~
しかし、バイトコードを一つずつ解釈する手間は残ります。特に、同じ場所を何度も通るときにこれが効いてきます。
100万回まわる繰り返しがあったら、その中身のバイトコードを100万回解釈することになる。毎回、同じ解釈を繰り返している。
ここで最後の一手が出ます。
よく通る道だけ、機械語にしてしまう
実行しながら、よく通る場所を見つけて、そこだけ本物の機械語に変換してしまう。
そして次からは、変換済みの機械語を直接動かす。
これがJITコンパイラです。Just-In-Time、つまり「実行するその時に」コンパイルする、という意味です。
同じ台詞を100万回訳すくらいなら、一度きちんと訳して覚えておいたほうがいい。当たり前の判断です。
~~実際の閾値を見てみる~~
ここは調べていて面白かったので、具体的な数字を挙げておきます。
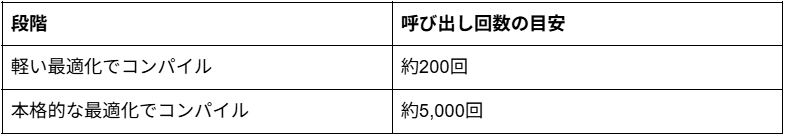
Javaで広く使われている実行環境では、メソッドが何回呼ばれたらコンパイルするかの基準値が決まっています。
つまり、**200回くらい呼ばれたところで「よく使われているな」と判断し、まず素早くコンパイルする。**さらに5,000回に達したら、「これは相当な当たりだ」と見て、時間をかけて本格的に最適化したコードに差し替える。
ここは調べていて引っかかった点なので、正確に書いておきます。**判定に使われるのは呼び出し回数だけではありません。**繰り返しが何回まわったかも一緒に数えていて、「呼び出し回数+繰り返し回数」の合計に対しても別の基準値(2,000回と15,000回)が設けてあります。
なぜ繰り返しも数えるのか。一度しか呼ばれなくても、中で100万回まわる処理があるからです。呼び出し回数だけを見ていたら、こういう処理を見逃します。
上の200回・5,000回という数字も、実行環境の版や設定で変わる既定値です。「おおよそこの桁」という目安として見てください。
なぜ二段階なのか。コンパイルにも時間がかかるからです。全部を最初から本気で最適化すると、その時間がかさんで、かえって起動が遅くなります。
だから、まず軽く手を打って様子を見る。本当によく使われると分かってから、本腰を入れる。
~~「実行しながら」だから分かること~~
ここに、JITの面白い性質があります。
実行前のコンパイルでは分からないことが、実行中には分かります。
たとえば、ある条件分岐が、実際には99%の確率で同じ側に進んでいるとします。この事実は、プログラムを動かしてみないと分かりません。書いてある内容からは判断できないからです。
JITは、これを観測してから最適化できます。「この分岐はほぼ確実にこっちに行くから、そちらを速くしておこう」という判断ができる。
前の話で、プロセッサの分岐予測を扱いました。常連客の注文を先読みする定食屋のたとえを使いましたね。**JITがやっているのも、同じ発想です。**実際の傾向を観測して、次に備える。
そして、これが意味するのは──場合によっては、JITのほうが事前コンパイルより速くなり得るということです。事前コンパイルは実行時の傾向を知らないまま最適化するしかありませんが、JITは実物を見てから決められるからです。
もちろん、起動直後は遅い。そこは変わりません。長く動き続けるプログラムほど、JITの取り分が大きくなります。
~~ここで前の話を補強~~
前回の記事で、仮想機械について「間に通訳が入るぶん遅くなる」と書き、そのあと「近年は実行中に機械語へ変換する仕組みが入り、この差は大きく縮まった」と一文だけ添えました。
その一文の中身が、いま説明したJITです。
**「通訳を挟むから遅い」という理解は、1990年代で止まっています。**現在の仮想機械は、通訳をしながら、よく使う部分を機械語に置き換えていく。長時間動くプログラムでは、この差はかなり詰まります。
11. なぜ言語はこんなに増えたのか
最後に、少し引いた話をします。
ここまで見てきたとおり、翻訳の仕組みは基本的に共通しています。字句解析して、構文解析して、コードを生成して、最適化する。インタープリターも、中で似たことをやっています。
では、なぜ言語はこんなに種類があるのでしょうか。
それぞれが、違う問題を解こうとした
さっきの年表を、今度は「何を解こうとしたか」の目で見直してみます。
Fortran(1957) ― 科学技術計算を、数式に近い形で書きたい。当時はアセンブリしかなかったので、数式を書けること自体が革命でした。
COBOL(1959) ― 事務処理を、英語に近い形で書きたい。プログラマ以外にも読めるように、という発想です。
BASIC(1964) ― 初心者が学べるようにしたい。名前そのものが「初心者向け汎用記号命令コード」の略です。
C(1972) ― OSを書きたい。機械に近い制御ができて、なおかつ読める言語が必要でした。だからOSの中核部分は、いまも多くがCで書かれています(近年は一部にRustを取り入れる動きもあります)。
C++(1985) ― 大規模なプログラムを整理したい。プログラムが大きくなると、機能ごとにまとめる仕組みが要ります。
Python(1991) ― 速く書きたい。読みやすく短く書けることを最優先にしています。
Java(1995) ― どの機械でも動かしたい。ネットワーク越しに配るなら、相手の機械が何か分かりません。
Rust(2015) ― Cの性能を保ったまま、Cの危険を減らしたい。メモリの扱いを間違えると起きる不具合を、コンパイル時に見つけられるようにしています。
並べてみると分かります。新しい言語は、その時代に切実だった問題に応えるために生まれています。
そして、問題は消えません。だから古い言語も消えない。科学技術計算はいまもあるし、OSはいまも書かれている。用途の数だけ言語が残るというのが、この分野の実態です。
「どの言語を学ぶべきか」という問いについて
学び始めるとき、誰もが一度は考える問いだと思います。私もさんざん考えました。
ここまで書いてきた内容から言えることが、ひとつあります。
翻訳の仕組みは、言語が違っても共通です。
字句解析があり、構文解析があり、木ができて、コードが生成される。変数があり、条件分岐があり、繰り返しがある。名前を付けて、値を入れて、処理をまとめて呼び出す。
これらはどの言語にもあります。表記が違うだけです。
だから、**一つの言語をきちんと理解すると、二つめは劇的に速くなります。**新しく覚えるのは表記の違いと、その言語独自の考え方だけになるからです。
逆に言えば、最初の一つを中途半端に済ませると、二つめでも同じところでつまずきます。
「どれを選ぶか」より、「選んだものを、仕組みまで理解するか」のほうが効いてくる。少なくとも私は、そう考えて学んでいます。
12. これを自分の目で確かめる方法
最後に、実践的な話をひとつ。
ここまでの内容は、**実際に自分の手で見ることができます。**読んで納得するのと、目で見るのとでは、定着がまったく違います。
~~機械語に変換された姿を見る~~
多くのコンパイラには、機械語ではなくアセンブリ言語で出力するという指定ができます。
数行の簡単なプログラムを書いて、これを試してみてください。total = price * count のような1行が、アセンブリでは複数行になることが目で見えます。
ただし、行数が第2章で挙げた七段階とぴったり一致するとは限りません。前の章で触れたとおり、一つの命令でどこまでできるかは機械によって違うからです。「1行が複数命令に展開される」という事実が確認できれば十分です。
~~「最適化なし」でも最適化されていることを見る~~
第6章で、「最適化しない」と指定しても定数の計算だけは行われることが多い、と書きました。これは自分で確かめられます。
60 * 60 * 24 を含むコードを、最適化なしでアセンブリ出力してみてください。掛け算の命令は出てこず、86400 という数値が直接現れるはずです。
「最適化なし」が「何もしない」ではないことが、これで分かります。
~~最適化の効き目を見る~~
では、最適化ありとなしで何が変わるのか。分かりやすいのは変数の扱いです。
最適化なしでは、変数の値がいちいちメモリに書き戻されます。1行ごとに「レジスタからメモリへ」「メモリからレジスタへ」の往復が入る。
最適化ありにすると、この往復が消えて、**値がレジスタに置かれたまま処理が進みます。**記事3でレジスタの役割を見ましたね。あの「作業台の上に置いたまま」の状態です。
小さな関数を呼び出しているコードなら、もう一つ分かりやすい変化が起きます。関数の呼び出しそのものが消えることがあります。中身が呼び出し元に直接埋め込まれるからです。
行数の差だけでなく、何が消えたかを見てください。そこに最適化器の判断が表れています。
~~構文木を見る~~
言語によっては、構文木そのものを出力する道具が用意されています。
自分で書いた数式が、どういう形の木になるのか。括弧を付けると木がどう組み変わるのか。第5章で図に描いた話を、実物で確認できます。
エラーが出た段階を見分ける練習
これはすぐできます。わざとエラーを起こしてみてください。
括弧を1つ消す → 構文エラー
存在しない名前を呼ぶ → 段階によって違う
0で割る処理を書く → 実行時エラー
**それぞれ、エラーメッセージの見た目が違います。**どのプログラムが出したエラーなのかが分かるようになると、原因の絞り込みが格段に速くなります。
私自身、しばらくエラーメッセージを「読むべき呪文」だと思っていました。そうではなく、あれは工程のどこかで止まった報告書です。誰が出したかが分かれば、読み方も変わります。
おわりに ― 見えてきたもの
今回は、人間の言葉が機械語になるまでを追いかけました。
出発点は、意外なところにありました。「すもももももももものうち」を読むときに、私たちが無意識にやっている作業です。
文字の列を意味のあるかたまりに切り分け、かたまり同士の掛かり方を決める。この二つを、コンパイラも例外なくやっています。名前が字句解析と構文解析に変わるだけで、中身は同じです。
そして木ができたら、型紙に穴を埋めながら機械語を吐き出し、最後に無駄を削る。
インタープリターは、これを実行しながらやります。遅い代わりに、どこでも動く。その中間として、途中まで訳しておくバイトコードがあり、さらに実行中の観測にもとづいて機械語に置き換えるJITがある。
こうして並べると、この連載で何度も出てきた型が、また出ていることに気づきます。
違いを吸収する層を挟む。層を増やすと、書く人は楽になり、少しだけ速度を失う。そして機械が速くなるほど、その取引は割に合うようになる。
織機のカードから始まって、OS、仮想機械、そして今回のコンパイラ。同じ型が、層を変えて何度も現れています。
次回は、この連載で扱ってきたものが実際にどう組み合わさるのかを見ていく予定です。ここまでで、電気からソフトウェアまで、コンピューターを下から上まで一通り登りきりました。ここから先は、その上に建つものの話になります。
参照した資料
年号・数値・統計については、以下の資料にあたって確認しました。名称のみを挙げますので、気になるものは検索してみてください。
TIOBE Index ― プログラミング言語の人気度を集計している指標。2026年9月分を参照
クックパッド開発者ブログ「日本語形態素解析の裏側を覗く!」 ― MeCabのラティス構造とコスト計算について。記事中の「東京」のコスト値はここから
OpenJDK の hotspot-compiler-dev メーリングリスト、および Microsoft と Baeldung の技術解説 ― 段階的コンパイルの判定式と閾値の既定値について
各プログラミング言語の Wikipedia 項目 ― 登場年と設計の背景
GeeksforGeeks「Phases of a Compiler」 ― コンパイラの段構成について
Wikipedia「Most vexing parse」 ― プログラミング言語に残る曖昧さの実例
そのうえで、次の点にご注意ください。
現在の統計は調査時点のものであり、変動します。JITの閾値は実行環境の版や設定によって変わる既定値です。アセンブリの出力結果は、使うコンパイラとプロセッサによって変わります。この記事で「自分で確かめられる」と書いた部分も、環境によっては違う結果になり得ます。