はじめに
これまで2本の記事で、コンピューターの世界を支える基礎を追いかけてきました。1本目では、電気信号や電波がどうやって情報を運ぶのかという「物理的な土台」を、2本目「0と1になった後の世界」では、0と1の並びが数値や文字になり、メモリやストレージにどう記録されるのかという「情報の姿」を見てきました。
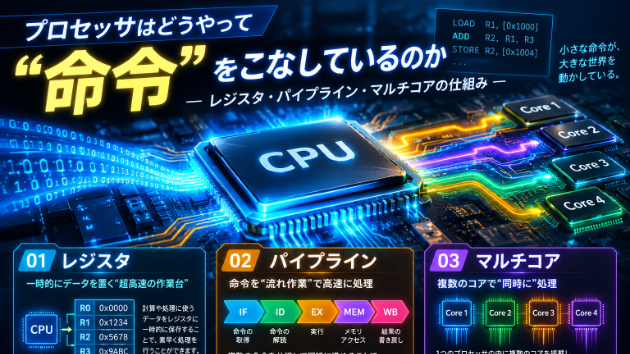
今回はいよいよ、その0と1を実際に「処理」している張本人、プロセッサ(CPU)の中身に踏み込みます。プロセッサは、私たちが書いたプログラムの命令を、文字通り毎秒何十億回というペースでこなし続けています。あの数センチ四方のシリコンの板の中で、一体何が起きているのか。レジスタ、論理ゲート、パイプライン、マルチコア、そして命令の設計方針(RISCとCISC)という切り口から、できるだけ丁寧に紐解いていきます。
なお、この記事はコンピューターアーキテクチャという分野で広く知られている一般的な概念を、私自身の理解に基づいて独自の言葉・構成・たとえ話でまとめ直したものです。特定の書籍の要約や書き写しではなく、あくまで独立した解説記事として書いています。学習中の身なので、もし説明に不正確な点があればご容赦ください。
1. なぜプロセッサには「作業スペース」が必要なのか ― レジスタという名の作業机
電卓を使ったことがある人なら、M+ や MR というボタンを見たことがあると思います。複雑な計算をするとき、いったん計算結果を M+ でメモリに保存しておき、別の計算を済ませてから MR で呼び出して続きの計算に使う。あの機能がなかったら、私たちは計算の途中経過をいちいち紙に書き写しておかなければなりません。
プロセッサも、これとよく似た問題を抱えています。プロセッサがこなす一つひとつの計算はとても単純なものばかりですが、大きな仕事を終わらせるには、その単純な計算の結果を次から次へと一時的に覚えておく必要があります。その「作業机」の役割を果たしているのが、プロセッサの内部に直接組み込まれた超高速の記憶場所、レジスタです。
前回の記事で、コンピューターにはRAM(メインメモリ)という記憶装置があるという話をしました。レジスタもRAMも「一時的にデータを覚えておく場所」という点では似ていますが、役割も規模もまったく違います。RAMは部屋の隅にある大きなファイルキャビネットのようなもので、たくさんのデータを保管できますが、プロセッサから見ると多少の「距離」があり、データを取りに行くにはそれなりの時間がかかります。一方レジスタは、作業机の上に直接置いてある数枚のメモ用紙のようなもので、容量はごくわずか(現代のプロセッサでも1つあたり32ビットや64ビット、つまり数バイト程度の情報しか入りません)ですが、プロセッサの計算回路であるALU(算術論理演算ユニット)や制御ユニットのすぐそばに配置されているため、ほとんど時間差なくアクセスできます。この「近さ」こそが、レジスタが超高速でいられる最大の理由です。
2. レジスタにも役割分担がある
「レジスタ」とひとくくりに言っても、実際には用途ごとにいくつかの種類があり、それぞれが決まった仕事を持っています。台所を思い浮かべてみてください。まな板の上で実際に手を動かしている場所(アキュムレータ)、今どの手順を見ているかを示すレシピカード立て(プログラムカウンタ)、食材の受け渡し用トレー(メモリデータレジスタ)、そしてどの棚から何を取ってくるかを示すラベル(アドレスレジスタ)――このように役割を分けて考えると、少し整理しやすくなります。
アドレスレジスタは、プロセッサがこれからRAMのどの場所(番地)にアクセスしようとしているかを保持しておくレジスタです。プロセッサは次に必要になりそうなデータやプログラムの番地をあらかじめ予測し、実際に必要になる前に先読みして準備しておくことがあります。これを**プリフェッチ(prefetch)**と呼びます。毎回RAMまで律儀に取りに行ってから作業を始めていたのでは間に合わないので、あらかじめ「たぶんこの辺りが必要になるはずだ」と見当をつけて先回りしておくわけです。
**メモリデータレジスタ(MDR: Memory Data Register)**は、RAMとプロセッサの間でやり取りされるデータそのものを一時的に保持する、いわば荷物の積み下ろし場です。RAMからデータを読み出すときはここにいったん受け取り、逆にRAMへ書き込むときはここに書き込みたい内容をセットしてから送り出します。
プログラムカウンタレジスタは、プログラムの中で「次に実行すべき命令がどこにあるか」を常に指し示しているレジスタです。1つの命令の実行が終わるたびに自動的に値が1つ進み、次の命令の場所を指すようになります。ただし、プログラムの中に「条件を満たしたら別の場所へ飛ぶ」という指示(分岐やジャンプ)があった場合には、この値がそこで書き換えられ、実行の流れが枝分かれします。
アキュムレータは、実際の計算結果を蓄えていく「作業台」そのものです。何らかの計算命令が実行されると、その結果はまずアキュムレータに格納されます。単純な設計のプロセッサでは1つしか持たないこともありますが、現代の多くのプロセッサは、同じような役割を果たす汎用レジスタを複数用意しており、計算の種類や状況に応じて使い分けています。
3. クロックのリズムに合わせて、ゲートが一歩ずつ計算を進める
前回の記事で、RAMやDDR規格の話をしたときに「クロック」という言葉に触れました。クロックとは、電気信号のON/OFFが極めて正確な間隔で繰り返される、いわば全体のリズムを刻むメトロノームのようなものです。プロセッサの中のすべての部品は、このクロックの拍に合わせて一斉に、しかし一歩ずつ動作を進めます。「3.2GHz」といった表記を見たことがあるかもしれませんが、これは1秒間に32億回もこのリズムが刻まれているという意味です。
論理ゲートという小さな判定機
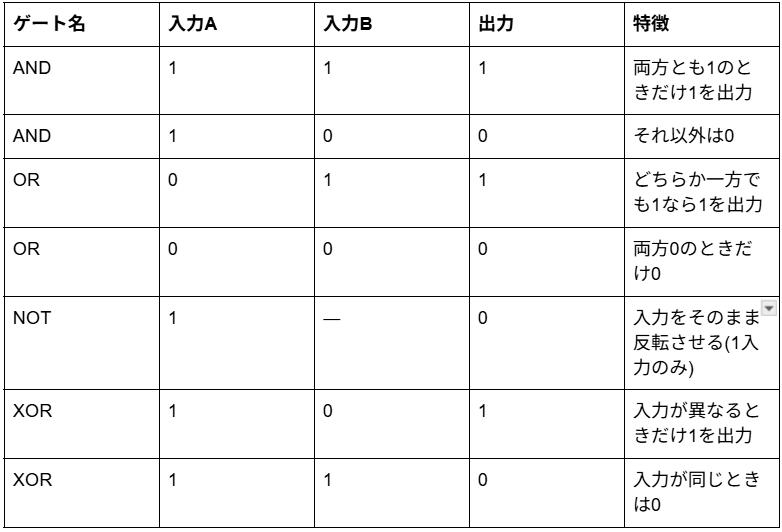
このリズムに合わせて実際に「計算」をこなしているのが、無数のトランジスタを組み合わせて作られた論理ゲートです。トランジスタは電気を通す(ON)か通さない(OFF)かのスイッチとして働き、これを0と1に対応させることで、論理ゲートは0と1の組み合わせに応じた答えを出力します。代表的なものに次のような種類があります。
このうち特に注目したいのが**XOR(排他的論理和)**です。ANDやORはすでに前回までの記事にも出てきましたが、XORは「2つの入力が異なっているときにだけ1を出す」という、少し独特な性質を持ったゲートです。この性質が、実は「足し算」を電子回路で組み立てるうえでの鍵になります。
半加算器と全加算器 ― 論理ゲートで「足し算」を組み立てる(前回のおさらい)
2進数の1桁同士を足し算する場面を考えてみましょう。0+0=0、0+1=1、1+0=1、ここまでは普通の足し算と同じですが、1+1だけは2進数では「10」、つまり繰り上がりが発生します。この「繰り上がりを除いた答え」と「繰り上がりが発生したかどうか」を同時に計算できれば、1桁の足し算が完成します。
ここでXORとANDの出番です。XORゲートに2つの入力を渡すと「繰り上がりを除いた答え」が出力され、同じ2つの入力をANDゲートに渡すと「繰り上がりが発生したかどうか」が出力されます。この2つのゲートをセットにした回路のことを半加算器と呼びます。
ただし、2桁目以降の足し算では、その桁自体の2つの数字に加えて、1つ下の桁から送られてくる「繰り上がり」も一緒に足し込む必要があります。半加算器は2つの入力しか受け付けられないので、これだけでは3つの数字(上の桁の数字2つ+繰り上がり1つ)を同時に扱えません。そこで半加算器を2段重ねにし、それぞれから出る繰り上がり信号をORゲートでまとめる回路を組みます。これを全加算器と呼び、この全加算器を桁の数だけ横に並べてバケツリレーのようにつなげることで、複数桁の2進数同士を丸ごと足し算できるようになります。
たとえば2進数の110(10進数で6)と011(10進数で3)を足す場合を考えてみましょう。一番下の桁は0+1=1で繰り上がりなし。真ん中の桁は1+1=10なので、答えは0でその上へ1繰り上がります。一番上の桁は1+0に、下から来た繰り上がりの1を足すので1+0+1=10となり、答えは0でさらに上へ1繰り上がります。最終的に繰り上がった1も含めて並べると1001となり、これは10進数で9です。6+3=9ですから、ちゃんと合っていますね。このように、下の桁から上の桁へ繰り上がりを順々にリレーしていく計算方式を「リプルキャリー(ripple carry、桁上げの波及)」と呼びます。プロセッサの内部でも、この考え方そのものが足し算回路の土台になっています。ただし、64桁ぶんの繰り上がりを律儀に1つずつ下から上へリレーしていたのでは、GHz単位の速さには到底間に合いません。そこで実際のプロセッサでは、繰り上がりをより速く行き渡らせるための工夫を凝らした回路が使われていますが、その根っこにあるのは、ここまで見てきたXOR・AND・ORの組み合わせという発想です。そうした工夫の積み重ねによって、64ビットの数値どうしの足し算のような処理も、驚くほどわずかなクロックの拍の中でこなせるようになっているのです。
4. 命令を「先読み」して手を止めない ― パイプライン処理
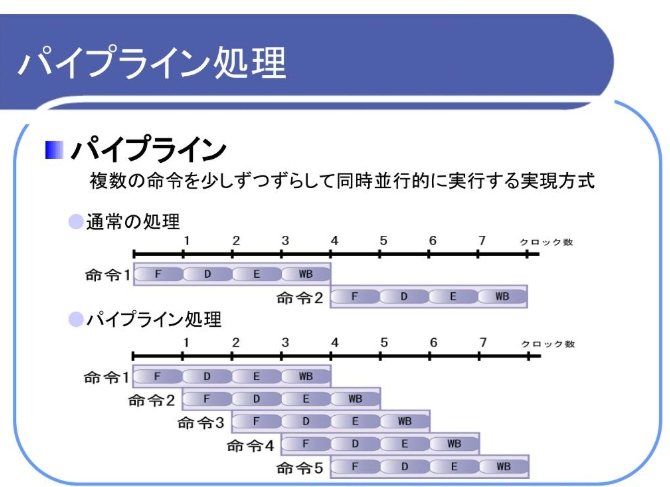
洗濯を例に考えてみましょう。洗濯物が3回ぶんあるとき、1回ぶん丸ごと「洗う→乾かす→たたむ→しまう」を終えてから次の回に取りかかっていたら、洗濯機やお日様が空いている時間がもったいないですよね。実際には、1回目を乾燥させている間に2回目を洗い始め、1回目をたたんでいる間に2回目を乾燥させ、3回目を洗い始める――というように、複数の工程を同時並行で進めるはずです。
プロセッサの中でも、これによく似た仕組みが働いています。1つの命令の処理は、大まかに「命令を取ってくる(フェッチ)→命令の意味を読み解く(デコード)→実際に計算する(実行)→結果を書き戻す(ライトバック)」という複数の段階に分かれています。もし1つの命令がこの4段階をすべて終えるまで次の命令にまったく手をつけないとしたら、パイプラインが空っぽになる時間がとても多く発生してしまいます。そこで実際のプロセッサは、ある命令が「実行」段階にいる間に、次の命令はもう「デコード」段階に進み、さらにその次の命令は「フェッチ」段階に入る、というように複数の命令を同時に、少しずつ違う段階で処理しています。これをパイプライン処理と呼びます。
このパイプラインをスムーズに流し続けるうえで厄介なのが、プログラムの中にある「もし条件Aが成り立てば処理Xへ、そうでなければ処理Yへ」という分岐です。実際に条件を確かめ終わるまで、プロセッサは処理Xと処理Yのどちらを先読みしてパイプラインに詰めておけばよいのか分かりません。そこで多くのプロセッサは、過去にその分岐がどちらに進むことが多かったかという記録をもとに「おそらくこちらだろう」と予測し、条件の判定を待たずに先読みを始めてしまいます。これを分岐予測と呼びます。まるで行きつけの定食屋の店員さんが、常連客の顔を見ただけで「今日もいつもの、ですよね」と先に仕込みを始めてしまうようなものです。予測が外れれば先読みしていた分の作業は無駄になり、改めてやり直す必要がありますが、実際の予測精度はかなり高く、多くの場面で9割前後、あるいはそれ以上の的中率になると言われています。無駄になる分を差し引いても、先読みしないよりずっと効率がよいのです。
また、プロセッサは頻繁に使う命令やデータを、RAMよりもずっと近く・ずっと高速なキャッシュと呼ばれる小さな記憶領域にコピーして持っておきます。キャッシュにも段階があり、プロセッサに一番近く一番小さいものからL1、その外側にもう少し大きなL2、というように層になっているのが一般的です。パイプラインを止めないためには、命令やデータを取りに行くたびにいちいちRAMまで往復していては間に合わないので、こうした先読みとキャッシュの組み合わせが欠かせません。
5. 1つのチップに複数の「頭脳」を ― マルチコアの仕組み
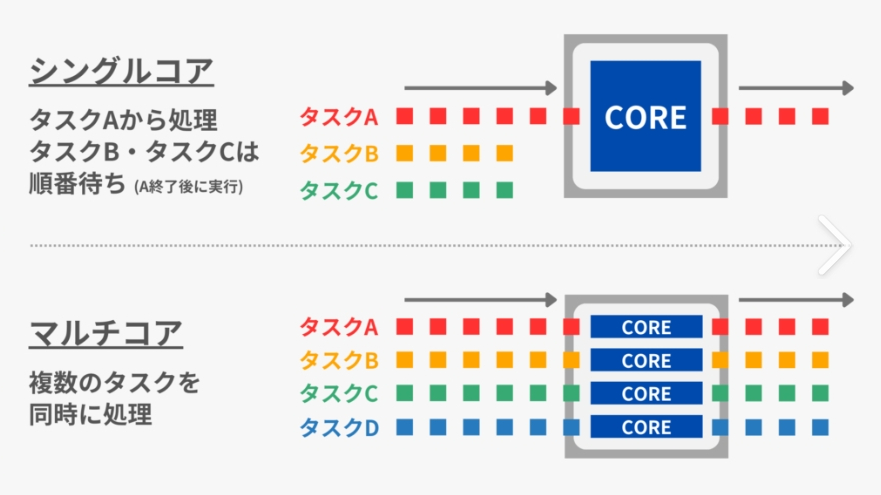
ひと昔前のプロセッサは、1つのチップの中に計算をこなす「頭脳」の役割を果たす回路(コア)が1つしかありませんでした。しかし現代のプロセッサの多くは、1つのチップの中に2つ、4つ、あるいはそれ以上のコアを内蔵しています。それぞれのコアは、レジスタもALUも制御ユニットも一通り揃った、ほぼ独立した処理装置です。つまり1つのチップの中に、複数の頭脳が同時に働いているようなイメージです。
たとえば動画を見ながらファイルの解凍を裏で走らせ、同時にウイルススキャンが動き、さらに裏でチャットアプリの通知処理もこなしている――そんな状況を考えてみましょう。もしコアが1つしかなければ、これらの処理を極めて短い時間単位で切り替えながら順番にこなす(人間の目にはあたかも同時に動いているように見える)しかありません。しかしコアが4つあれば、動画再生をコア1、ファイル解凍をコア2、ウイルススキャンをコア3、通知処理をコア4に割り振り、それぞれを本当に同時並行で走らせることができます。
このとき、どの処理(スレッド)をどのコアに割り振るかを決めているのは、OS(オペレーティングシステム)です。OSは各コアの空き状況を見ながら仕事を割り振り、状況に応じて途中で別のコアへ引っ越しさせることもあります。ただし、同じ処理はできるだけ同じコアに留めておいたほうが、そのコアの近くにあるキャッシュに必要なデータが残っている可能性が高く効率的です。この「できるだけ同じコアで動かし続けたい」という性質を親和性(アフィニティ)と呼びます。また、コアによっては共有のキャッシュ領域を複数のコアで分け合って使う設計になっていることもあります。
なお、1つの物理的なコアが、うまくタイミングを工夫することで2つの処理の流れを同時にさばいているように見せかける技術もあり、これは一般にハイパースレッディング(あるいは同時マルチスレッディング)と呼ばれています。パイプラインの中で待ち時間が生じている隙間に、別の処理の命令を割り込ませることで、コアの数以上の並列処理をこなしているように見せる工夫です。
6. 省エネ重視のRISCと、万能重視のCISC
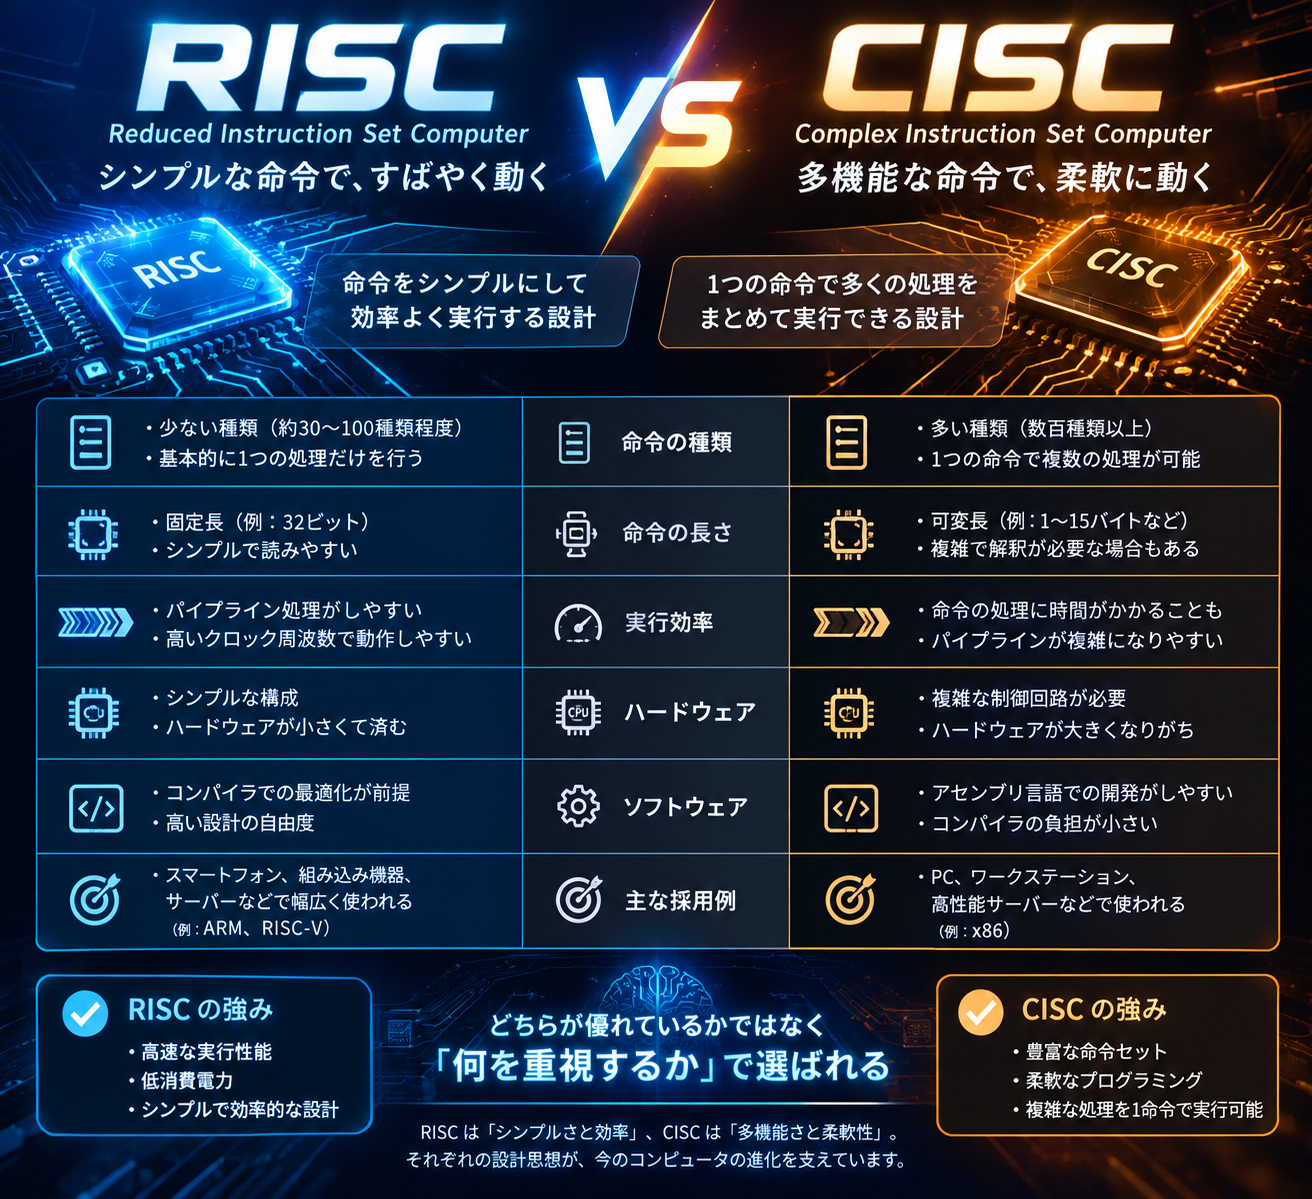
ここまで見てきた「1つの命令をどう処理するか」という話には、実はもう一つ大きな設計思想の分かれ道があります。それが**CISC(Complex Instruction Set Computing)とRISC(Reduced Instruction Set Computing)**という、命令セット(プロセッサが理解できる命令の種類や形式)をめぐる2つの考え方です。
CISCは、1つの命令にできるだけ多くの処理を詰め込もうとする設計方針です。長年デスクトップパソコンやノートパソコンの主力として使われてきたIntelやAMDのx86系プロセッサがこの方式を採用しています。命令の種類が多く、命令ごとの長さもまちまちなので、それを解読する回路はどうしても複雑になります。実際には、こうした複雑な命令をプロセッサの内部でさらに細かい単純な処理の集まりに翻訳し直してから実行している、という工夫もされています。
一方RISCは、命令の種類を絞り込み、どの命令も同じような単純な形に揃えることで、解読の回路をできるだけシンプルに保とうとする設計方針です。回路がシンプルであれば、消費電力や発熱を抑えやすくなります。そのため、バッテリーで動くスマートフォンやタブレットのような機器では、長年RISC方式――特にARMというアーキテクチャ――が主流として使われてきました。近年では、この省電力性の高さが評価され、ノートパソコンやサーバー向けのプロセッサにもRISC(ARM)方式を採用する動きが広がっています。
CISCとRISCのどちらが絶対的に優れているというわけではなく、「複雑な命令に処理をまとめて任せ、命令自体の数を減らす」か、「命令は単純にしておき、その代わりシンプルな回路で省電力・高速に動かす」かという、トレードオフの選び方の違いだと捉えると分かりやすいと思います。
まとめ ― 小さなチップの中で起きている、途方もない工夫の積み重ね
ここまで、レジスタという名の作業机から始まり、クロックのリズムに合わせて動く論理ゲート、命令を止めずに流し続けるパイプライン、複数の頭脳を積んだマルチコア、そして命令セットの設計思想であるRISCとCISCまで、駆け足で見てきました。
こうして並べてみると、プロセッサの中で行われている工夫はどれも、根っこのところで同じ課題に向き合っていることに気づきます。それは「電気信号が伝わる速さや、発熱・消費電力といった物理的な制約は簡単には動かせない一方で、こなすべき仕事はどんどん増えていく」という、避けようのないジレンマです。近くに作業スペースを置く、順番待ちをなくして流れ作業にする、頭脳そのものを複数搭載する、命令の設計をシンプルにする――どれも、この限られた土俵の中でなんとか多くの仕事をさばこうとする、地道な工夫の積み重ねなのだと思います。
1本目の記事で見た電気信号や電波、2本目で見た0と1とメモリ、そして今回見たプロセッサの仕組み。この3本を通して、コンピューターという機械が、電気信号という物理的な出来事から始まって、私たちが日々使っているアプリやウェブサイトの動きにまでつながっていく、その一連の道のりがだいぶ見えてきたのではないかと思います。ふだん何気なく使っているパソコンやスマートフォンの中で、実はこれほど緻密な仕組みが休みなく動き続けている――そう考えると、目の前の画面が少し違って見えてくるかもしれません。