前回、統計解析には
「探る(EDA)」と「確かめる(CDA)」という、
2つの側面があるという話をしました。
今回は、その「確かめる」ーー確認的データ解析(CDA)について、
もう少し詳しく見ていきます。
CDAとは何か
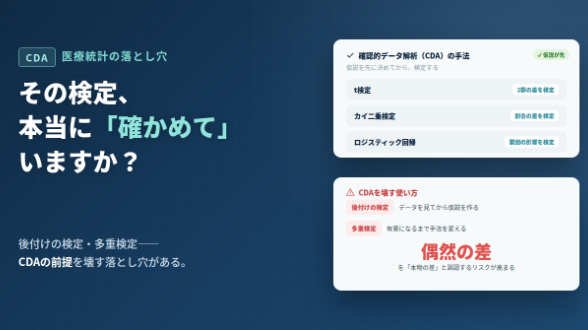
CDA(Confirmatory Data Analysis)とは、
簡単に言えば
あらかじめ立てた仮説を、データを使って検定するプロセスです。
「Aという治療を受けた群と、受けなかった群で、合併症の発生率に差があるか」
「新しい薬を使った患者と、使わなかった患者で、検査値に違いがあるか」
こうした「本当に差があるのか」を、
確率的な裏付けを持って判定するのがCDAの役割です。
t検定、カイ二乗検定、ロジスティック回帰分析といった手法は、
すべてこのCDAに含まれます。
CDAは、仮説を「先に決めておく」ことが前提
CDAの大きな特徴は、
「何を検定するか」を、データを見る前にあらかじめ決めておく
という点です。
たとえば
「介入群の方が、対照群より合併症が少ないはずだ」
という仮説を立ててから、実際にデータを集めて検定する。
この順番が守られているからこそ、出てきたp値には意味があります。
逆に、データを色々な角度から眺めた後に、
「あ、この2つの群で差がありそうだ」と
気づいてから検定をかけると、本来のCDAの前提から外れてしまいます。
これは「後付けの検定」と呼ばれ、
偶然の差を実際の差だと誤認してしまうリスクが
高まることが知られています。
CDAだけでは、実は解析は成立しない
ここで、前回の話とつながってきます。
CDAは「仮説を検定する」という重要な役割を持っていますが、
CDAを正しく機能させるためには、
いくつかの前提条件が満たされている必要があります。
・データが正規分布に近いか
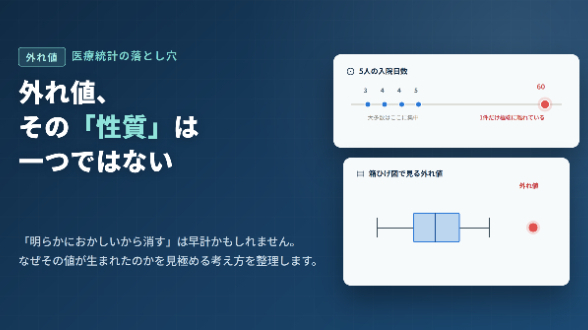
・極端な外れ値が紛れ込んでいないか
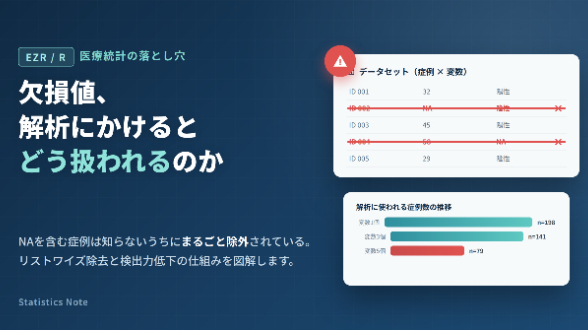
・欠損値が偏った形で発生していないか
これらの前提条件は、CDAそのものでは確認できません。
検定を実行する前に、データをよく見て、
構造や異常値を把握しておく必要があります。
つまり、
CDAという「確かめる」プロセスは、
EDAという「探る」プロセスがあって初めて、正しく機能する
ということです。
前回、外れ値が1つ混ざっているだけで
平均値が大きく歪んでしまう例を紹介しましたが、
そのような状態でCDAにかけてしまうと、
どれだけ正しい検定手法を選んでも、
出てくる結果自体が信頼できないものになってしまいます。
「先に決めておく」からこそ、慎重さが求められる
CDAのもう一つの特徴は、
後から仮説を変更しにくいという性質です。
「t検定をしてみたけど有意差が出なかったから、
今度はカイ二乗検定を試してみよう」というように、
望む結果が出るまで手法を変えて何度も検定を繰り返すと、
偶然だけで有意差が出てしまう確率が積み重なっていきます。
これは「多重検定の問題」として知られており、
CDAを正しく使うには、
最初に立てた仮説と手法を、一貫して守り抜く姿勢が求められます。
まとめ
・CDAとは、あらかじめ立てた仮説を、データを使って検定するプロセス
・t検定、カイ二乗検定、ロジスティック回帰など、手法の多くがCDAにあたる
・CDAは「仮説を先に決めておく」ことが前提であり、データを見てから仮説を後付けするのは望ましくない
・CDAの前提条件(正規性、外れ値の有無など)は、CDA自体では確認できず、EDAによって確かめる必要がある
次回は、この「探る(EDA)」と「確かめる(CDA)」
という2つの側面を統合し、統計解析全体を
一つの「過程」として捉える考え方について取り上げます。