「毎週、同じサイトを開いて一覧をコピーしている。これ、自動にできないかな?」
Webの情報をプログラムで集めることを「スクレイピング」と言います。手作業のコピペが減ってとても便利なのですが、どのサイトでも好きなだけ集めていいわけではありません。
サイトにはそれぞれルールがあり、知らずに集めると、相手のサイトに迷惑をかけたり、あとでデータが使えなくなったりすることもあります。今日は、集め始める前に確かめておきたい4つのことを、確かめる順番にご紹介します。
1. 「公式の入手方法」がないか探す
最初に見るのは、そのサイトが情報を配っていないかどうかです。
・一覧をCSVやExcelでダウンロードできるボタンがある
・「API」と呼ばれる、プログラム向けの公式の受け取り口がある
・メールマガジンや更新のお知らせで、同じ情報が届く
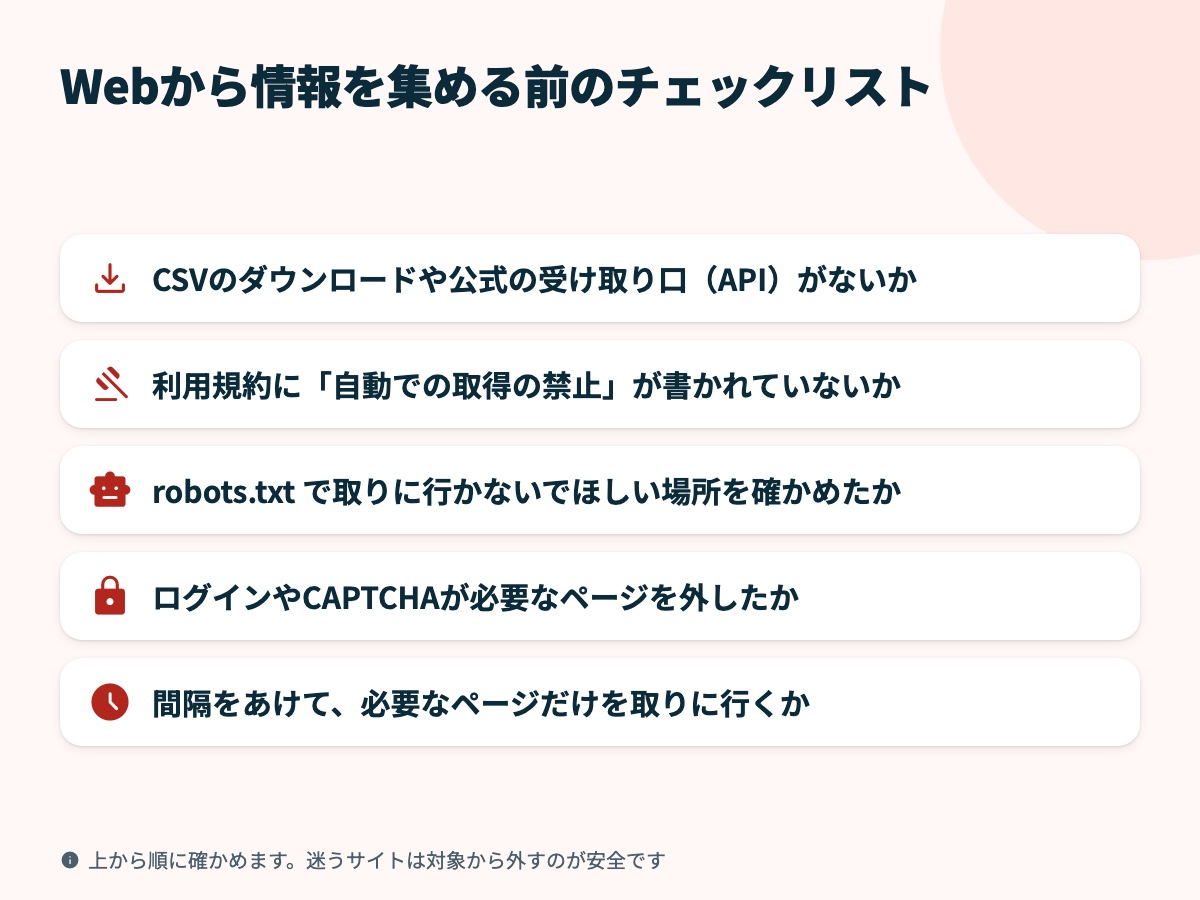
たとえば、お店の一覧や商品の価格表は、提供元が更新のたびにファイルを用意していることもあります。公式の方法があるなら、そちらを使うのがいちばん安全で、手間も少なく済みます。集める前に、まず「配っていないか」を探すのが近道です。
2. 利用規約と robots.txt を読む
公式の方法がないときは、サイトのルールを確かめます。
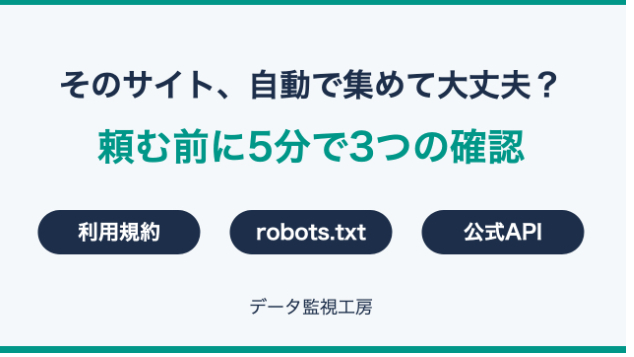
1つ目は利用規約です。ページのいちばん下に「利用規約」や「ご利用にあたって」というリンクがあることが多いです。「自動的な手段での取得を禁止します」のような一文があれば、そのサイトは対象から外します。
2つ目は robots.txt(ロボッツ・テキスト)です。サイトの住所の最後に「/robots.txt」を付けて開くと、プログラムに見てほしくないページの一覧が書かれています。「Disallow」のあとに書かれた場所は、取りに行かないのがマナーです。どちらも、サイトが変わると内容が変わることがあるので、ときどき読み直しておくと安心です。
3. 相手のサイトに負担をかけない
ルール上は問題がなくても、短い時間にたくさんのページを開くと、相手のサーバーに負担がかかります。
・1ページごとに間隔をあけて取りに行く
・必要なページと項目だけに絞る
・ログインが必要なページや、画像で文字を確かめる仕組み(CAPTCHA)があるページは対象にしない
ログインのあとに見えるページは、利用者だけに向けた情報です。自分のアカウントで見られるからといって、プログラムで集めてよいとは限りません。また、一度にまとめて取るより、必要な分を少しずつ取りに行くほうが、相手にもやさしい集め方です。
4. 集めたあとの「使い道」を決めておく
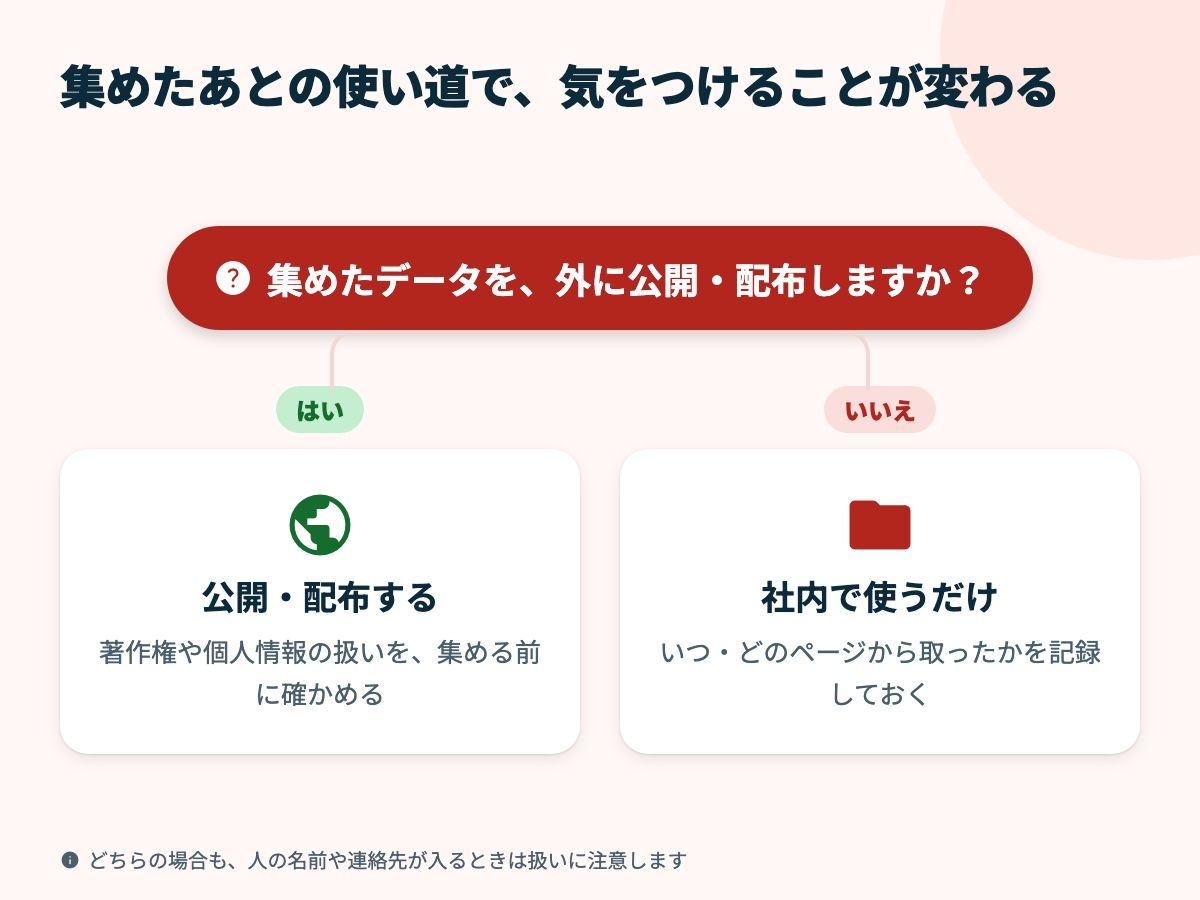
最後に、集めたデータを何に使うかを考えます。社内で比べるための資料に使うのと、自分のサイトに載せて公開するのとでは、気をつけることが変わります。
・文章や画像をそのまま公開・配布すると、著作権の問題になることがある
・人の名前や連絡先が入っているときは、個人情報としての扱いが必要になる
・いつ、どのページから取ったかを記録しておくと、あとで確かめやすい
公開するつもりなら、集める前に使い方を確かめることをおすすめします。
ここまで確かめたうえで、毎回の手作業を減らしたいときは、収集とツール作りをお手伝いしています。取得の前に利用規約と robots.txt を確認し、取れなかった項目の一覧も付けてお渡ししています。
まとめ:集める前の4つの確認
・公式の入手方法がないか探す
・利用規約と robots.txt を読む
・相手のサイトに負担をかけない
・集めたあとの使い道を決めておく
ルールを守って集めたデータは、安心して長く使えます。まずは、いつもコピーしているサイトの利用規約を一度読んでみるところから始めてみてください。
集めたデータを毎回Excelで整える作業があるなら、そちらの自動化もご相談いただけます。