サービス
サービスを探す
プロ人材を探す
仕事を探す
ブログを探す
サービス
サービスを探す
プロ人材を探す
仕事を探す
ブログを探す
購入・発注したい方
サービスを探す
プロ人材を探す
コンテンツを探す
ブログを探す
仕事・求人を投稿して募集
エージェントに人材を紹介してもらう
受注・働きたい方
出品する
単発の仕事を探す
継続 (時給/月給) の仕事を探す
エージェントに仕事を紹介してもらう
カテゴリ一覧
イラスト作成・漫画制作
デザイン制作
Webサイト制作・Webデザイン
動画編集・映像制作
集客・マーケティング相談
ビジネス代行・事務代行
音楽制作・ナレーション
IT相談・システム開発
ライティング・翻訳
コンサルティング・士業
生成AI活用・開発・制作
占い
悩み相談・カウンセリング
学習指導・資格・キャリア相談
住まい・美容・生活相談
オンラインレッスン・習い事
ハンドメイド制作
出張撮影・出張サービス
マネー・副業・アフィリエイト
弁護士検索・法律Q&A(法律相談)
サポート
はじめての方へ
ご利用ガイド
お困りのときは
ログイン
会員登録
サービスを探す
イラスト作成・漫画制作
デザイン制作
Webサイト制作・Webデザイン
動画編集・映像制作
集客・マーケティング相談
ビジネス代行・事務代行
音楽制作・ナレーション
IT相談・システム開発
ライティング・翻訳
コンサルティング・士業
生成AI活用・開発・制作
占い
悩み相談・カウンセリング
学習指導・資格・キャリア相談
住まい・美容・生活相談
オンラインレッスン・習い事
ハンドメイド制作
出張撮影・出張サービス
マネー・副業・アフィリエイト
プロ人材を探す
コンテンツを探す
ブログを探す
求人募集を投稿する
人材を紹介してもらう
仕事を探す
出品する
仕事を探す
仕事を紹介してもらう
出品する
仕事を紹介してもらう
求人募集を投稿する
人材を紹介してもらう
ブログを投稿
会員登録で10%割引クーポンを獲得!
会員登録で10%割引クーポンを獲得!
ココナラブログ
ホーム
ブログトップ
ブログ
IT・テクノロジー
AIに「比べられません」と言わせるには? BioBasicsBenchから学ぶ数字の見方
記事
IT・テクノロジー
SIN(MORI)|AI活用・業務整理
2026/11/07 14:45
「今週の問い合わせは32件、先週は20件。仕事が増えましたね」。AIからそう返ってきたとき、数字の前に見るべきなのは、同じ範囲を数えたかどうかです。今週はメールとフォーム、先週はメールだけなら、合計を並べても増えたとは言えません。
1.AIは根拠の不足に気づけるか
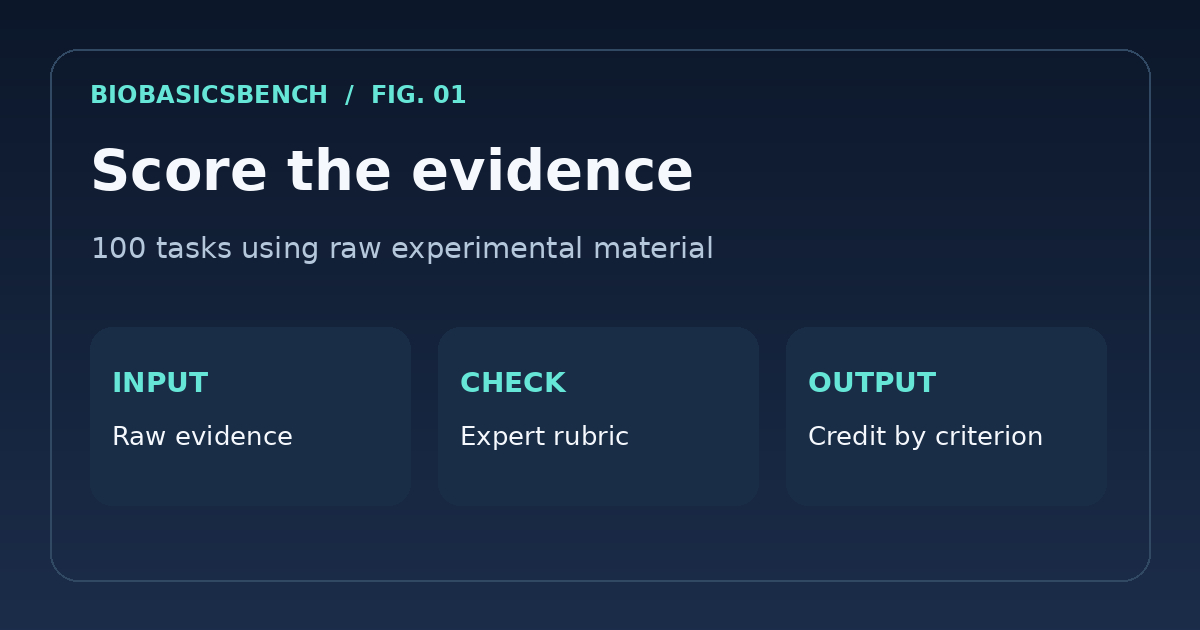
OpenAIとLigoは2026年11月6日、BioBasicsBenchという評価を公表しました。実験の画像や測定器から取り出した表などを使い、生の資料を読めるか、誤りや判断材料の不足に気づけるかを100課題で測ります。課題によっては結論に加え、その根拠にも点をつけます。
図1|生の資料を読み、根拠を項目ごとに確かめる
2.平均点と、実際の仕事での成功率は別
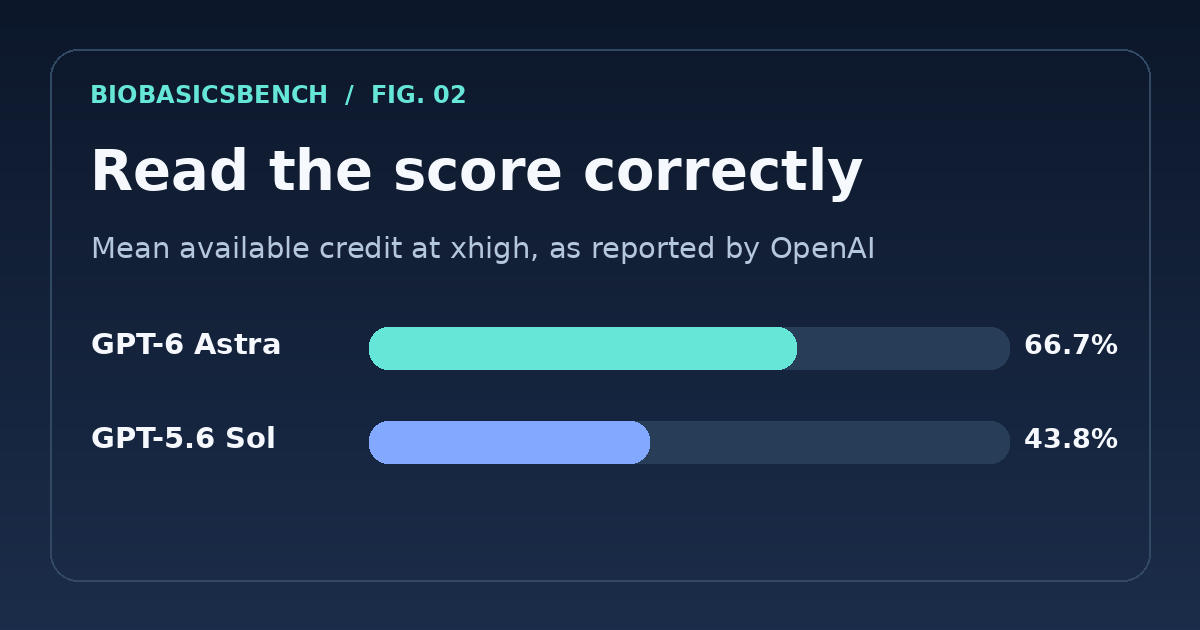
発表元によると、推論設定xhighでGPT-6 Astraは平均66.7%、GPT-5.6 Solは平均43.8%の配点を得ました。各設定で100課題を5回ずつ試した結果です。この点数は課題の採点基準に沿った平均で、現場での成功率や第三者による再現結果を示すものではありません。製品の新機能を提供し始めたという発表でもありません。
図2|発表元が報告した平均得点
3.今日試せる短い指示
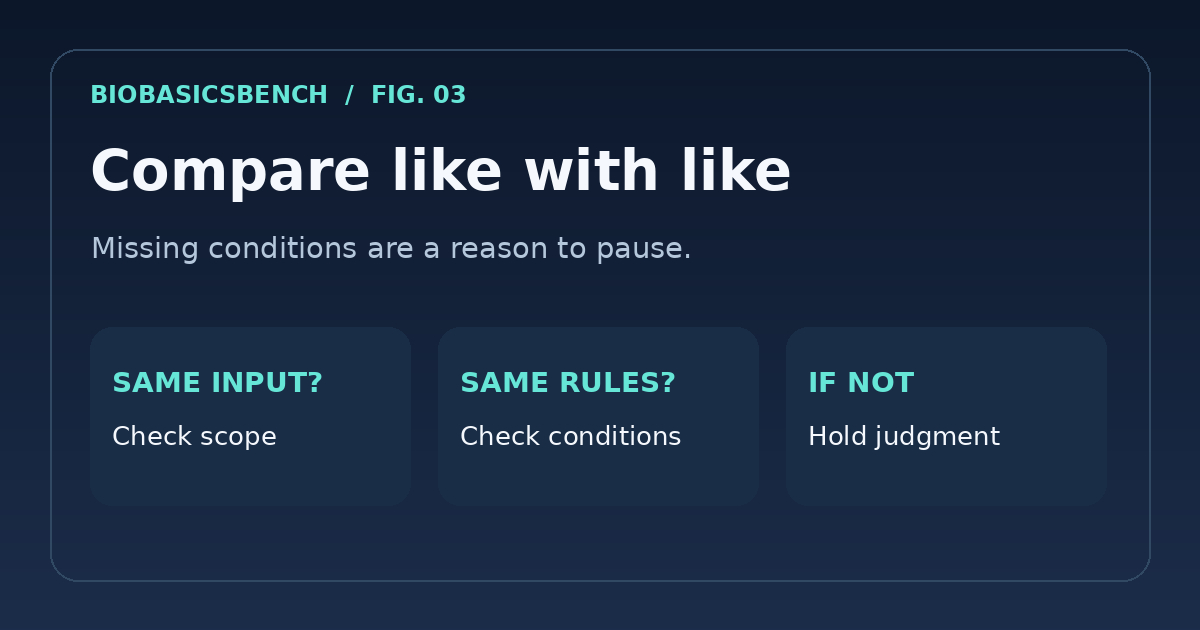
架空の問い合わせ表を用意し、「件数を比較する前に、集計期間・対象・数え方を照合してください。条件が違うか書かれていなければ、結論を出さずに不足を一つ返してください」と頼んでみます。冒頭の例なら、まず両週ともメールだけにそろえた件数を集めます。
図3|比較条件が違うなら、結論をいったん保留
まとめ
数字が正しく読めたかと、その数字から結論を出せるかを分けて確かめる。まずは比較できる表と、条件が一つだけ違う表を用意すると、AIが違いに気づけるかを見比べられます。本稿は公式発表の解説で、ベンチマークを再現したものではありません。
出典:OpenAI「Measuring how AI agents handle everyday wet-lab science」(2026年11月6日)。
定型報告など、繰り返す文章業務の指示と確認手順を整理したい方へ。
実務プロンプトと運用手順マニュアルを作ります
#AI活用
#データ分析
#業務改善
背景だけ直すには? OpenAI Images 2...
一覧に戻る
このブログを見た人にオススメ
AIに調べ物を分担させたら、結果をどう確かめる? 脳細胞データ研究から
記事
IT・テクノロジー
SIN(MORI)|AI活用・業務整理
2026/11/06 15:33
事務代行を頼んでも、AIを導入しても、なぜ社長の仕事が減らないのか?
記事
ビジネス・マーケティング
きなこ:運営サポート
2026/11/06 12:24
売上の分析をAIに任せた
記事
ビジネス・マーケティング
MATSURYU|まつりゅう
2026/11/05 20:02
AIに物販作業を相談するとき、実際の注文データは必要ですか?
記事
ビジネス・マーケティング
Bone Amazon物販・越境EC相談
2026/10/28 15:53
ChatGPTの回答が毎回ズレるとき、指示文を長くする前に確認したい4つのこと
告知
IT・テクノロジー
橘 和真|調査・整理・制作
2026/11/05 10:10