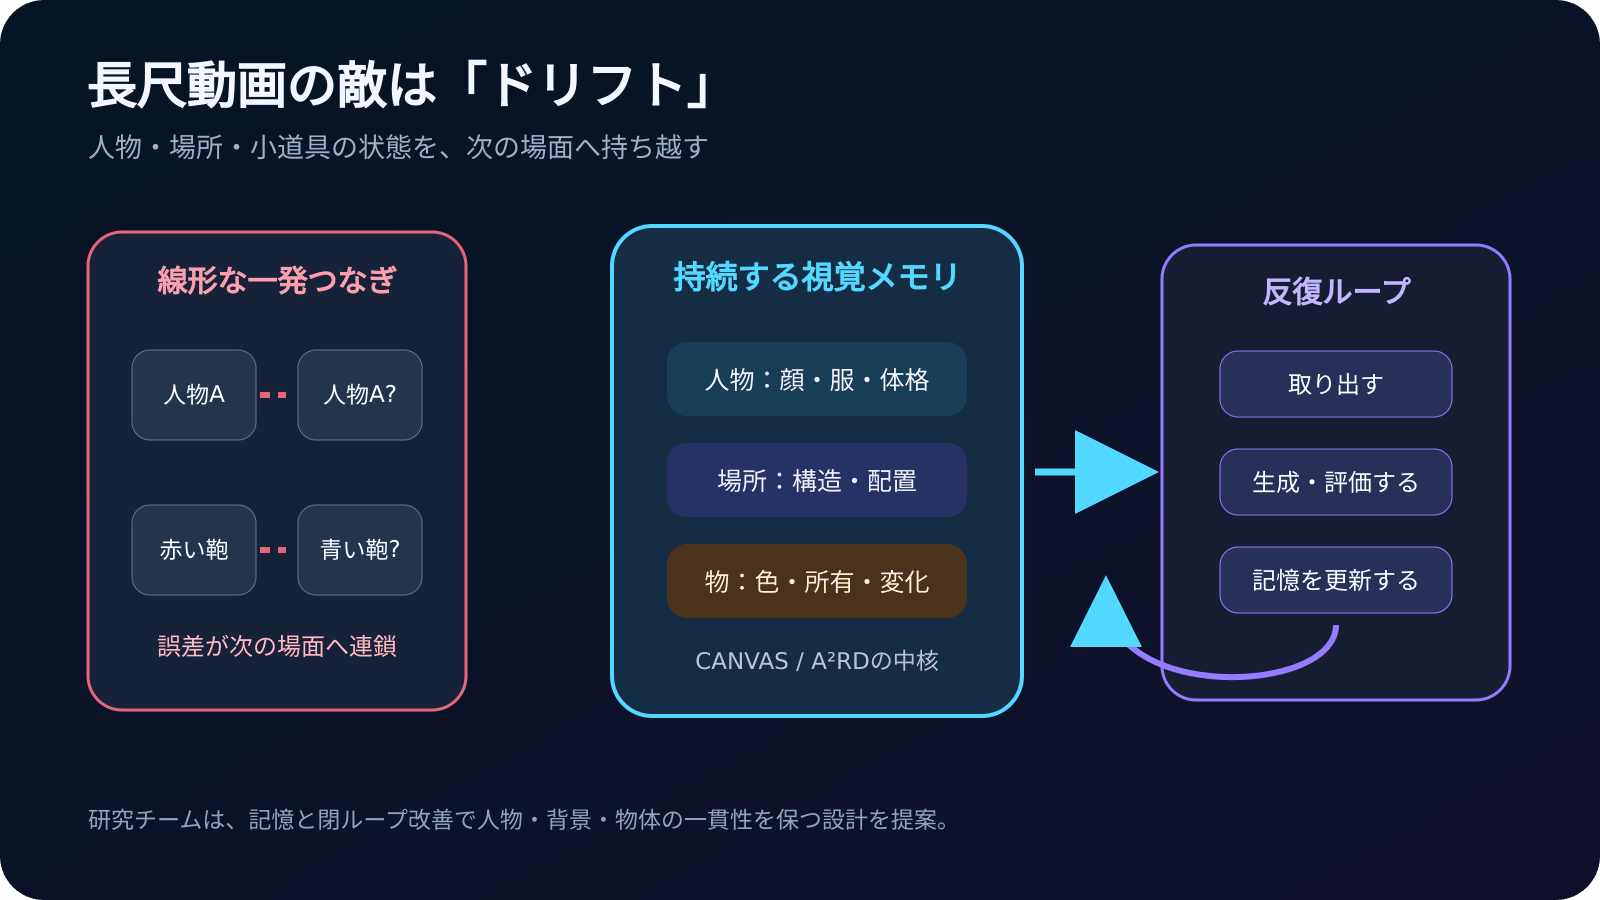
短いAI動画は驚くほどきれいになりました。けれど、数分の物語に伸ばすと、同じ人物の服が変わる、部屋の配置がずれる、小道具が別物になる――そんな「長尺ならではの崩れ」が起きやすくなります。
2026年11月1日再確認:本稿は9月24日のGoogle Researchによる長尺動画研究の紹介を振り返り、分業・記憶・検証の仕組みを整理したものです。今回の製品発売ニュースではありません。
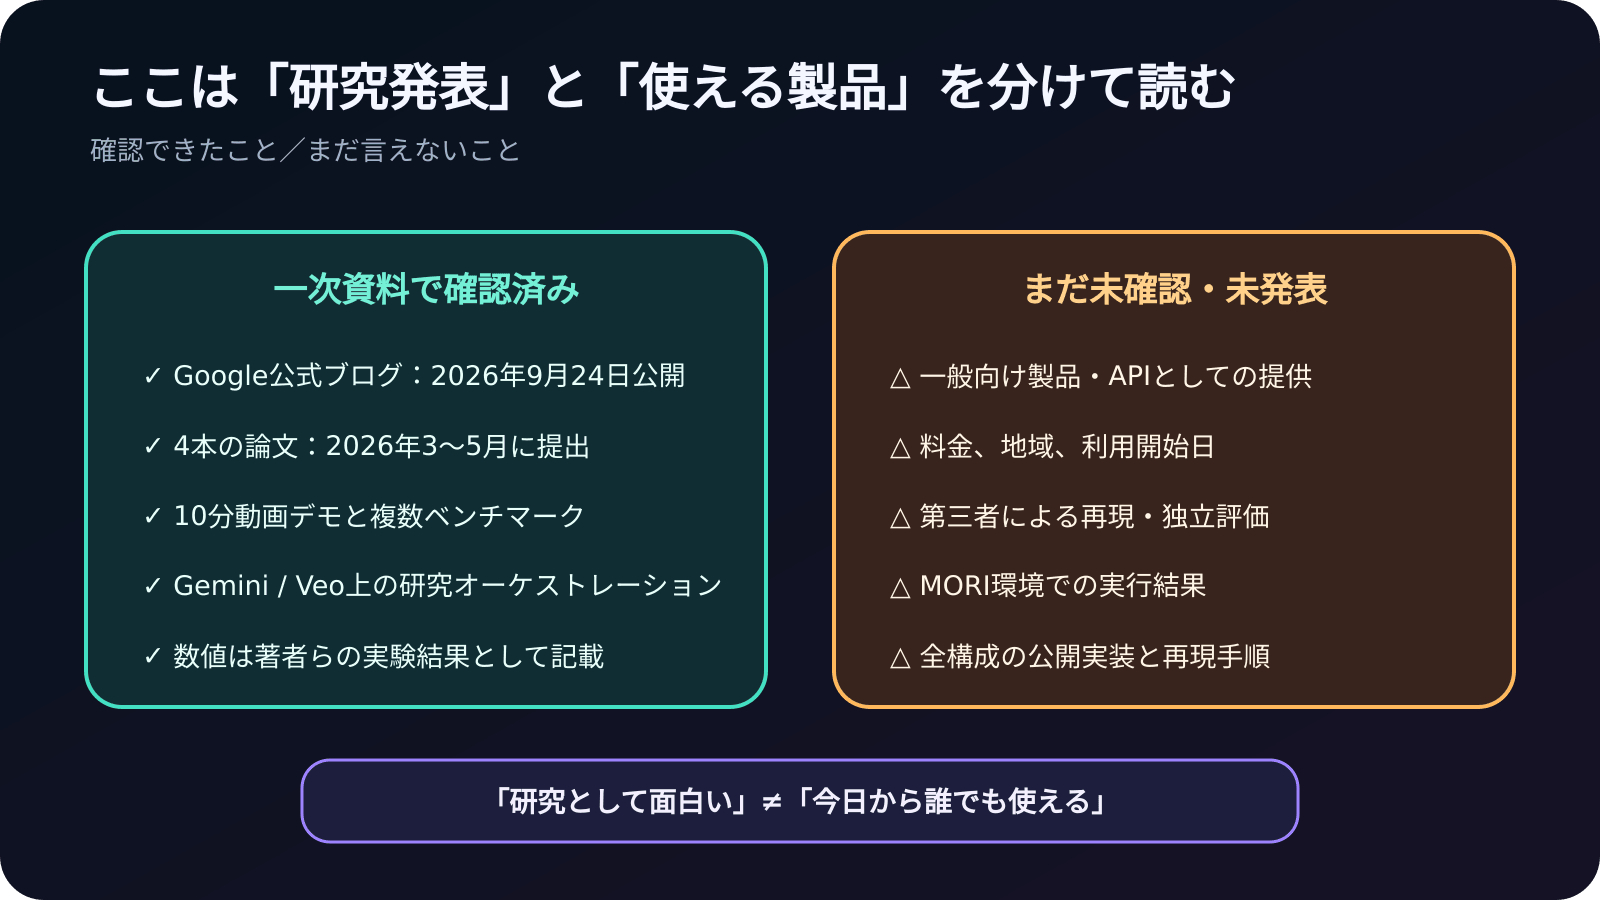
公式ブログは4研究を紹介しています。論文の初回提出は2026年3〜5月で、ブログ掲載日とは異なります。同ブログを再確認した範囲では、一般向けAPI・料金・地域・利用開始日の案内は確認できません。世界中で関連製品が存在しないことを意味するものではありません。
何が変わったのか
中心にあるのは、映画制作のような分業や、制作中の状態を保つ仕組みです。以下は一つの統合製品の工程ではなく、それぞれの研究が扱う役割です。
1. Co-Directorが作品全体の創作戦略、物語形式、画調を選ぶ
2. CANVASが人物・場所・小道具の状態を記憶し、絵コンテの連続性を保つ
3. A²RDが映像を区間ごとに生成し、過去の映像記憶を参照しながら次の区間を作る
4. VQQAが完成映像へ質問し、見つけた不整合を言葉のフィードバックとしてプロンプトへ戻す
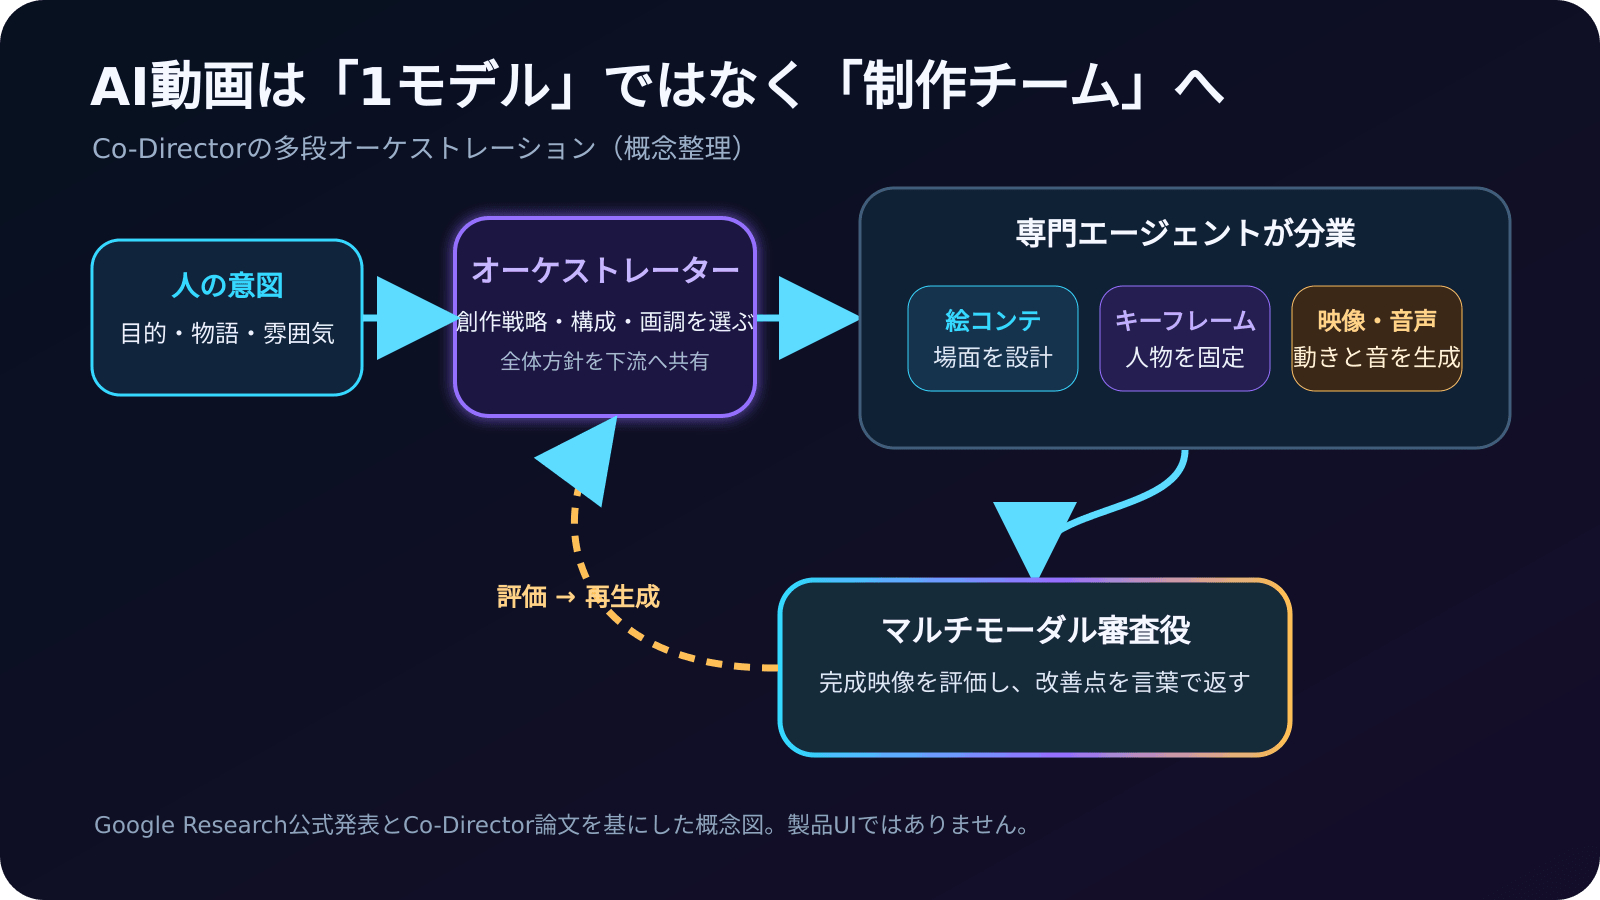
Co-Directorでは、オーケストレーターが全体方針を決め、プリプロダクション、キーフレーム、映像、音声の各エージェントへ共有します。最後にマルチモーダルLLMの審査役が完成版を評価し、その結果を次の生成ループへ戻します。
ポイントは、単にAIを複数並べたことではありません。全体方針、制作状態、評価結果を共有し、局所的な修正で物語全体を壊さないようにしたことです。
「前の場面を覚える」が長尺化の鍵
CANVASは、人物の外見、場所の構造、小道具の状態を持続的な視覚メモリとして管理します。A²RDは、映像を「取り出す→生成する→改善する→記憶を更新する」という閉ループで区間ごとに伸ばします。
研究チームは、A²RDで1〜10分の動画を評価し、既存手法より一貫性が最大30%、物語の整合性が最大20%向上したと報告しています。CANVAS論文では、最良の比較手法に対し、背景の連続性21.6%、人物の一貫性9.6%、小道具の一貫性7.6%の改善を報告しています。
ただし、これらは著者らのベンチマークと人手評価による主張です。独立した第三者検証とは分けて受け取る必要があります。
AIが自分の映像へ質問する
VQQAの発想も面白いところです。評価AIは、映像に合わせて「人物は場面転換後も同じ楽器を持っているか」「物体の材質は指示どおりか」といった質問を作り、その答えを改善方向として使います。
画素を直接修正するのではなく、問題を言葉で説明し、生成プロンプトを調整して作り直します。さらに最後の版を無条件で採用せず、生成した候補を元の指示と照合し、最も良いものを選ぶ設計です。
VQQA論文は、通常生成に対してT2V-CompBenchで11.57ポイント、VBench2で8.43ポイントの絶対改善を報告しています。ここも同じく、現時点では研究チームによる評価です。
日常の文章業務へ持ち帰るなら
ここからは動画研究を手がかりにした本稿の応用例です。文章業務で同じ改善率が得られると検証されたわけではありません。
例えば、架空の商品紹介文を作るなら、企画・文章作成・出典確認を分け、共通の目的と変更してはいけない条件を残す方法が考えられます。
- 一つのAIへ全部を任せず、企画・制作・評価を分ける
- 長い仕事では、人物や目的などの状態を外部記憶として持つ
- 評価結果を次の実行へ戻し、最後の出力だけでなく改善の循環を設計する
今日試す小さな一歩は、実在の顧客情報を使わず、「入力:架空の商品説明」「変えてよい範囲:語尾だけ」「確認結果:価格・名称は維持」の3行をメモすることです。これは手順を考えるための架空例で、実行済みの成果報告ではありません。
まとめ
Google Researchが2026年9月24日に紹介した4研究は、長尺AI動画を一発生成の問題から、制作工程と検証ループの設計問題へ置き換えました。
人物や場所の記憶、専門AIの分業、完成映像への質問、候補全体からの再選択。どれも、AI制作を長く・複雑にするほど重要になる仕組みです。
2026年11月1日に公式ブログと4論文の要旨を再確認しました。本稿では研究の実装・動画生成・独立した性能検証は行っていません。研究結果、製品の提供状況、自分の業務での効果を分けて判断してください。
出典
- Google Research, “Automating coherent long-form video generation” (2026-09-24)
- Co-Director: Agentic Generative Video Storytelling (arXiv:2604.24842, submitted 2026-04-27)
- CANVAS: Continuity-Aware Narratives via Visual Agentic Storyboarding (arXiv:2604.13452, submitted 2026-04-15)
- A²RD: Agentic Autoregressive Diffusion for Long Video Consistency (arXiv:2605.06924, submitted 2026-05-07)
- VQQA: An Agentic Approach for Video Evaluation and Quality Improvement (arXiv:2603.12310, submitted 2026-03-12)
文章業務の手順を整理したい方へ
動画制作サービスの案内ではありません。身近な文章業務1種を、実務プロンプトと運用手順マニュアルに整理する相談窓口です。提供範囲はサービスページで確認してください。