【9月25日確認時点の記録/11月1日の再確認は末尾に追記】
Alibaba Cloudは2026年9月22日、AI戦略に関する発表の一環として、音声生成モデル「Qwen-Audio-3.1-TTS-Next」を案内した。テキストの台本から、セリフ(会話)と環境音・効果音を組み合わせた音響表現を一度に生成できるモデルとして紹介されている。
公式発表によると、同モデルはオーディオブック、映画・テレビ番組、ポッドキャスト、ゲームといったプロ向けの制作用途を想定して設計されているという。「映画のような音響表現をまとめて作り出せる」という趣旨の説明がなされているが、これはAlibaba側の訴求表現であり、独立した第三者機関による品質評価ではない点には留意したい。
今回、発表元のプレスリリースとは別に、Alibaba Cloudが公開している開発者向けのモデル資料(Model Studioのドキュメント)も確認した。同資料は、Qwen-Audio-3.1-TTS-Nextの推論サービスとHTTPS APIによる利用方法を案内しており、複数話者による対話(マルチスピーカー)にも対応しているという。生成できる音声の長さには上限があり、ポッドキャスト用途では最大240秒(4分)、それ以外の用途では最大120秒とされ、入力できるテキストは最大3,000文字までとされている。対応言語としては中国語と英語が明記されており、今回確認した資料の範囲では日本語対応についての記載は見当たらなかった。料金は、中国(北京)リージョンにおいて100万トークンあたり入力0.848ドル・出力1.696ドルと案内されているが、この料金・提供地域の情報は中国リージョンについてのものであり、他地域での提供状況や商用利用条件は今回確認できていない。
なお、今回の発表はAlibabaの音声・画像関連モデル群をまとめて紹介するものの一部であり、通常版のTTSモデルや音声認識(ASR)、リアルタイム対話モデル、同時通訳モデル「LiveTranslate」、スマートフォン向けAIエージェント基盤「Qwen Intelligence」なども同時に言及されている。これらは今回のQwen-Audio-3.1-TTS-Nextとは別のモデル・サービスであり、本稿ではTTS-Nextに絞って扱った。
【出典】
Alibaba CloudのフルスタックAI戦略に関する公式発表(2026年9月22日)、Model Studio公式ドキュメント「Qwen-Audio-3.1-TTS-Next」。
【2026年11月1日追記:現行資料で確認したこと】
9月の発表を振り返り、10月30日更新のモデル資料と10月22日更新のAPI資料を再確認しました。音声生成の実演・日本からの接続試験は行っていません。
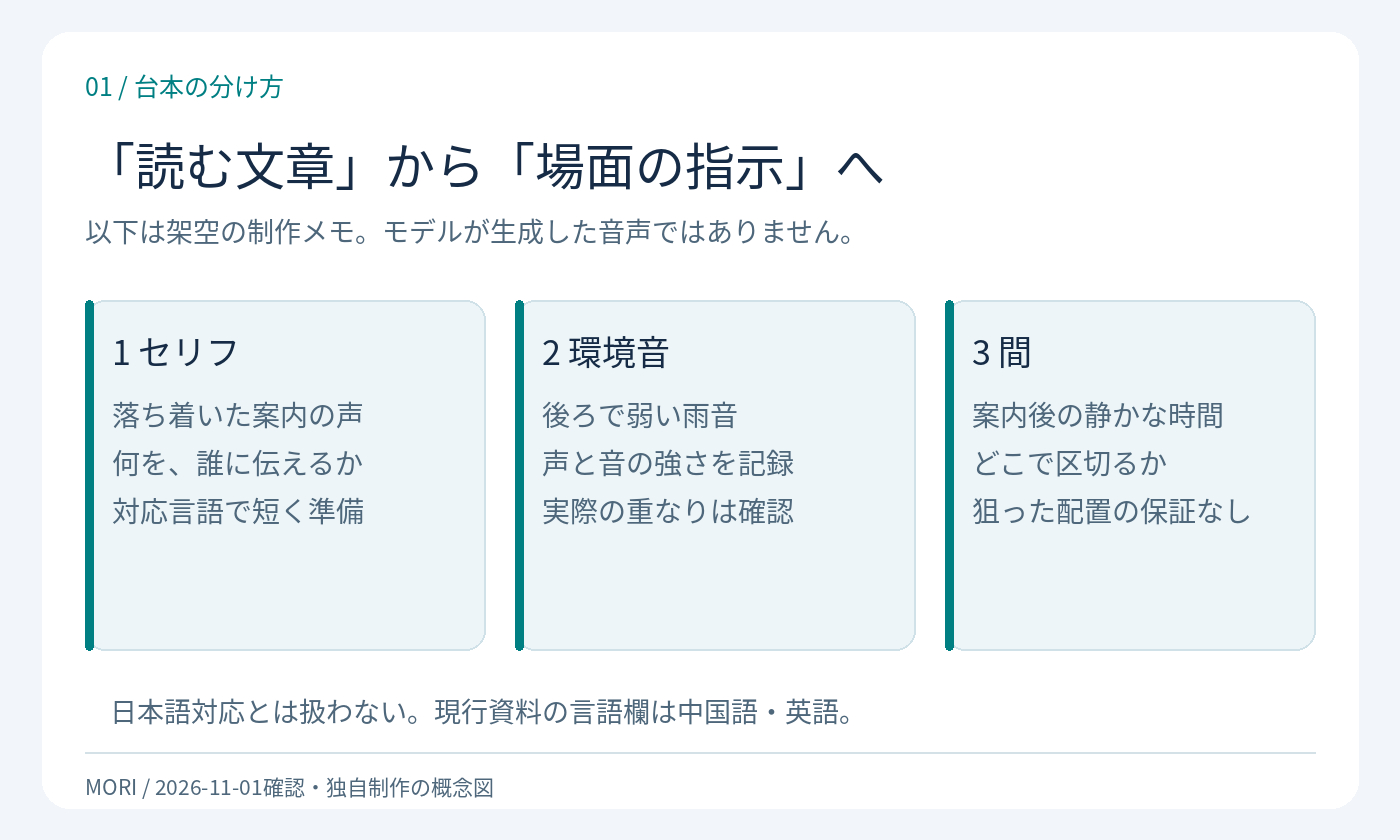
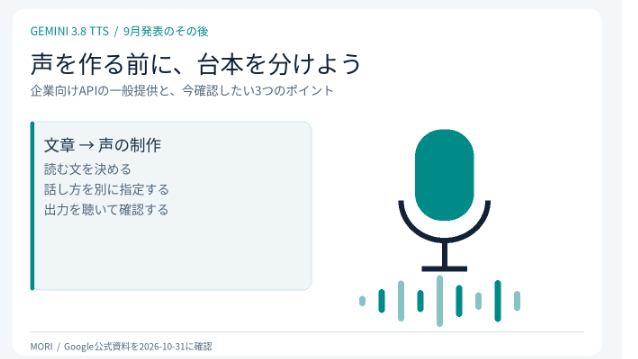
1.セリフ・環境音・間を分ける
公式は会話・効果音・環境音をまとめる音声生成を案内しています。ここからは制作上の提案です。架空の読書案内なら「落ち着いた案内の声/弱い雨音/案内の終わりの静かな時間」を別々に準備します。現行の対応言語欄は中国語と英語です。日本語対応として扱わず、対応言語の短い台本から確認します。
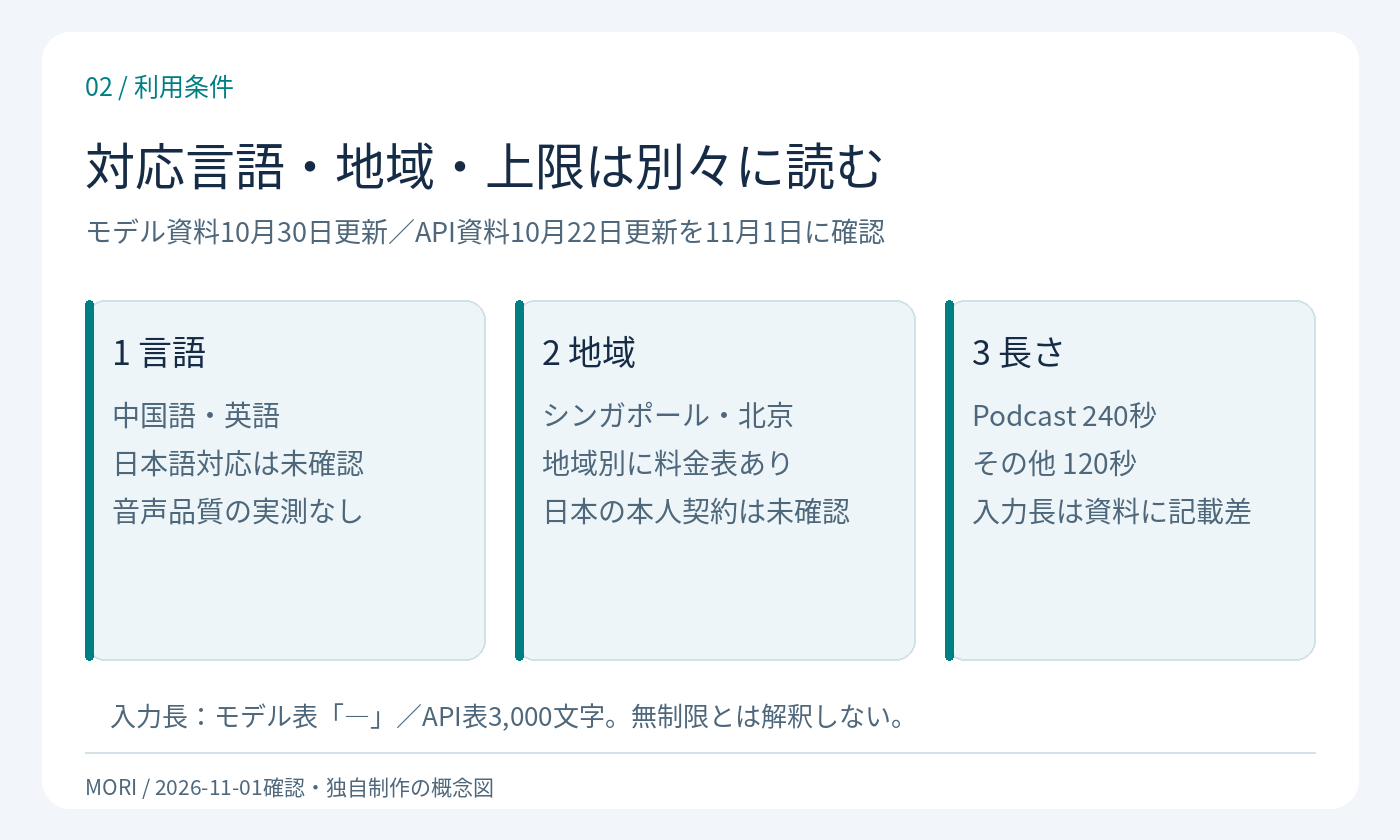
2.地域と入力条件を分けて読む
現在のモデル資料にはシンガポールの掲載単価(100万トークン当たり入力0.93米ドル・出力1.87米ドル)もあります。北京は入力0.848米ドル・出力1.696米ドル。キャンペーンを除く単価で、文字数や秒数から直接費用を求めた値ではありません。日本在住の本人契約での利用、商用条件は未確認です。
生成上限はポッドキャスト240秒、その他120秒。入力長はモデル表が「―」、API対応モデル表が3,000文字と記載が異なります。上限撤廃とは解釈せず、実装時に当該API条件を確認してください。
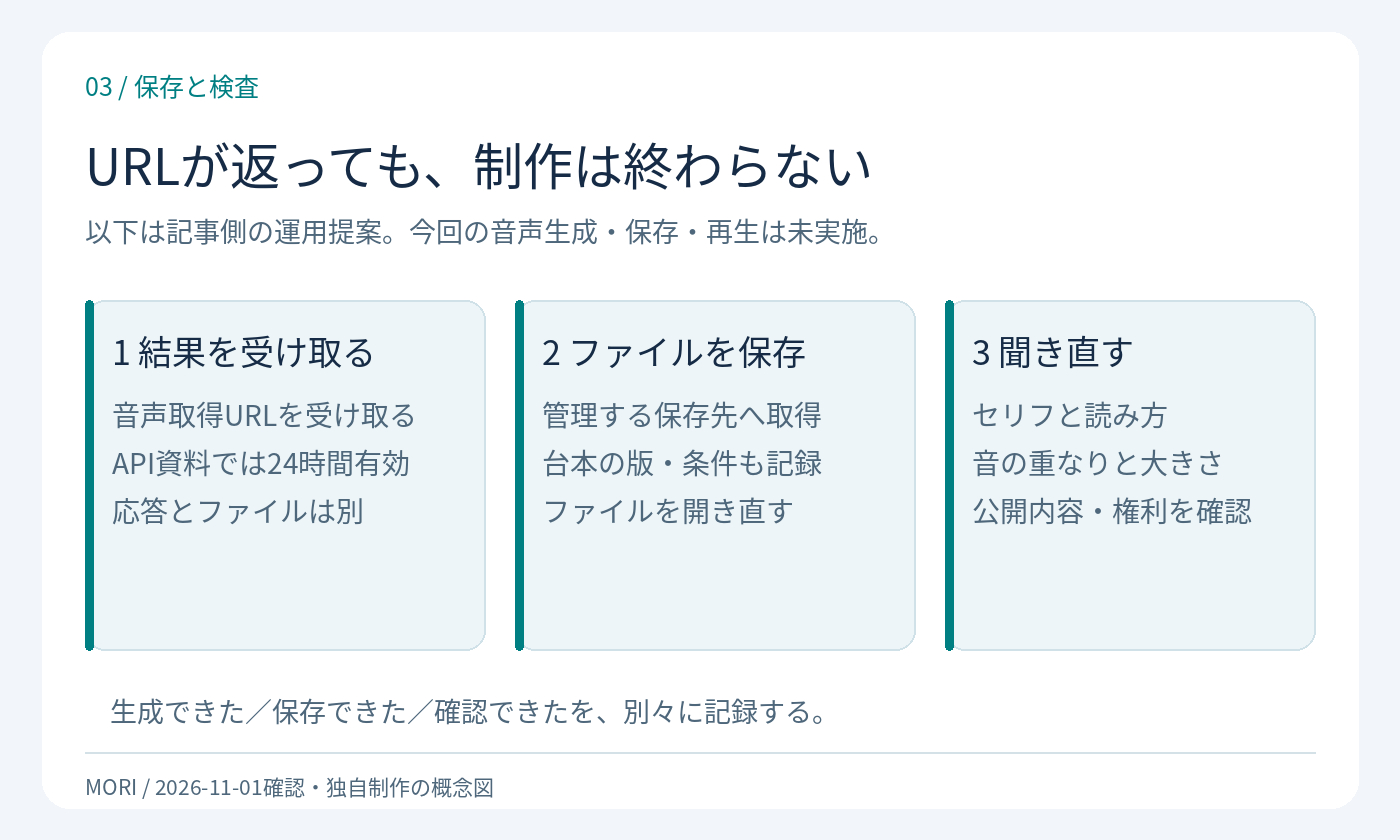
3.結果URL・保存・聞き直しを別々に確認
API資料は音声の取得URLが24時間有効と案内しています。以下は記事側の提案です。取得後に管理する保存先へ音声を保存し、開き直してセリフ・音の重なり・聞き取りやすさを確認します。台本の版・生成条件・ファイル名を一緒に残すと、差し替え時にも確認できます。生成上限は狙った長さ・配置の保証ではありません。参照音声は権利と本人の同意を確認します。
まとめ
まず「セリフ/環境音/間」の3行を作り、対応言語・自分の利用条件を確かめてから試す順番です。今回確認したのは資料とローカルJSON準備コードで、モデルAPIの実行、音声生成、生成音声の保存・再生は行っていません。
追記の出典(2026年11月1日確認)
Alibaba Cloud公式発表「Alibaba Unveils Roadmap on Full-Stack AI Strategy from Chips, Cloud Infrastructure, Models to Agents」(2026年9月22日)。
Model Studio「qwen-audio-3.1-tts-next」(更新10月30日)。
Model Studio「Audio generation API reference」(更新10月22日)。
音声の前に、文章業務の依頼を整えたい方へ
報告文など文章業務1種類について、AIへの指示と人が確認する手順を整理するサービスをご案内しています。音声生成・音響編集・API実装・アカウント操作・自動送信は含みません。
※追記と独自図版の制作にAIを補助的に使用し、公式資料と照合しています。