「ローカルLLM(自分のPCの中で動くAI)を試したいけど、自分のPCで動くのかわからない」
「GPUを買う前に、どれくらいの速さになるか知りたい」
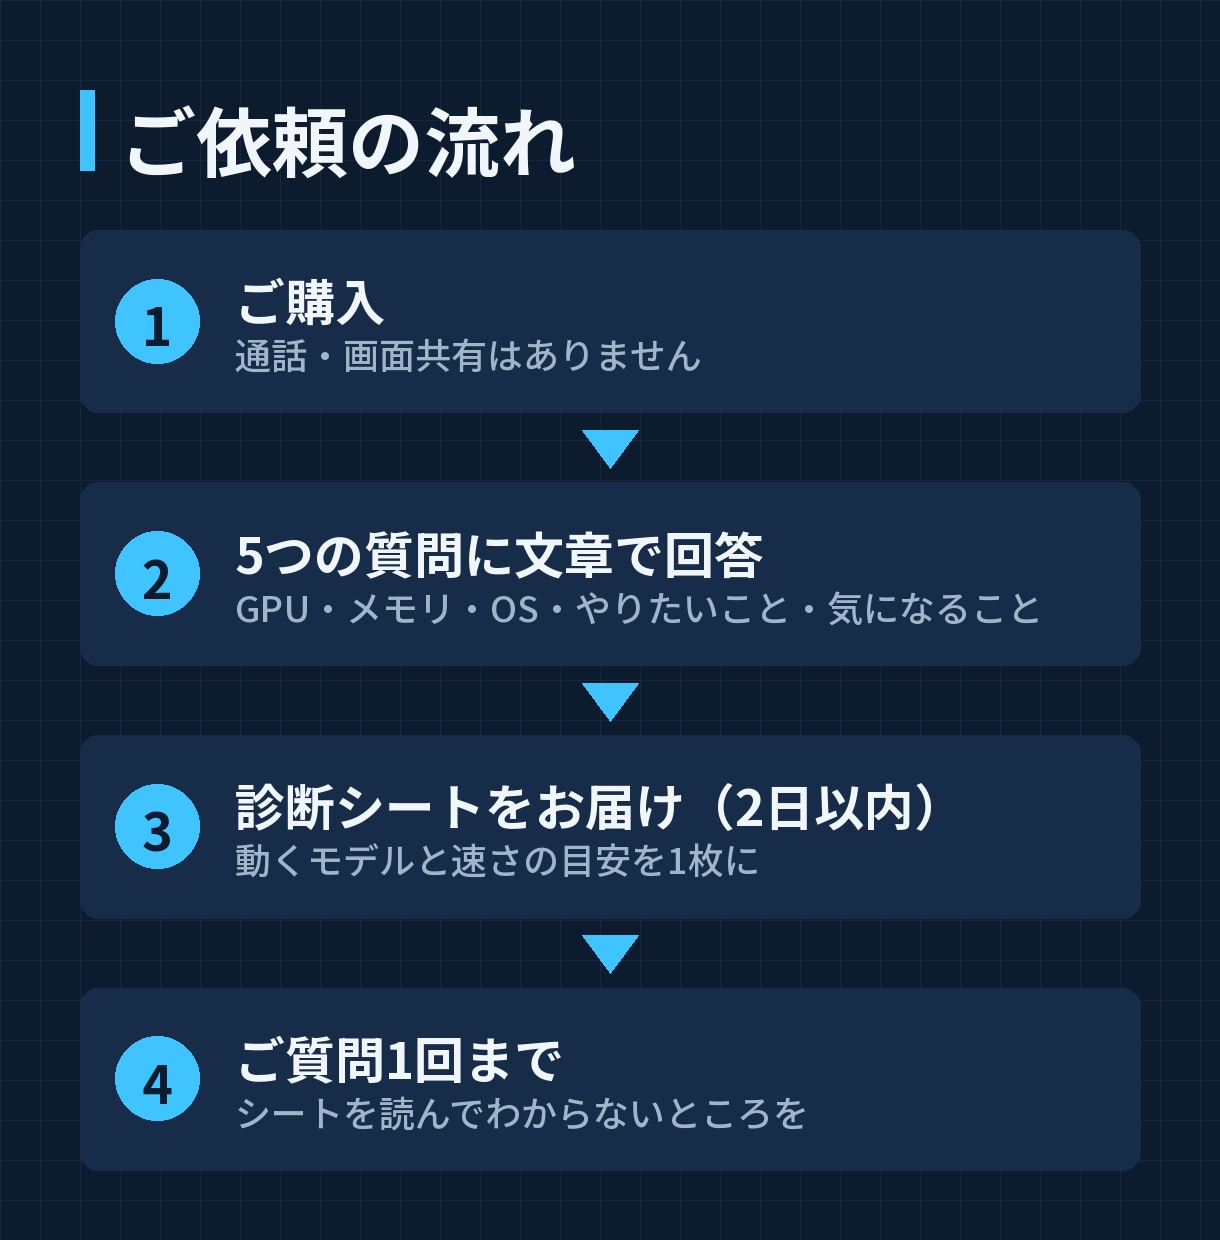
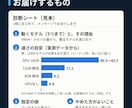
そんな方に、お使いのPC(または買う予定のPC)で動くAIモデルと、速さの目安を、実測データをもとに1枚の「診断シート」にまとめてお送りします。通話はありません。メッセージで5つの質問にお答えいただくだけです。
━━━━━━━━━━━━━━━━
■ お届けするもの
━━━━━━━━━━━━━━━━
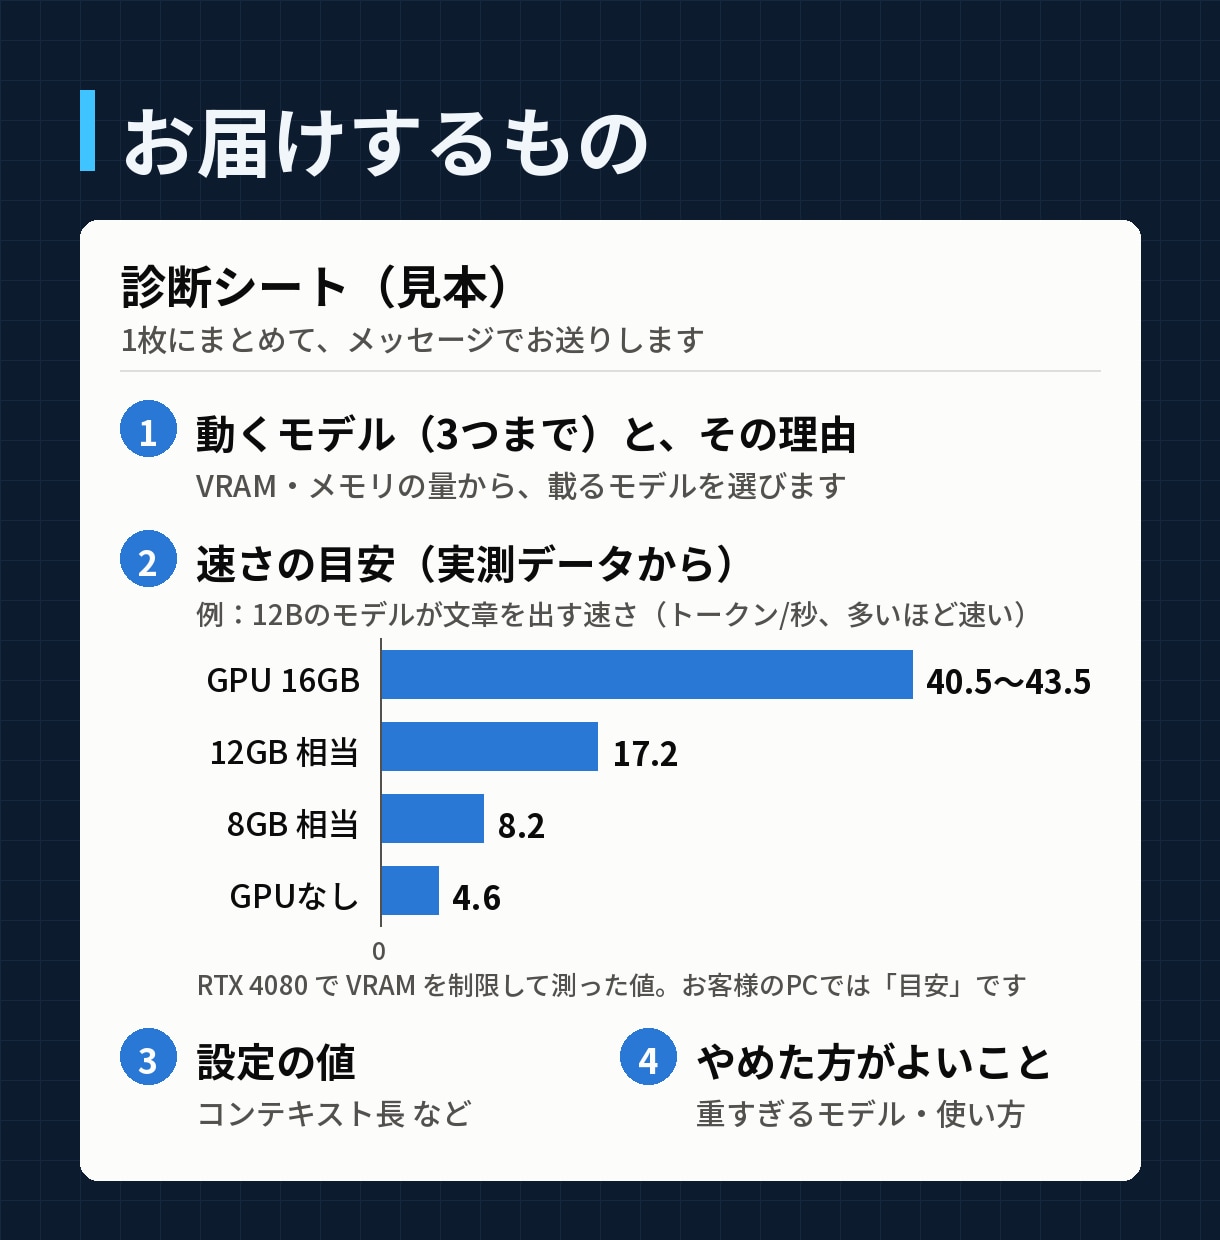
1. おすすめのモデル(3つまで)と、その理由
2. 速さの目安(実測データからの見積もり)
3. Ollama(無料のAI実行ソフト)の入れ方の要点と、設定の値(コンテキスト長など)
4. そのPCでは「やめた方がよい」モデル・使い方
5. 診断シートへのご質問1回
━━━━━━━━━━━━━━━━
■ 実測データについて
━━━━━━━━━━━━━━━━
自宅の RTX 4080(16GB)で、AIモデルの速さを測って記録しています。
GPUのメモリ(VRAM)を 12GB・8GB 相当に制限した測定や、GPUを使わない測定もしています。
(例:12Bのモデルで、文章を出す速さ)
・GPUにすべて載る(16GB):約40〜44 トークン/秒
・12GB相当:約17 トークン/秒
・8GB相当:約8 トークン/秒
・GPUなし(CPU 8コア):約5 トークン/秒
お客様のGPUで実際に測るのではなく、この記録から見積もる「目安」です。
━━━━━━━━━━━━━━━━
■ こんな方におすすめ
━━━━━━━━━━━━━━━━
・ゲーミングPC(NVIDIA製GPU)で、ローカルAIを試してみたい
・会社のルールでクラウドのAIが使えず、手元で動かす方法を探している
・GPUやPCを買う前に、どれくらい動くかを知りたい
━━━━━━━━━━━━━━━━
■ 正直にお伝えしたいこと
━━━━━━━━━━━━━━━━
・速さは「目安」です。同じGPUでも、ドライバーや設定、ほかに動いているソフトで変わります
・ローカルのAIは、クラウドの最上位のAIより賢さでは劣ります
・導入の作業そのもの(お客様のPCへのインストール)は含みません。手順書つきの導入サポートは別のサービスでお受けしています
・診断に使うのは、GPU・メモリ・OSなどの「PCの情報」と「やりたいこと」だけです。ソースコードや社内の資料は送らないでください
・測定データは NVIDIA製GPU(RTX 4080)のものです。AMD製GPU・Mac は、目安の確かさが下がります(購入前にご相談ください)
・お客様のPCを遠隔で操作すること、通話や画面共有は行っていません。やり取りはすべてメッセージで行います
・副業のため、平日は夜、土日は日中の対応です。メッセージには24時間以内にお返事します