※【ケーススタディと設計原則に関する注記】
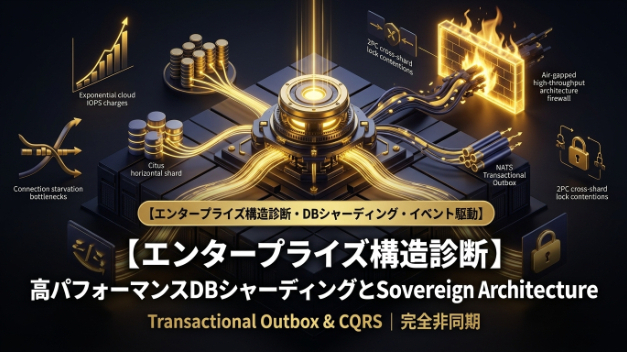
本記事で解説する高パフォーマンス・データベースシャーディングおよびイベント駆動型ファブリック構造は、執筆時点(As of 2026)における高度分散データ基盤標準(Vitess, Citus, Transactional Outbox Pattern, Debezium CDC, ZFS/XFS NVMe Tuning, Patroni Raft Consensus)に基づいた高度なシステム設計モデルです。クラウドマネージド・リレーショナルデータベースが直面する「IOPSコストの急激な肥大化」と「分散ロック競合」を徹底的に解剖し、ベアメタルNVMeインフラストラクチャ上でサブミリ秒のライト処理と無限のスケーラビリティを達成する主権的データアーキテクチャをファーストプリンシプルの観点から分解したエグゼクティブ・モデルです。
---
※【著者前書き:序論|マネージド・データベースのスケーラビリティの罠】
モダンなエンタープライズシステムがトランザクションボリューム、リアルタイムデータ取り込み、およびユーザーコンカレンシーをスケールさせるにつれ、クラウドマネージド・リレーショナルデータベース(AWS Aurora、GCP Cloud Spanner、Azure Cosmos DB等)への依存は深刻な運用上の制約を導入する。初期においては非常に便利である一方で、プロプライエタリなマネージドデータベースは3つの構造的負債を生み出す:高IOPS負荷下での指数関数的な請求額の増大、硬直したスケーリングの天井、およびプロプライエタリなクエリ方言やレプリケーションプロトコルを介した深いベンダーロックインである。
毎秒数万件の書き込みクエリを処理する高コンカレンシーなエンタープライズワークロードにおいて、標準的なクラウドインスタンスに依存することは高額なボトルネックを生み出す。真のデータベース主権は、ベアメタルNVMeインフラストラクチャ上で稼働する非同期イベント駆動型メッセージファブリックと直接統合された、高パフォーマンスでセルフホスト型の分散データベースシャーディングをデプロイすることにより、ハイパースケーラーのストレージトラップから脱出することを要求する。
---
※【第1章:柱 1|水平データベースシャーディング、接続マルチプレクシング、およびシャードキーの物理学】
単一の物理ノードの限界を超えてデータベースエンジンをスケールさせるには、垂直スケーリング(スケールアップ)を放棄し、水平シャーディングと厳格な接続管理を採用することが要求される:
■ 1. 接続枯渇の物理学とプロキシアーキテクチャ:
PostgreSQLのようなリレーショナルエンジンは、クライアント接続ごとに専用のOSプロセスを割り当て、アイドル接続1つあたり2 MB〜10 MBのRAMを消費する。2,000の同時直接接続を受信するバックエンドは、接続オーバーヘッドだけで10 GB〜20 GBのRAMを消費し、深刻なCPUコンテキストスイッチとメモリ枯渇を引き起こす。
・ 接続マルチプレクシング(PgBouncer / ProxySQL):トランザクションプーリングモードで高パフォーマンス接続プロキシをデプロイすることにより、数千の着信アプリケーション接続を、バックエンドデータベースワーカースレッドの緊密で安定したプール(物理ソケットあたり50〜100のアクティブ接続等)へと集約し、接続枯渇のスパイクを完全排除する。
■ 2. 透過的水平シャーディング(Vitess & Citus):
・ MySQL向けVitess:大規模データベースワークロードをスケールさせるために設計されたVitessは、SQLクエリをインターセプトし、適切なデータベースシャードへトランザクションを自動ルーティングし、アプリケーションのダウンタイムゼロでグローバルスキーマ変更を管理する分散データベースプロキシ層として機能する。
・ PostgreSQL向けCitus:複数のワーカーノード全体でテーブルを水平にシャーディングすることにより、標準のPostgreSQLを分散リレーショナルデータベースへと変貌させ、分散結合、並列クエリ実行、およびマッシブな書き込みスループットのスケーリングを有効にする。
■ 3. シャードキー選定とTwo-Phase Commit(2PC)オーバーヘッドの排除:
シャーディングにおける一般的なエンジニアリングの失敗モードは、複数の物理シャードにまたがるクエリを実行してしまうことである。クロスシャードクエリはルーティングレイヤーに対してTwo-Phase Commit(2PC)プロトコルの実行を強制し、マルチホップのネットワークラウンドトリップとロック競合を発生させる。エンタープライズ・アーキテクトは、読み取りおよび書き込みクエリの99%が単一の物理シャードノード内で完全に完了するよう、カーディナリティの高いシャードキー(tenant_idやorganization_id等)を慎重に選定しなければならない。
---
※【第2章:柱 2|非同期イベント駆動アーキテクチャ & 書き込みの分離(Decoupling)】
イベント駆動アーキテクチャ(EDA)をデータベースシャーディングと統合することは、同期的なクロスシャードトランザクションを非同期イベントストリームへシフトさせることにより、分散ロックのボトルネックを排除する:
■ 1. Transactional Outbox Pattern(トランザクショナル・アウトボックス・パターン):
複数の物理シャードにまたがる複雑な同期トランザクションを実行する代わりに、アプリケーションはプライマリシャード上のローカルOutboxテーブルに対して単一のアトミックなイベントペイロードを書き込む。
・ 保証されたアトミシティ(原子性):ビジネス状態の変更とイベントレコードは全く同じローカルデータベーストランザクション内でコミットされ、重いTwo-Phase Commit(2PC)ロックを使用することなく、データ不整合ゼロを保証する。
■ 2. イベントログ・ストリーミング(Change Data Capture - CDC):
非同期のChange Data Capture(CDC)エンジン(DebeziumやネイティブWALストリーミング等)は、データベースの先行書き込みログ(WAL)を継続的に読み取り、ベアメタル上で稼働する高スループットなイベントメッセージブローカー(Apache KafkaやNATS JetStream等)へ直接イベントを発行する。
■ 3. イベントストリームキーによるシャードパーティショニング:
KafkaやNATSのようなイベントブローカーにおいて、メッセージにはパーティションキー(account_idやtenant_id等)が割り当てられる。イベントパーティションキーがデータベースシャードキーと一致することを保証することにより、特定エンティティに関するすべてのイベントは、専用のデータベースシャード・コンシューマーによって正確な順序でシーケンシャルに処理されることが保証される。
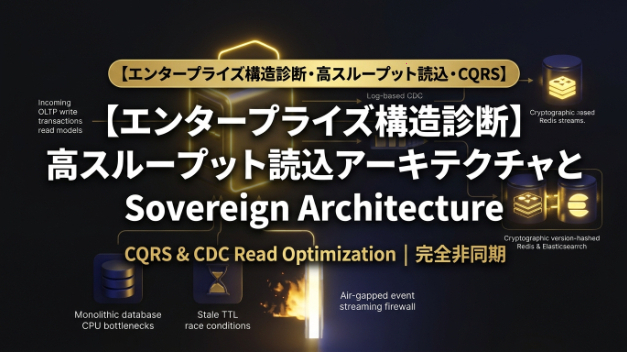
■ 4. ノンブロッキング読取/書込分離(CQRS):
・ コマンドパス(書き込み):インプレスAPIエンドポイントはコマンドイベントを高速イベントファブリックへプッシュし、即座に202 Acceptedステータスをクライアントへ返却することで、サブミリ秒のAPIレイテンシを実現する。
・ クエリパス(読み取り):専用のコンシューマーワーカーがイベントストリームから読み取り、最適化された読み取り専用データベースシャードや検索インデックスへ状態を継続的に投影(プロジェクション)する。
---
※【第3章:柱 3|LinuxカーネルI/O、ファイルシステム、およびストレージエンジンの最適化】
ベアメタル・データベースノード上で最大トランザクション/秒(TPS)のパフォーマンスを達成するには、下層のオペレーティングシステムカーネル、ストレージファイルシステム、およびストレージエンジンパラメータの微調整が要求される:
■ 1. LinuxカーネルI/Oとスケジューラーのチューニング:
・ I/Oスケジューラー構成:低レイテンシなNVMe SSD用に最適化された高パフォーマンス・マルチキューアルゴリズム(mq-deadlineまたはnone)を利用するようLinuxブロック層I/Oスケジューラーを構成し、レガシーな機械的ハードドライブのキューイング遅延をバイパスする。
・ 仮想メモリとSwappiness:アクティブなデータベース共有バッファがスワップ空間へアグレッシブにページアウトされるのを防ぎ、一貫したトランザクションレイテンシを保証するため、カーネルメモリパラメータ(vm.swappiness = 1 および vm.dirty_background_ratio = 5)を調整する。
■ 2. ファイルシステム選定とZFSチューニング:
・ リレーショナルワークロードにおけるXFS vs. ZFS:データベースのブロックサイズに合致する最適なレコードサイズ(PostgreSQLは8KB、InnoDB/MySQLは16KB)で構成された高パフォーマンス・ジャーナリングファイルシステム(XFS)または高度ストレージプール(ZFS)をデプロイする。ハイエンドNVMeメディア上での書き込み合体(Write-Coalescing)と専用のZFS Intent Log(ZIL)デバイスの活用は、突然の電源喪失時にもデータ破損リスクなしで、先行書き込みログ(WAL)を高速化する。
---
※【第4章:柱 4|ノンブロッキング・スキーママイグレーション、高利用可能性、およびイベントリプレイ】
分散型イベント駆動ストレージファブリックの運用は、ダウンタイムゼロのメンテナンス手続きと、決定論的障害復旧メカニズムを要求する:
■ 1. Zero-Downtime オンライン・スキーママイグレーション:
マルチテラバイトのプロダクション・データベースシャード上でALTER TABLE文を実行することは、テーブルアクセスをロックし、アプリケーションの障害を引き起こす。主権的アーキテクチャはオンライン・スキーママイグレーションエンジン(MySQL向けのgh-ost、PostgreSQL向けのpg_repackや宣言型マイグレーションツール等)を利用する。これらのツールはシャドウテーブルを作成し、リアルタイムのバイナリログ変更をストリーミングし、ライブのアプリケーション書き込みトラフィックをブロックすることなく、ほぼ瞬時のテーブルスワップを実行する。
■ 2. 決定論的状態リプレイと冪等性(Idempotency):
仮にデータベースシャードが破壊的なディスク障害や破損に見舞われた場合であっても、復旧は重いデータベーススナップショットのリストアのみに依存しない。SREはオフセットゼロから最新のタイムスタンプまでの不変イベントストリームを単にリプレイするだけで、新品の空のデータベースシャードを再構築(リハイドレート)できる。専用のコンシューマーワーカーは、フェイルオーバー中の重複イベント処理が正確な状態整合性を生成することを保証するため、決定論的イベントIDを使用した「冪等な実行」を実装する。
■ 3. 自動フェイルオーバーとクラスターコンセンサス:
予期せぬノード障害時にも目標復旧ポイントゼロ(RPO = 0)を保証するため、ローカルアベイラビリティゾーン全体で分散コンセンサスプロトコル(PostgreSQL向けのPatroniを介したRaftやPaxos等)をデプロイする。自動化されたコンセンサスエージェントがノードのネットワーク分断を検知し、数秒以内に新しいプライマリを選出し、手動介入なしでルーティングプロキシをシームレスに更新する。
---
※【エピローグ:妥協なきパフォーマンスとデータ主権】
マネージドクラウドデータベースの天井から脱出することは、エンタープライズのデータインフラストラクチャを予測不能な営業費用から、高パフォーマンスで予測可能なアセットへと変貌させる。
接続マルチプレクシングプロキシ、水平シャーディング、非同期イベントアウトボックス・ストリーミング、LinuxカーネルI/Oチューニング、およびノンブロッキング・スキーママイグレーションパイプラインをベアメタルハードウェア上で組み合わせることにより、エンジニアリングチームは無限のスケーラビリティ、サブミリ秒の書き込み処理、およびコアストレージアセットに対する完全な指揮権を達成するのである。
---
※【無料見積もり・相談】
我々のオフィスは、完全非同期・テキストファーストの技術アドバイザリーとして排他的に運用されています。
高パフォーマンス・データベースシャーディング、Transactional Outboxパターンの構築、CQRSイベントファブリックの設計、あるいは会議の摩擦や企業のオーバーヘッドのないデータ基盤ガバナンスの構造的レビューをご希望の企業様に対し、最高密度の診断レポートをお届けします:
■ 貴社の技術的アーキテクチャの評価、または非公開のカスタムスコープ設定をご希望の場合は、プロフィール上のアプリ内「見積もり・カスタマイズ相談」ボタンよりお気軽にお問い合わせください。