※【ケーススタディと設計原則に関する注記】
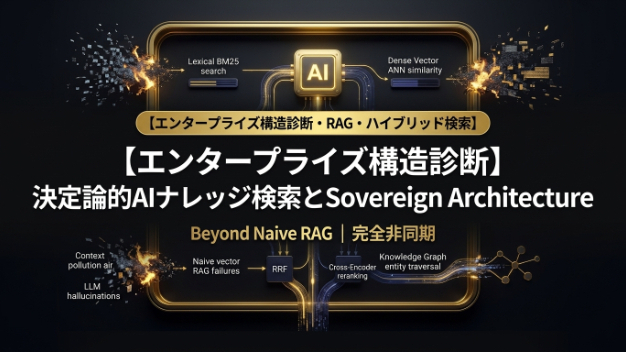
本記事で解説するエンタープライズAIナレッジ検索およびハイブリッドRAG(Retrieval-Augmented Generation)構造は、執筆時点(As of 2026)における高度AI検索標準(Okapi BM25, ANN Dense Vector Search, Knowledge Graph Traversal, Reciprocal Rank Fusion, Cross-Encoder Reranking)に基づいた高度なシステム設計モデルです。単なるベクトル類似度検索(Naive RAG)がもたらす「文脈汚染(Context Pollution)」と「ハルシネーション」を物理的に排除し、確実な英数字マッチング、意図理解、およびエンティティ関係のトラバーサルを単一の主権的パイプラインとして統合したエグゼクティブ・グランドモデルです。
---
※【著者前書き:序論|エンタープライズにおける単純RAGの破綻】
エンタープライズ組織がAIイニシアチブを単純な会話型エージェントからクリティカルな意思決定支援システムへとスケールさせるにつれ、第1世代の検索拡張生成(RAG)アーキテクチャに深刻な構造的欠陥が浮き彫りとなる。
標準的な検索システムは、ほぼ排他的に「単純なベクトル検索(Naive Vector Search)」に依存している。——テキストパッセージを高次元エンベディングへ変換し、コサイン距離を介して意味的類似度を計測する手法である。このアプローチは広範で一般的なクエリに対しては合理的に機能するものの、エンタープライズのドメインデータに露出した瞬間に完全な破綻を迎える。
リスクの高い企業環境において、情報へのアクセスは「絶対的な精密さ(Absolute Precision)」を要求する。単純なベクトル検索は、正確な英数字識別子、部品番号、規制の参照番号、または法的な条項を捉えることに日常的に失敗する。さらに、孤立したベクトルチャンクは構造的な関係性の認識を欠いており、システム境界を越えたクリティカルなマルチホップ依存関係を見落とした断片的なパッセージしか返却できない。
意味的ベクトル参照のみに頼ることは、ノイズ、文脈汚染、そしてLLMのハルシネーションを自ら導入することと同義である。真の主権的アーキテクチャは、決定論的ナレッジ検索——レキシカル(語彙)マッチング、高密度ベクトル距離、および構造的グラフ・トラバーサルを単一の高密度コンテキストパイプラインへと統合する「Tri-Hybrid(3重ハイブリッド)エンジン」へのシフトを要求する。
---
※【第1章:柱 1|Tri-Hybrid(3重ハイブリッド)検索エンジン】
難攻不落の検索精度を達成するため、エンタープライズシステムはコンテキストが言語モデル用に組み立てられる前に、ドメインデータ全体にわたって3つの明確かつ並行した検索プリミティブを実行しなければならない:
■ 1. レキシカル(語彙)検索(正確なコードおよび用語マッチング):
正確な英数字、固有名詞、および構造的識別子に対して、検索エンジンはOkapi BM25スコアリングアルゴリズムによってガバナンスされたフルテキスト・レキシカルインデックスを利用する。単語出現頻度(TF)、逆文脈頻度(IDF)、およびドキュメント長正規化パラメータを評価することにより、レキシカルエンジンは製品SKU、エラーコード、または顧客識別子などの正確なクエリートークンが、意味的エンベディングの接近度に関わらず捕捉されることを保証する。
■ 2. 密ベクトル検索(意味的および概念的マッチング):
自然言語の意図と概念的等価性を捕捉するため、システムは高次元ベクトル空間上で近似最近傍(ANN)アルゴリズムを使用して並列密ベクトル検索を実行する。このストリームは下層の意味的意味に基づいてパッセージを検索し、代替の言い回しや類義語を使用したクエリであっても関連するドメインコンテキストを浮上させることを保証する。
■ 3. 構造的グラフ検索(関係的エンティティ・トラバーサル):
ドキュメント境界を超えて構造的関係性を保持するため、システムはエンタープライズ・ナレッジグラフ上でグラフベースのトラバーサルアルゴリズムを実行する。ユーザークエリから固有表現を抽出し、境界設定されたステップ上限まで主語-述語-目的語の関係性をトラバースすることにより、グラフストリームは孤立したテキストパッセージでは伝達できない相互接続された依存関係——特定のソフトウェアサービスが下流のデータベースコンポーネントとどのように相互作用するか等——を検索する。
---
※【第2章:柱 2|動的ランクフュージョン & 決定論的リランキング】
各インデックスが互換性のないスケール尺度で動作するため、レキシカル検索、ベクトル類似度、およびグラフ・トラバーサルの生のスコアを単純なスコア加算で結合することはできない。パイプラインは2段階の決定論的フュージョンおよびリランキングプロセスを実行する:
■ 1. ステージ 1: Reciprocal Rank Fusion(RRF):
複雑で脆い重み調整なしに3つの検索ストリームを統合するため、エンジンはReciprocal Rank Fusion(RRF)を適用する。このアルゴリズムは生のスコア尺度を完全に破棄し、各個別ストリーム内の候補チャンクの「相対的順位位置」のみで動作する。標準化された平滑化定数を使用して相互順位スコアを計算することにより、フュージョンエンジンはレキシカル、ベクトル、およびグラフの出力を、トップの候補パッセージを含む単一の標準化された候補プールへとマージする。
■ 2. ステージ 2: ディープ・クロスエンコーダー・リランキング:
フュージョンによって生成された候補プールは、専門のクロスエンコーダー・リランキングモデルへ提出される。クエリとドキュメントを個別に処理する高速なベクトル・バイエンコーダーとは異なり、クロスエンコーダーはディープ・クロスアテンションレイヤーを通じてクエリと各候補チャンクの完全結合ペイロードを処理する。これにより、真の意味的適合性を反映した正確で高度に洗練された関連性スコアが生成される。候補プールは再ソートされ、最高スコアのパッセージのみが保持される。
■ 3. ステージ 3: コンテキスト密度圧縮:
検索されたデータを言語モデルのプロンプトへ注入する前に、トップパッセージはコンテキスト密度コンプレッサーを通過する。このステージは、隣接するパッセージ間の重複する文断片をストリップし、グラフ関係を明示的な構造的キーバリューブロックへ変換し、厳格なトークン予算を強制する。最小限で高度にフォーカスされたコンテキストペイロードを供給することは、コンテキストの希釈を完全に排除し、トークンコストを最適化し、モデルのハルシネーションを防止する。
---
※【第3章:柱 3|分離された主権的アダプター契約】
下層のデータベース・ロックインを防ぎ、エンタープライズ検索システムが個々のベンダープラットフォームよりも長生きすることを保証するため、アーキテクチャは3つの運用レイヤーにわたって厳格なヘキサゴナル・アダプター境界を強制する:
■ 1. プライマリ・ドメインレイヤー:
コアのビジネスロジックはクエリのパース、フュージョンのオーケストレーション、およびコンテキストの組み立てを管理し、下層のデータベースソフトウェアやクラウドSDKから完全に隔離され続ける。
■ 2. 抽象アウトバウンドポート・インターフェース:
ドメインレイヤーは、レキシカル検索、ベクトル距離参照、およびグラフ・トラバーサルの明示的な振る舞いを定義する抽象ポート契約を通じてのみデータベースインフラストラクチャと対話する。
■ 3. 具象データベース・アダプター:
インフラストラクチャ固有のアダプターは、抽象ドメインリクエストを具象データベースクエリ実行へと変換する。ベクトルデータベースの交換、フルテキスト検索エンジンの変更、またはグラフストレージの修正は、ターゲットとなるインフラストラクチャ・アダプターの更新のみを要求する。コアのドメインロジック、フュージョンアルゴリズム、およびリランキングパイプラインは完全に無修正のまま維持される。
---
※【結語:エンタープライズAIの基盤としての精密なコンテキスト】
信頼性の高いAI出力を生成することは、本質的にモデルサイズの問題ではない。——それは**「コンテキスト精度の問題」**である。
単純なベクトル参照を決定論的なTri-Hybrid検索パイプラインへと置き換え、最小ノイズのコンテキスト圧縮を強制することにより、エンタープライズ・アーキテクトはモデルハルシネーションの主要原因を排除する。主権的アーキテクチャ内へ決定論的検索インターフェースを組み込むことは、企業のステークホルダーに対して自動化意思決定システムへの絶対的な確信を与えるのである。
---
※【無料見積もり・相談】
我々のオフィスは、完全非同期・テキストファーストの技術アドバイザリーとして排他的に運用されています。
決定論的AIナレッジ検索、Tri-Hybrid(BM25 + Vector + Graph)エンジンの構築、RRF / Cross-Encoderリランキングの最適化、あるいは会議の摩擦や企業のオーバーヘッドのないAIデータガバナンスの構造的レビューをご希望の企業様に対し、最高密度の診断レポートをお届けします:
■ 貴社の技術的アーキテクチャの評価、または非公開のカスタムスコープ設定をご希望の場合は、プロフィール上のアプリ内「見積もり・カスタマイズ相談」ボタンよりお気軽にお問い合わせください。